16Hệ thống gợi ý#
Chương cuối của giáo trình là một ứng dụng dùng lại gần như mọi công cụ đã học. Hệ thống gợi ý dự đoán mức độ một người dùng thích một sản phẩm, bộ phim hay bài hát mà họ chưa đánh giá. Phương pháp chính, phân rã ma trận, cần tới hạng của ma trận và SVD ở Chương 2, hồi quy ridge ở Chương 9, và đánh đổi độ chệch – phương sai xuyên suốt giáo trình. Các thí nghiệm của chương tập trung vào một câu hỏi thực tế mà sách thường bỏ qua: cần bao nhiêu dữ liệu thì phương pháp mới bắt đầu có ích, và điều gì xảy ra với người dùng chưa có dữ liệu nào. Trước các thí nghiệm, một ma trận ba người dùng, ba bộ phim đủ nhỏ để tính tay sẽ cho thấy cơ chế của từng bước.
16.1Bài toán gợi ý#
Dữ liệu được tổ chức thành ma trận đánh giá , với người dùng và sản phẩm; ô là đánh giá của người dùng cho sản phẩm . Phần lớn các ô bị trống, vì mỗi người chỉ đánh giá một phần rất nhỏ trong số sản phẩm. Bài toán là dự đoán giá trị của các ô trống.
Có hai hướng tiếp cận chính. Lọc dựa trên nội dung (content-based filtering) mô tả mỗi sản phẩm bằng các đặc trưng như thể loại, đạo diễn, từ khoá, rồi học sở thích của từng người theo các đặc trưng đó; về bản chất, đây là một bài hồi quy riêng cho mỗi người dùng. Lọc cộng tác (collaborative filtering) không cần đặc trưng của sản phẩm mà chỉ dùng mẫu hình đánh giá của mọi người dùng, với ý tưởng rằng những người đánh giá giống nhau trong quá khứ sẽ tiếp tục đánh giá giống nhau.
Dữ liệu đánh giá cũng có hai dạng. Phản hồi tường minh (explicit feedback) là điểm số người dùng chủ động cho, như số sao. Phản hồi ngầm (implicit feedback) là hành vi như lượt xem, lượt nhấp, thời gian nghe; dạng này nhiều hơn hẳn nhưng khó diễn giải, vì không xem một sản phẩm không có nghĩa là không thích nó. Chương này dùng phản hồi tường minh.
16.2Phân rã ma trận#
Định nghĩa 16.1 (Phân rã ma trận)
Phương pháp phân rã ma trận (matrix factorization) giả định ma trận đánh giá xấp xỉ được bằng một ma trận hạng thấp:
Mỗi người dùng được biểu diễn bằng vector (hàng thứ của ), mỗi sản phẩm bằng vector , và đánh giá dự đoán là .
Các toạ độ của và gọi là nhân tố ẩn (latent factors). Không ai định nghĩa chúng trước; chúng hình thành từ dữ liệu. Với phim ảnh, một nhân tố có thể tương ứng với mức độ "hành động" của phim và mức độ người dùng thích phim hành động, và tích vô hướng lớn khi sở thích của người dùng khớp với đặc điểm của phim. Cách hiểu này chỉ mang tính minh hoạ: các nhân tố học được thường không có nghĩa rõ ràng như vậy.
Ví dụ nhỏ nhất là hạng 1. Ba người dùng Lan, Minh, Hùng chấm ba phim A, B, C trên thang 1 tới 5. Trừ đi 3, mức giữa thang, để điểm dương là thích và điểm âm là không thích:
| Phim A | Phim B | Phim C | |
|---|---|---|---|
| Lan | 2 | 2 | −2 |
| Minh | 1 | ? | −1 |
| Hùng | −1 | −1 | 1 |
Các ô đã biết khớp đúng với tích , với cho ba người và cho ba phim. Có thể đọc là mức "hành động" của phim, A và B là phim hành động còn C thì không, và là mức thích phim hành động: Lan thích nhiều, Minh thích vừa, Hùng không thích. Mô hình hạng 1 điền ô trống bằng , tức dự đoán Minh chấm phim B 4 sao.
Chỉ các ô đã quan sát, ký hiệu là tập , được dùng để học. Hàm mất mát là bình phương sai số trên các ô đó cộng regularization:
Hàm này không lồi theo đồng thời, vì có tích . Nhưng khi cố định , nó tách thành bài toán độc lập theo từng , và mỗi bài toán là một hồi quy ridge (Mục 9.2):
trong đó gồm các hàng của ứng với sản phẩm người dùng đã đánh giá, và là các đánh giá tương ứng. Tương tự khi cố định để giải . Thuật toán luân phiên hai bước này gọi là bình phương tối thiểu luân phiên (alternating least squares, ALS), và mỗi bước không làm tăng hàm mất mát. Với ví dụ ở trên và đã biết, Minh đánh giá phim A và C, nên và . Công thức cho , bằng 0,952 với , và dự đoán cho phim B là điểm trên mức giữa, tức khoảng 3,95 sao: regularization kéo dự đoán về phía mức giữa thang một chút. Một lựa chọn khác là SGD trên từng ô quan sát. Các hệ thống thực tế thường thêm hệ số chặn riêng cho người dùng và cho sản phẩm, , để mô tả việc có người chấm điểm rộng tay hơn và có sản phẩm được ưa chuộng hơn mặt bằng chung (Koren, Bell và Volinsky, 2009).
Giả thiết hạng thấp là điều làm bài toán có nghĩa. Thí nghiệm của chương dùng 300 người dùng và 200 sản phẩm: ma trận có 60 000 ô, còn mô hình hạng 4 chỉ có tham số, bằng 3,3% số ô. Không có giả thiết như vậy, giá trị của một ô chưa quan sát không liên quan gì tới các ô đã quan sát, và không thể dự đoán.
16.3Lượng dữ liệu cần thiết#
Thí nghiệm sinh một ma trận đánh giá hạng 4 thật, cộng nhiễu có độ lệch chuẩn 0,4, rồi che đi phần lớn các ô và giữ lại một tỉ lệ ngẫu nhiên. Mô hình được huấn luyện bằng ALS với và đánh giá bằng RMSE trên các ô bị che.
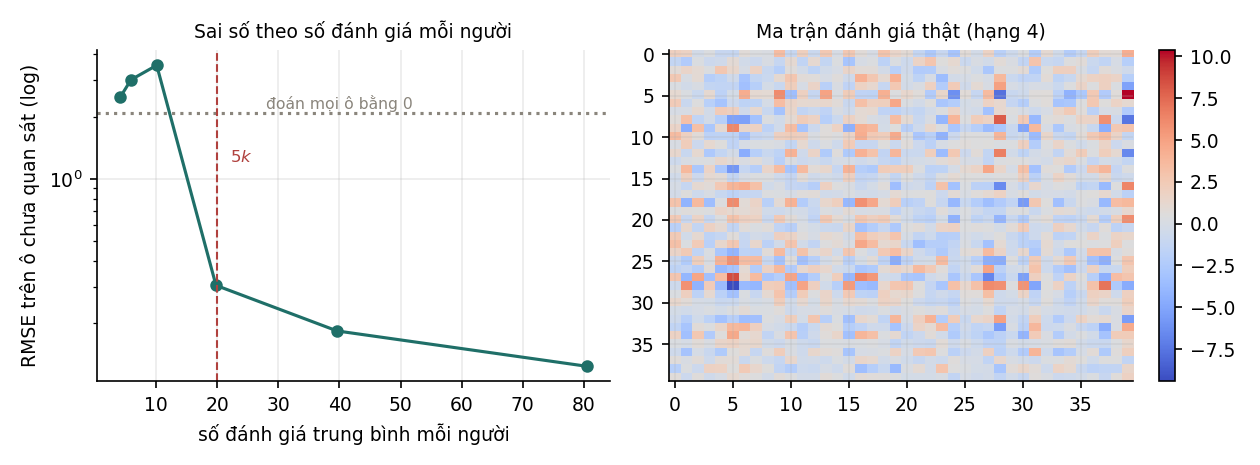
| Tỉ lệ ô quan sát | Đánh giá mỗi người | RMSE trên ô chưa quan sát | Tỉ số với mức đoán bằng 0 |
|---|---|---|---|
| 2% | 4,1 | 2,4759 | 1,19 |
| 3% | 5,9 | 3,0167 | 1,45 |
| 5% | 10,1 | 3,5444 | 1,71 |
| 10% | 19,8 | 0,3048 | 0,15 |
| 20% | 39,6 | 0,1834 | 0,09 |
| 40% | 80,5 | 0,1237 | 0,06 |
Cột cuối là tỉ số giữa RMSE của mô hình và độ lệch chuẩn của ma trận thật (2,0772), tức sai số của cách đoán mọi ô bằng 0. Tỉ số lớn hơn 1 nghĩa là mô hình còn tệ hơn cách đoán đơn giản đó.
Ba dòng đầu có tỉ số lớn hơn 1: với khoảng 10 đánh giá mỗi người trở xuống, phân rã ma trận cho sai số lớn hơn cả cách đoán mọi ô bằng 0. Giữa 10,1 và 19,8 đánh giá mỗi người, RMSE giảm từ 3,54 xuống 0,30, hơn 11 lần. Sau ngưỡng đó, thêm dữ liệu chỉ cải thiện từ từ.
Có thể hiểu ngưỡng này bằng cách đếm ẩn số. Mỗi người dùng có ẩn số trong , nên cần ít nhất 4 đánh giá để xác định chúng, kể cả khi đã biết chính xác. Nhưng các đánh giá có nhiễu, và cũng đang được ước lượng từ chính dữ liệu thưa đó, nên số đánh giá cần thiết lớn hơn nhiều lần mức tối thiểu. Ví dụ hạng 1 cho thấy vì sao. Nếu Minh chỉ chấm phim A, một đánh giá là đủ cho một ẩn số: , vẫn đúng chiều. Nhưng nếu đánh giá duy nhất đó lệch đi 1 điểm vì nhiễu, Minh chấm A đúng 3 sao, thì và mô hình mất hết thông tin về Minh. Có thêm đánh giá phim C, cùng đánh giá lệch đó chỉ kéo xuống , vẫn đúng chiều. Trong thí nghiệm, ngưỡng nằm giữa 10 và 20 đánh giá mỗi người, tức khoảng 2,5 tới 5 lần hạng . Lý thuyết hoàn thiện ma trận (matrix completion) cho kết luận cùng chiều: dưới giả thiết vị trí các ô quan sát ngẫu nhiên, số quan sát cần thiết tăng tuyến tính theo hạng, nhân với một thừa số logarit của kích thước ma trận (Candès và Recht, 2009).
Con số cụ thể của thí nghiệm này phụ thuộc vào mức nhiễu, và cách chọn ô quan sát, nhưng kết luận định tính là chung: cần số đánh giá mỗi người dùng lớn hơn hạng nhiều lần thì phân rã ma trận mới có ích. Vì vậy các hệ thống thực tế dùng tương đối nhỏ, cỡ vài chục tới vài trăm, dù có hàng triệu người dùng: hạng càng lớn thì càng cần nhiều dữ liệu cho mỗi người.
16.4Chọn hạng #
Khi đã đủ dữ liệu, câu hỏi tiếp theo là chọn hạng . Bảng dưới đo ở mật độ quan sát 30%, nơi mô hình có đủ dữ liệu.
| Hạng | RMSE trên ô chưa quan sát | RMSE trên ô đã quan sát |
|---|---|---|
| 1 | 1,8073 | 1,7769 |
| 2 | 1,4764 | 1,4206 |
| 3 | 1,0569 | 1,0128 |
| 4 | 0,1448 | 0,3762 |
| 6 | 0,2217 | 0,3535 |
| 10 | 0,3501 | 0,3076 |
| 20 | 0,6291 | 0,1903 |
Hai cột có xu hướng ngược nhau. RMSE trên ô đã quan sát giảm đều khi tăng: mô hình nhiều tham số hơn khớp dữ liệu huấn luyện sát hơn, và ở nó đạt 0,1903, thấp hơn cả độ lệch chuẩn của nhiễu (0,4), tức mô hình đã bắt đầu khớp cả nhiễu. RMSE trên ô chưa quan sát đạt nhỏ nhất ở , đúng hạng thật, rồi tăng lại: ở nó bằng 0,6291, gấp 4,3 lần giá trị tại .
Đây là đánh đổi độ chệch – phương sai (Mục 3.6) dưới dạng chọn hạng: nhỏ hơn hạng thật gây underfitting, lớn hơn gây overfitting. Trên dữ liệu thật, hạng thật không biết trước, và được chọn bằng cách đo sai số trên một tập các ô được giữ lại để xác thực, giống cross-validation ở Mục 9.5.
16.5Vấn đề khởi đầu lạnh#
Một người dùng mới chưa đánh giá sản phẩm nào thì mô hình dự đoán gì cho họ? Thí nghiệm thêm 10 người dùng như vậy vào dữ liệu ở mật độ 30%:
RMSE cho nguoi dung cu   : 0.1459
RMSE cho nguoi dung moi  : 2.2364
RMSE neu doan bua bang 0 : 2.0772
||P|| trung binh, nguoi cu : 2.0841
||P|| trung binh, nguoi moi: 1.54e-01
Với người dùng mới, RMSE là 2,2364, còn tệ hơn đoán mọi đánh giá bằng 0 (2,0772). Hai dòng cuối giải thích cơ chế: vector của người dùng mới có chuẩn trung bình 0,154, so với 2,084 của người dùng cũ. Với người dùng không có ô quan sát nào, tổng bình phương sai số trong hàm mất mát ở Mục 16.2 không chứa số hạng nào liên quan tới , chỉ còn thành phần regularization , và giá trị cực tiểu của nó là . Chuẩn đo được khác 0 một chút vì trong thí nghiệm, các vector này chỉ nhận giá trị khởi tạo ngẫu nhiên nhỏ và không được cập nhật. Mô hình vì vậy dự đoán gần 0 cho mọi sản phẩm với người dùng mới. Trong ví dụ ba người dùng, một người thứ tư chưa chấm phim nào nhận và được đoán chấm mọi phim đúng 3 sao, mức giữa thang, dù người đó mê phim hành động như Lan hay ghét như Hùng.
Vấn đề này gọi là khởi đầu lạnh (cold start), và có ba dạng, mỗi dạng một cách xử lý thường dùng.
| Dạng khởi đầu lạnh | Cách xử lý thường dùng |
|---|---|
| Người dùng mới | hỏi vài sở thích khi đăng ký; dùng thông tin nhân khẩu học; gợi ý các sản phẩm phổ biến |
| Sản phẩm mới | dùng đặc trưng nội dung của sản phẩm (thể loại, mô tả, embedding của văn bản hoặc hình ảnh) |
| Hệ thống mới | bắt đầu bằng lọc dựa trên nội dung, chuyển dần sang lọc cộng tác khi đã có dữ liệu |
Vì vậy các hệ thống gợi ý thực tế hầu như luôn là hệ lai (hybrid): lọc cộng tác cho kết quả tốt hơn khi có đủ dữ liệu, còn lọc dựa trên nội dung bảo đảm luôn có câu trả lời khi chưa có dữ liệu.
Ngoài khởi đầu lạnh còn một vấn đề mà thí nghiệm tĩnh của chương không đo được: vòng phản hồi (feedback loop). Hệ thống chỉ gợi ý những sản phẩm nó dự đoán là tốt, nên chỉ thu được phản hồi về những sản phẩm đó, và dữ liệu huấn luyện của lần sau càng lệch về các sản phẩm đã được gợi ý. Mục 12.3 của MLOps mô phỏng hiện tượng này và cho thấy một hệ không có cơ chế thăm dò ngẫu nhiên chỉ quan sát được 9,5% danh mục sản phẩm.
16.6Tóm tắt#
Phân rã ma trận giả định ma trận đánh giá xấp xỉ được bằng tích hai ma trận hạng thấp, mỗi người dùng và mỗi sản phẩm là một vector nhân tố ẩn, và được huấn luyện bằng ALS, trong đó mỗi bước là một hồi quy ridge. Với ba người dùng và ba phim, giả thiết hạng 1 điền được ô trống, và bước ridge cho Minh , tức khoảng 3,95 sao cho phim B. Giả thiết hạng thấp là điều làm bài toán có nghĩa, nhưng nó chỉ có ích khi đủ dữ liệu: một đánh giá có nhiễu đủ làm mất hết thông tin về một người dùng hạng 1, và trong thí nghiệm, với khoảng 10 đánh giá mỗi người trở xuống, mô hình còn tệ hơn đoán mọi ô bằng 0; RMSE chỉ giảm mạnh khi số đánh giá vượt khoảng 2,5 tới 5 lần hạng. Hạng được chọn theo đánh đổi độ chệch – phương sai, và sai số trên ô chưa quan sát nhỏ nhất đúng ở hạng thật. Người dùng chưa có đánh giá nào nhận vector bằng 0 do regularization và được đoán ở mức giữa cho mọi sản phẩm, nên hệ thống thực tế luôn kết hợp lọc cộng tác với lọc dựa trên nội dung.
Nhìn lại cả giáo trình, mỗi thuật toán đã gặp đều quay về ba thành phần ở Chương 1: một họ hàm, một hàm mất mát và một cách tối ưu. Đại số tuyến tính cho biết bài toán có nghiệm hay không, xác suất cho biết hàm mất mát đến từ đâu, tính lồi cho biết tối ưu có tìm được nghiệm tốt nhất không, và đánh đổi độ chệch – phương sai cho biết mô hình có tổng quát hoá được không. Giáo trình Học sâu đi tiếp từ đây: chồng nhiều lớp hồi quy logistic thành mạng nơ-ron, và xét điều gì xảy ra khi bài toán không còn lồi. Chương 17 gồm các bài tập để luyện các phép tính của giáo trình, và Chương 18 gom các câu hỏi phỏng vấn thường gặp.
Tự kiểm tra
3 câu. Chọn đáp án để xem ngay lời giải thích.
1Phân rã ma trận cần bao nhiêu đánh giá mỗi người dùng?
Vì sao: Ở Mục 16.3, với 10,1 đánh giá mỗi người, RMSE là 3,54, tệ hơn đoán mọi ô bằng 0 (2,08); với 19,8 đánh giá mỗi người, RMSE giảm xuống 0,30.2Chọn hạng lớn hơn hạng thật thì điều gì xảy ra?
Vì sao: Ở Mục 16.4, RMSE trên ô chưa quan sát nhỏ nhất tại (0,1448) và tăng lên 0,6291 tại , trong khi RMSE trên ô đã quan sát giảm đều xuống 0,1903.3Vì sao phân rã ma trận không dự đoán được cho người dùng mới?
Vì sao: Ở Mục 16.5, chuẩn trung bình của vector người dùng mới là 0,154 so với 2,084 của người dùng cũ, và RMSE cho họ là 2,24, tệ hơn đoán mọi ô bằng 0 (2,08). Hệ thống thực tế cần kết hợp thêm lọc dựa trên nội dung.
Đã trả lời 0/3