Nền tảng học máy
Toàn bộ giáo trình trên một trang — tiện cho Ctrl+F, đọc ngoại tuyến hoặc in ra giấy.
Giáo trình 1 của lộ trình
Giáo trình mở đầu lộ trình bằng phần toán và các thuật toán học máy cổ điển mà mọi giáo trình phía sau đều dùng tới. Nội dung đi theo một mạch: nhắc lại đại số tuyến tính và xác suất ở mức cần dùng, học hồi quy và phân loại tuyến tính cùng cách tối ưu chúng, học cách đánh giá và chống overfitting, hiểu vì sao các hàm mất mát quen thuộc có dạng như vậy qua ước lượng hợp lý cực đại, rồi đi qua tối ưu lồi để tới SVM, và kết thúc bằng các phương pháp không giám sát: giảm chiều, phân cụm và hệ thống gợi ý.
Cách trình bày. Mỗi khái niệm đi theo một trình tự: bài toán cần giải, định nghĩa, suy luận, ví dụ tính tay, rồi thí nghiệm kiểm chứng bằng mã. Các định nghĩa, định lý và ví dụ quan trọng được đặt trong hộp riêng để dễ tra lại.
Về số liệu. Mọi con số trong giáo trình được sinh bởi hai script trong
code/nentang/với hạt giống cố định, nên chạy lại cho kết quả giống hệt. Một phần kết quả là kiểm chứng đẳng thức, chẳng hạn ridge trùng với ước lượng MAP khi tiên nghiệm là Gauss, và các kết quả đó khớp tới sai số của máy tính.
0Ký hiệu và quy ước#
Để đọc giáo trình này, người học cần biết đạo hàm của hàm một biến, phép nhân ma trận và đọc được mã Python dùng NumPy. Kiến thức đại số tuyến tính và xác suất ở mức cần thiết được nhắc lại trong Chương 2 và Chương 3, nên không đòi hỏi học trước.
0.1Bảng ký hiệu#
| Ký hiệu | Ý nghĩa |
|---|---|
| một điểm dữ liệu đầu vào có đặc trưng | |
| ma trận dữ liệu gồm điểm, mỗi điểm là một hàng | |
| , | nhãn thật và giá trị dự đoán của điểm thứ |
| , | vector trọng số và hệ số chặn của mô hình tuyến tính |
| ký hiệu chung cho mọi tham số của mô hình | |
| hàm mất mát | |
| tốc độ học (learning rate) | |
| hệ số regularization | |
| gradient của theo | |
| hàm hợp lý (Chương 10) hoặc hàm Lagrange (Chương 12, 13) | |
| ma trận hiệp phương sai | |
| , | trị riêng và vector riêng thứ |
| giá trị suy biến thứ trong phân tích SVD | |
| số điều kiện của ma trận | |
| nhân tử Lagrange ứng với ràng buộc thứ | |
| số lớp trong bài toán phân loại | |
| số cụm, số láng giềng hoặc số chiều giữ lại, tuỳ ngữ cảnh |
Chữ được dùng cho hai việc: hệ số regularization (Chương 9) và trị riêng (Chương 2, Chương 14). Hai cách dùng không xuất hiện trong cùng một công thức, trừ Mục 9.3 là nơi trị riêng được viết qua giá trị suy biến để tránh nhầm.
0.2Quy ước thuật ngữ#
Giáo trình dùng thuật ngữ theo cách phổ biến trong cộng đồng học máy tiếng Việt, có tham khảo bản dịch tiếng Việt các cheatsheet CS229 và CS230 của Đại học Stanford. Thuật ngữ nào đã có tên tiếng Việt thông dụng thì dùng tiếng Việt; thuật ngữ nào người làm nghề vẫn gọi bằng tiếng Anh thì giữ nguyên tiếng Anh.
| Tiếng Anh | Dùng trong giáo trình |
|---|---|
| supervised / unsupervised learning | học có giám sát / học không giám sát |
| regression / classification | hồi quy / phân loại |
| loss function | hàm mất mát |
| learning rate | tốc độ học |
| normal equations | phương trình chuẩn |
| training / validation / test set | tập huấn luyện / tập xác thực / tập kiểm tra |
| confusion matrix | ma trận nhầm lẫn |
| accuracy | độ chính xác (accuracy) |
| precision, recall, F1 score | precision, recall, điểm F1 |
| bias (của một ước lượng) | độ chệch |
| variance | phương sai |
| overfitting / underfitting | overfitting / underfitting |
| regularization | regularization |
| cross-validation | cross-validation |
| gradient descent, momentum, mini-batch | giữ nguyên tiếng Anh |
| likelihood | hàm hợp lý (likelihood) |
| prior / posterior | phân phối tiên nghiệm / phân phối hậu nghiệm |
| cross-entropy | cross-entropy |
| eigenvalue / eigenvector | trị riêng / vector riêng |
| singular value decomposition | phân tích giá trị suy biến (SVD) |
| support vector machine | máy vector hỗ trợ (SVM) |
| kernel, margin | kernel, lề |
| principal component analysis | phân tích thành phần chính (PCA) |
Chữ bias trong tiếng Anh có hai nghĩa khác nhau. Nghĩa thứ nhất là sai lệch có hệ thống của một ước lượng so với giá trị thật; giáo trình gọi là độ chệch, theo cách gọi "ước lượng không chệch" quen thuộc của thống kê. Nghĩa thứ hai là tham số cộng thêm trong ; giáo trình gọi là hệ số chặn. Bảng đối chiếu đầy đủ nằm ở trang Từ điển thuật ngữ.
0.3Quy ước về chiều và cách viết số#
Ma trận dữ liệu có hàng ứng với điểm dữ liệu và cột ứng với đặc trưng, đúng như X.shape == (n, d) trong NumPy. Trong công thức, là vector cột nên tích với trọng số viết là ; trong mã, cả tập dữ liệu nhân với trọng số viết là X @ w. Hai cách viết chỉ khác nhau một phép chuyển vị.
Phần chữ dùng dấu phẩy thập phân theo lối Việt Nam (0,15). Phần mã và kết quả in ra từ script giữ dấu chấm như Python (0.15).
1Tổng quan về học máy#
Có rất nhiều thuật toán học máy mang tên khác nhau, và người mới dễ có cảm giác phải học thuộc từng cái một. Thực ra phần lớn chúng được ghép từ cùng ba thành phần, và khi đã hiểu ba thành phần ấy thì học một thuật toán mới chỉ còn là trả lời ba câu hỏi. Trước khi đi vào từng thuật toán ở các chương sau, ta dựng khung đó, bắt đầu từ câu hỏi học máy là gì.
1.1Khái niệm học máy#
Một định nghĩa hay được trích dẫn là của Tom Mitchell (1997): một chương trình được gọi là học từ kinh nghiệm đối với một lớp nhiệm vụ và một thước đo hiệu năng , nếu hiệu năng của nó trên các nhiệm vụ trong , đo bằng , tăng lên theo kinh nghiệm . Với bài toán lọc thư rác, là việc gắn nhãn "rác" hoặc "không rác" cho một thư, là tỉ lệ thư được gắn nhãn đúng, còn là tập thư đã được người dùng đánh dấu.
Định nghĩa trên đúng nhưng chưa nói cách làm. Để thấy cách làm, ta nhìn vào cấu tạo của các thuật toán. Mỗi thuật toán học có giám sát đều gồm ba thành phần, như Hình 1 minh hoạ.
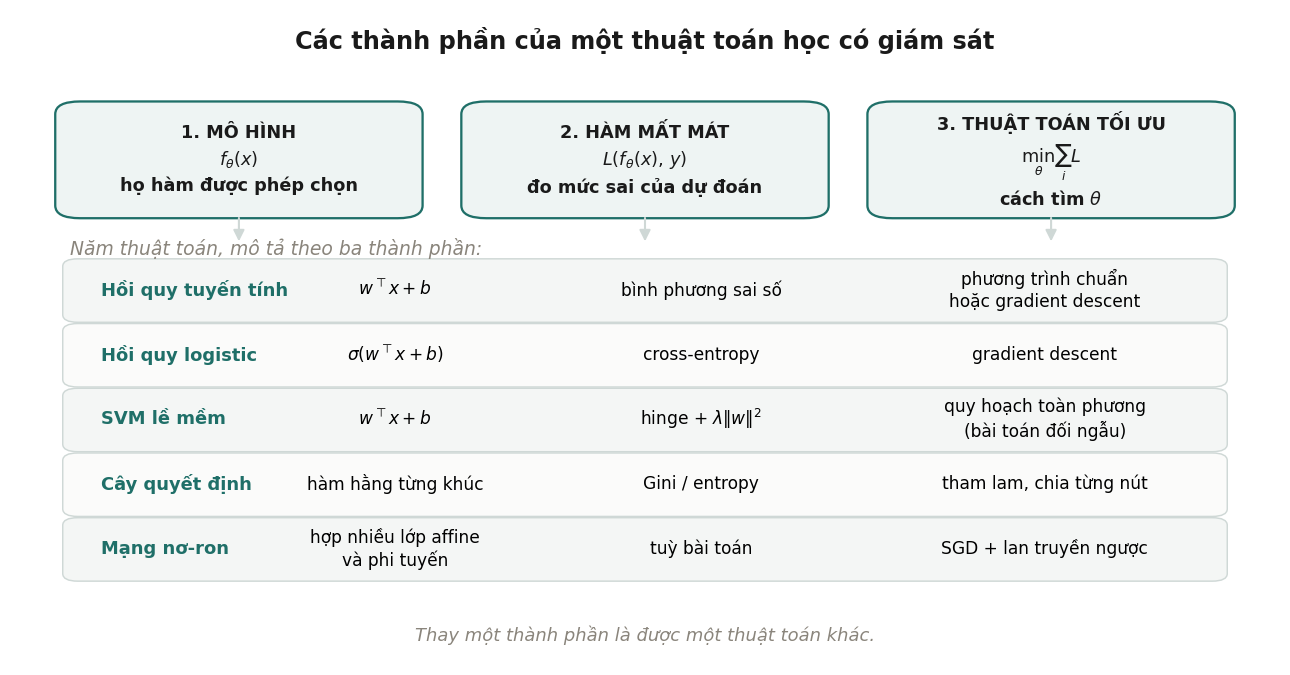
Thành phần thứ nhất là mô hình, tập các hàm mà ta cho phép thuật toán chọn. Hồi quy tuyến tính chỉ cho phép các hàm tuyến tính, chính xác hơn là affine, của đầu vào; cây quyết định cho phép các hàm hằng trên từng vùng; mạng nơ-ron cho phép hợp của nhiều phép biến đổi tuyến tính xen với các hàm phi tuyến. Thành phần thứ hai là hàm mất mát, đo mức sai của một dự đoán so với nhãn thật. Đây là nơi ta nói ra điều mình thực sự muốn: sai lệch lớn có bị phạt nặng hơn không, đoán sai lớp dương có đắt hơn đoán sai lớp âm không. Thành phần thứ ba là thuật toán tối ưu, cách tìm tham số làm tổng mất mát trên dữ liệu huấn luyện nhỏ nhất. Có bài toán giải được bằng công thức, có bài toán phải lặp như gradient descent.
Khung ba thành phần biến việc học một thuật toán mới thành việc trả lời ba câu hỏi: mô hình là họ hàm nào, mất mát là gì, tối ưu bằng cách nào. Với bài toán định giá căn hộ theo diện tích ở Chương 4, câu trả lời là: mô hình là các đường thẳng , mất mát là bình phương độ lệch giữa giá dự đoán và giá thật, còn tối ưu bằng một công thức đóng, hoặc bằng gradient descent ở Chương 5. Nó cũng cho thấy nhiều thuật toán mang tên khác nhau thực ra rất gần nhau. Chương 6 sẽ chỉ ra rằng perceptron, hồi quy logistic và SVM dùng chung một mô hình là hàm tuyến tính và chung một cách tối ưu là gradient descent; chúng chỉ khác nhau ở hàm mất mát.
Định nghĩa 1.1 (Bài toán học có giám sát)
Cho tập huấn luyện , một họ hàm và một hàm mất mát . Bài toán học có giám sát là tìm
với mục đích cuối cùng là dự đoán tốt trên những điểm dữ liệu chưa gặp khi huấn luyện.
Vế cuối của định nghĩa là chỗ tạo ra toàn bộ độ khó của học máy. Tối thiểu hoá mất mát trên dữ liệu huấn luyện chỉ là phương tiện; mục tiêu thật là khả năng tổng quát hoá (generalization) sang dữ liệu mới. Một mô hình ghi nhớ nguyên văn tập huấn luyện có mất mát huấn luyện bằng 0 nhưng có thể vô dụng trên dữ liệu mới. Hiện tượng này gọi là overfitting và được bàn kỹ ở Chương 9.
1.2Các dạng bài toán học máy#
Cách phân loại thông dụng nhất dựa vào việc dữ liệu có nhãn hay không. Trong học có giám sát (supervised learning), mỗi điểm dữ liệu đi kèm một nhãn . Nếu nhãn là số thực, như giá nhà hay nhiệt độ ngày mai, bài toán là hồi quy; nếu nhãn thuộc một tập hữu hạn các lớp, như thư rác hay không, ảnh chứa chữ số nào, bài toán là phân loại. Trong học không giám sát (unsupervised learning), ta chỉ có mà không có nhãn, và mục tiêu là tìm cấu trúc trong dữ liệu: gom các điểm giống nhau thành cụm, tìm vài hướng chứa phần lớn thông tin, hay ước lượng mật độ phân phối. Dạng thứ ba là học tăng cường (reinforcement learning), trong đó một tác tử tương tác với môi trường và nhận tín hiệu thưởng thay vì nhận nhãn đúng cho từng đầu vào; giáo trình Biểu diễn & Căn chỉnh trình bày dạng này.
Bảng sau xếp các chương của giáo trình theo cách phân loại trên.
| Có nhãn | Không có nhãn | |
|---|---|---|
| Dự đoán một số thực | hồi quy (Chương 4) | |
| Dự đoán một lớp | phân loại (Chương 6, 7, 13) | phân cụm (Chương 15) |
| Tìm cấu trúc, giảm chiều | LDA (Mục 14.4) | PCA, SVD (Chương 14) |
| Điền giá trị còn thiếu | phân rã ma trận (Chương 16) |
Ranh giới giữa hai cột không cứng. Trong hệ thống gợi ý ở Chương 16, các ô đánh giá đã biết đóng vai trò nhãn, nhưng phần lớn ma trận là ô trống cần điền, nên bài toán nằm giữa hai loại. Ngoài ra còn các dạng lai như học bán giám sát, khi chỉ một phần nhỏ dữ liệu có nhãn, và học tự giám sát, khi nhãn được tạo ra từ chính dữ liệu, chẳng hạn đoán từ tiếp theo trong câu. Học tự giám sát là cách các mô hình ngôn ngữ lớn được huấn luyện, và được trình bày trong giáo trình Biểu diễn & Căn chỉnh.
Ba ví dụ nhỏ đi suốt giáo trình, mỗi ví dụ ứng với một dạng bài toán. Bốn căn hộ với diện tích và giá là bài toán hồi quy, xuất hiện từ Chương 2 tới Chương 11. Sáu sinh viên với số giờ ôn thi và kết quả đỗ hay trượt là bài toán phân loại, từ Chương 6 tới Chương 13. Bốn cửa hàng cần đặt hai kho hàng là bài toán phân cụm ở Chương 15. Các ví dụ đủ nhỏ để tính tay, nên mỗi công thức được kiểm tra trên chúng trước khi đi tới thí nghiệm trên dữ liệu lớn hơn.
1.3Các yếu tố cần xét trước khi chọn thuật toán#
Trước khi chọn một mô hình cụ thể, có ba câu hỏi về dữ liệu và mục tiêu ảnh hưởng tới lựa chọn nhiều hơn bản thân thuật toán.
Câu hỏi đầu tiên là số điểm dữ liệu so với số đặc trưng. Tỉ lệ quyết định mô hình được phép linh hoạt tới mức nào. Khi lớn hơn rất nhiều, ta có thể dùng mô hình nhiều tham số mà ít lo overfitting. Khi xấp xỉ hoặc nhỏ hơn , regularization trở thành bắt buộc (Chương 9), và một số phương pháp không dùng được nữa: Mục 4.3 cho thấy phương trình chuẩn của hồi quy tuyến tính không có nghiệm duy nhất khi các cột của phụ thuộc tuyến tính, điều chắc chắn xảy ra khi .
Câu hỏi thứ hai là dữ liệu có cấu trúc gì. Ảnh có tính cục bộ, vì điểm ảnh gần nhau liên quan với nhau, và bất biến theo dịch chuyển, vì con mèo ở góc trái hay góc phải vẫn là con mèo. Văn bản và chuỗi thời gian có thứ tự. Dữ liệu dạng bảng, như bảng thông tin khách hàng, không có cấu trúc nào như vậy: đổi thứ tự các cột không làm thay đổi ý nghĩa. Mạng nơ-ron tích chập và Transformer mạnh vì khai thác được cấu trúc của ảnh và chuỗi. Trên dữ liệu dạng bảng, mô hình tuyến tính và các mô hình dựa trên cây quyết định thường cho kết quả tương đương hoặc tốt hơn mạng nơ-ron với chi phí thấp hơn nhiều.
Câu hỏi thứ ba là mục tiêu là dự đoán hay giải thích. Có bài toán chỉ cần dự đoán đúng, chẳng hạn xếp hạng quảng cáo. Có bài toán cần trả lời câu hỏi "đặc trưng này ảnh hưởng tới kết quả bao nhiêu", chẳng hạn đánh giá tác dụng của một chính sách. Hai mục tiêu có thể dẫn tới hai lựa chọn khác nhau. Mục 4.4 đo một trường hợp cụ thể: khi hai đặc trưng gần như trùng nhau, độ dao động của hệ số hồi quy tăng khoảng 25 lần trong khi độ dao động của dự đoán gần như không đổi. Nếu chỉ cần dự đoán thì hiện tượng này vô hại; nếu cần đọc ý nghĩa của hệ số thì các hệ số đó không đáng tin.
1.4Vị trí của giáo trình trong lộ trình#
Giáo trình này là chặng đầu của một lộ trình sáu giáo trình, xây dựng theo roadmap AI Engineer của roadmap.sh và bổ sung phần kiến thức nền mà roadmap đó giả định người học đã có.
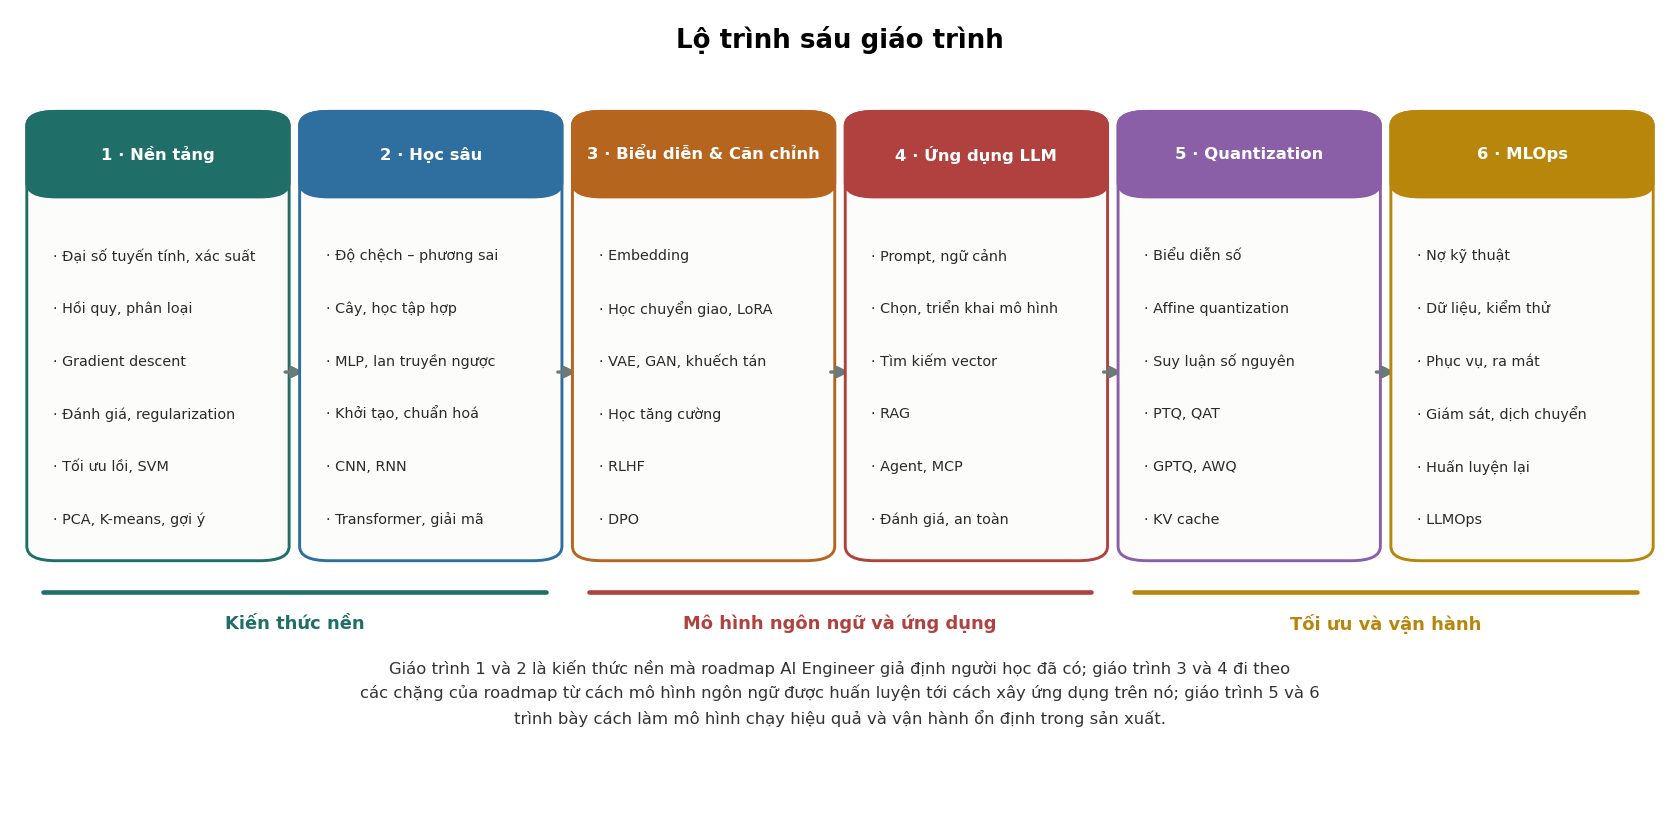
Kiến thức của giáo trình này được dùng lại ở nhiều chỗ trong các giáo trình sau. Gradient descent ở Chương 5 là nền cho Chương 5 của Học sâu, nơi thuật toán được mở rộng thành momentum, Adam và lan truyền ngược qua nhiều lớp. Hồi quy logistic ở Chương 6 là một mạng nơ-ron một lớp, và Chương 4 của Học sâu bắt đầu bằng việc chồng nhiều lớp như vậy lên nhau. Regularization ở Chương 9 và ước lượng MAP ở Chương 10 giải thích nguồn gốc của weight decay, kỹ thuật được dùng mặc định khi huấn luyện mạng sâu (Chương 5 của Học sâu). Các độ đo đánh giá ở Chương 8 là nền cho việc đánh giá mô hình trong sản xuất ở Chương 6 của MLOps. Tích vô hướng, cosine và PCA ở Chương 2 và Chương 14 là công cụ để hiểu embedding và tìm kiếm vector trong giáo trình Biểu diễn & Căn chỉnh và Ứng dụng LLM. Còn SVD ở Mục 2.6 là công cụ để đọc Chương 11 của Quantization, nơi các phương pháp như GPTQ dựa trên phân rã ma trận.
1.5Quy trình giải một bài toán học máy#
Các chương sau đi sâu vào từng thuật toán. Mục này mô tả quy trình bao quanh thuật toán, vì trên thực tế phần lớn lỗi nằm ở quy trình chứ không nằm ở thuật toán.
Mọi thứ bắt đầu từ việc xác định bài toán và thước đo: viết rõ đầu vào, đầu ra và thước đo thành công trước khi đụng tới dữ liệu. Thước đo phải phản ánh chi phí thật. Với bài toán phát hiện gian lận, bỏ sót một ca gian lận thường đắt hơn nhiều so với báo động nhầm, nên độ chính xác không phải thước đo phù hợp (Mục 8.1).
Bước tiếp theo là thu thập và chia dữ liệu. Dữ liệu được chia thành tập huấn luyện, tập xác thực và tập kiểm tra ngay từ đầu. Tập huấn luyện dùng để học tham số, tập xác thực dùng để chọn siêu tham số và so sánh mô hình, còn tập kiểm tra chỉ dùng một lần ở cuối để báo cáo kết quả. Cách chia phải khớp với cách mô hình sẽ được dùng, chẳng hạn dữ liệu có yếu tố thời gian thì chia theo thời gian (Mục 8.5).
Trước khi thử mô hình phức tạp, nên dựng một mô hình cơ sở đơn giản nhất có thể: đoán giá trị trung bình, đoán lớp phổ biến nhất, hoặc một mô hình tuyến tính. Mô hình cơ sở cho biết một mô hình phức tạp hơn có thật sự mang lại gì hay không. Sau đó mới tới xây dựng đặc trưng và huấn luyện: chuẩn hoá đặc trưng, mã hoá biến hạng mục, xử lý giá trị thiếu. Mọi phép biến đổi có tham số, như trung bình và độ lệch chuẩn khi chuẩn hoá, chỉ được ước lượng trên tập huấn luyện.
Mô hình được đánh giá và điều chỉnh trên tập xác thực hoặc bằng cross-validation (Mục 9.5) để chọn siêu tham số. Khi đánh giá, nên xem lỗi theo từng nhóm dữ liệu chứ không chỉ một con số tổng. Cuối cùng, mô hình được đo trên tập kiểm tra đúng một lần rồi mới triển khai. Sau khi triển khai, mô hình cần được giám sát vì phân phối dữ liệu thay đổi theo thời gian; giáo trình MLOps trình bày phần này.
Lưu ý
Nếu tập kiểm tra được dùng nhiều lần để chọn mô hình, nó trở thành một tập xác thực thứ hai và con số báo cáo sẽ lạc quan hơn thực tế. Đây là lỗi phổ biến nhất khi so sánh mô hình, và Mục 9.5 nói cách tránh.
1.6Tóm tắt#
Mỗi thuật toán học có giám sát gồm ba thành phần: mô hình là họ hàm được phép chọn, hàm mất mát đo mức sai, và thuật toán tối ưu tìm tham số. Mục tiêu thật của học máy là tổng quát hoá sang dữ liệu chưa gặp, không phải tối thiểu hoá mất mát trên dữ liệu huấn luyện. Bài toán học máy chia theo việc có nhãn hay không thành học có giám sát, gồm hồi quy và phân loại, học không giám sát, và học tăng cường; bốn căn hộ, sáu sinh viên và bốn cửa hàng là ba ví dụ của ba dạng đó, đi cùng các chương sau. Trước khi chọn thuật toán cần xét tỉ lệ số điểm trên số đặc trưng, cấu trúc của dữ liệu, và mục tiêu là dự đoán hay giải thích. Quy trình bao quanh thuật toán, từ chọn thước đo, chia dữ liệu tới dùng tập kiểm tra đúng một lần, là nơi xảy ra phần lớn lỗi.
Để làm việc với cả ba thành phần, ta cần một ngôn ngữ chung: dữ liệu là ma trận, mô hình tuyến tính là phép nhân ma trận với vector, và tối ưu cần đạo hàm theo vector. Chương 2 nhắc lại phần đại số tuyến tính cần cho ngôn ngữ đó.
2Đại số tuyến tính#
Mọi thuật toán trong giáo trình đều viết bằng ngôn ngữ vector và ma trận, và nhiều kết luận quan trọng ở các chương sau thực ra là hệ quả của vài định lý đại số tuyến tính. Chẳng hạn, việc hồi quy tuyến tính có nghiệm duy nhất hay không phụ thuộc vào hạng của ma trận dữ liệu, còn tốc độ của gradient descent phụ thuộc vào tỉ số giữa trị riêng lớn nhất và nhỏ nhất. Ở đây ta nhắc lại những khái niệm đó, mỗi khái niệm kèm lý do nó cần thiết. Các khái niệm được minh hoạ trên cùng một ma trận dữ liệu nhỏ, diện tích của bốn căn hộ, ma trận mà Chương 4 sẽ dùng để định giá căn hộ. Người đã vững đại số tuyến tính có thể đọc lướt bảng ở Mục 2.1 rồi chuyển sang Chương 3.
2.1Vector, ma trận và hạng#
Một vector là một danh sách số thực, quy ước viết thành cột. Trong học máy, mỗi điểm dữ liệu là một vector: một căn nhà được mô tả bằng diện tích, số phòng và khoảng cách tới trung tâm là một vector ba chiều. Một ma trận là một bảng hàng, cột; ma trận dữ liệu xếp điểm dữ liệu thành hàng.
Tích ma trận với vector có hai cách đọc, và cả hai đều được dùng:
Đọc theo hàng, là vector chứa dự đoán của mô hình tuyến tính cho từng điểm dữ liệu. Đọc theo cột, là một tổ hợp tuyến tính của các cột của . Tập mọi tổ hợp tuyến tính như vậy gọi là không gian cột của , và hồi quy tuyến tính chính là tìm điểm trong không gian cột gần nhất (Chương 4).
Bốn căn hộ có diện tích 40, 60, 80 và 100 m² cho thấy cả hai cách đọc. Thêm một cột hằng 1 cho hệ số chặn, ma trận dữ liệu và một vector tham số là
Đọc theo hàng, là giá dự đoán, tính bằng tỉ đồng, của bốn căn: căn 40 m² được đoán tỉ. Đọc theo cột, cùng vector đó là 0,57 lần cột hằng cộng 0,024 lần cột diện tích. Chương 4 sẽ chỉ ra vì sao này là lựa chọn tốt nhất cho bốn căn hộ.
Định nghĩa 2.1 (Hạng)
Hạng của ma trận , ký hiệu , là số cột độc lập tuyến tính lớn nhất của (bằng số hàng độc lập tuyến tính lớn nhất). Ma trận gọi là đủ hạng cột nếu , tức không cột nào là tổ hợp tuyến tính của các cột còn lại.
Vì hạng không vượt quá số hàng, một ma trận có nhiều cột hơn hàng () không thể đủ hạng cột. Đó chính là cơ sở toán học của nhận xét ở Mục 1.3 rằng dữ liệu có nhiều đặc trưng hơn số điểm cần được xử lý đặc biệt. Ma trận của bốn căn hộ có hai cột không tỉ lệ với nhau, nên có hạng 2 và đủ hạng cột. Thêm một cột ghi diện tích bằng dm², tức 100 lần cột diện tích, thì ma trận có ba cột nhưng hạng vẫn là 2 và không còn đủ hạng cột; Mục 4.3 xét đúng tình huống đặc trưng trùng lặp này.
Bảng sau liệt kê các khái niệm của chương và nơi chúng được dùng.
| Khái niệm | Dùng ở đâu |
|---|---|
| Tích vô hướng | mọi mô hình tuyến tính (Chương 4, 6, 13) |
| Chuẩn , | regularization (Chương 9), lề của SVM (Chương 13) |
| Hạng của ma trận | điều kiện có nghiệm của phương trình chuẩn (Mục 4.3) |
| Trị riêng, vector riêng | PCA (Chương 14), số điều kiện (Mục 5.3) |
| Ma trận xác định dương | hàm lồi bậc hai (Chương 11) |
| Phân tích SVD | PCA, ridge, phân rã ma trận (Chương 9, 14, 16) |
| Đạo hàm theo vector | mọi phép suy ra công thức cập nhật tham số |
2.2Tích vô hướng và siêu phẳng#
Định nghĩa 2.2 (Tích vô hướng)
Tích vô hướng của hai vector là
trong đó là góc giữa hai vector.
Hai cách viết ứng với hai cách hiểu. Theo cách đại số, là tổng có trọng số của các đặc trưng: đặc trưng nào có trọng số lớn thì đóng góp nhiều vào kết quả. Theo cách hình học, bằng độ dài hình chiếu của lên hướng của nhân với độ dài của . Khi hai vector cùng hướng, tích vô hướng lớn và dương; khi vuông góc, nó bằng 0; khi ngược hướng, nó âm. Chia cho tích hai độ dài ta được , gọi là độ tương đồng cosine, thước đo dùng khắp nơi khi so sánh embedding.
Cách hiểu hình học cho biết tập nghiệm của phương trình là gì. Đó là tập các điểm mà hình chiếu lên hướng có cùng một giá trị, tức một siêu phẳng vuông góc với . Trong không gian hai chiều, siêu phẳng là một đường thẳng; trong ba chiều, là một mặt phẳng. Vector gọi là vector pháp tuyến của siêu phẳng. Mọi bộ phân loại tuyến tính ở Chương 6 và Chương 13 đều chia không gian bằng một siêu phẳng như vậy: phía là một lớp, phía còn lại là lớp kia.
Định lý 2.1 (Khoảng cách từ một điểm tới siêu phẳng)
Khoảng cách từ điểm tới siêu phẳng là
Chứng minh
Gọi là hình chiếu vuông góc của lên siêu phẳng. Vì vuông góc với siêu phẳng nên nó cùng phương với : với là khoảng cách cần tìm. Nhân vô hướng hai vế với và dùng ta được , suy ra .
Ví dụ 2.1
Cho , và điểm . Ta có và , nên khoảng cách từ tới đường thẳng bằng 1. Dấu của là dương, nên nằm về phía mà chỉ tới.
Công thức khoảng cách xuất hiện lại ở Mục 13.2. Trong SVM, khoảng cách từ điểm dữ liệu gần nhất tới siêu phẳng tỉ lệ nghịch với , nên cực đại khoảng cách đó tương đương với cực tiểu .
2.3Chuẩn của vector#
Chuẩn là cách đo độ dài của một vector. Ba chuẩn hay gặp là
Chuẩn là độ dài Euclid thông thường. Chuẩn là tổng trị tuyệt đối, còn gọi là khoảng cách Manhattan khi dùng để đo khoảng cách giữa hai điểm, vì giống cách đi theo các khối nhà vuông góc. Chuẩn là thành phần có trị tuyệt đối lớn nhất. Chẳng hạn với : , , .
Cách dễ nhất để thấy khác biệt giữa các chuẩn là vẽ quả cầu đơn vị trong hai chiều. Với đó là hình tròn. Với đó là hình vuông xoay 45 độ, có bốn đỉnh nằm trên các trục toạ độ. Với đó là hình vuông có cạnh song song với các trục.
Nghe như ba cách đo cùng một thứ, nhưng khi dùng làm thành phần regularization, chọn hay cho ra hai thuật toán có hành vi khác nhau về bản chất. Mục 9.4 đo được rằng phạt (ridge) không bao giờ đưa một hệ số về đúng 0, còn phạt (lasso) thì có: ở , lasso đưa đúng 9 trong 12 hệ số về 0, trùng với số hệ số bằng 0 của mô hình sinh ra dữ liệu. Về hình học, các đỉnh nhọn của quả cầu nằm trên trục toạ độ và nghiệm tối ưu hay rơi vào các đỉnh đó; về giải tích, hàm không khả vi tại 0. Mục 9.4 trình bày cả hai cách giải thích.
2.4Trị riêng và vector riêng#
Định nghĩa 2.3 (Trị riêng, vector riêng)
Cho ma trận vuông . Số là một trị riêng và vector khác không là một vector riêng tương ứng nếu
Phép nhân với nói chung vừa xoay vừa kéo dãn một vector. Vector riêng là những hướng đặc biệt mà không xoay, chỉ kéo dãn với hệ số , hoặc lật ngược nếu . Trong học máy, ma trận ta gặp nhiều nhất là ma trận hiệp phương sai và ma trận , và cả hai đều đối xứng. Với ma trận đối xứng có một kết quả rất mạnh.
Định lý 2.2 (Định lý phổ)
Mọi ma trận đối xứng thực có trị riêng thực và một hệ vector riêng trực chuẩn . Viết và thì
Định lý phổ nói rằng một ma trận đối xứng chỉ làm một việc đơn giản: trong hệ toạ độ gồm các vector riêng, nó kéo dãn mỗi trục một hệ số . Đây là nền tảng của PCA ở Chương 14, vì các thành phần chính chính là các vector riêng của ma trận hiệp phương sai.
Ví dụ 2.2
Ma trận có hai trị riêng và , với vector riêng và . Kiểm tra: . Như vậy kéo dãn gấp ba theo đường chéo và giữ nguyên theo đường chéo .
Hai đẳng thức sau được dùng thường xuyên về sau:
Với ma trận ở Ví dụ 2.2, vết bằng và định thức bằng .
Định nghĩa 2.4 (Số điều kiện)
Với ma trận đối xứng xác định dương , số điều kiện là tỉ số giữa trị riêng lớn nhất và nhỏ nhất:
Số điều kiện đo độ "dẹt" của ma trận: nghĩa là kéo dãn mọi hướng như nhau, còn lớn nghĩa là có hướng bị kéo rất mạnh và có hướng gần như bị ép dẹt. Với bốn căn hộ, có hai trị riêng khoảng 21 604 và 0,37, nên : theo một hướng, ma trận kéo dãn mạnh hơn hướng kia khoảng 58 nghìn lần. Đại lượng này quyết định tốc độ của gradient descent. Mục 5.3 đo được rằng số vòng lặp cần thiết tỉ lệ thuận với : khi tăng từ 1 lên 10 000, số vòng lặp tăng từ 1 lên 92 104. Cũng ở mục đó, chỉ cần trừ trung bình rồi chia diện tích cho độ lệch chuẩn là của bài toán bốn căn hộ giảm từ 58 340 xuống 1.
2.5Ma trận xác định dương#
Định nghĩa 2.5 (Ma trận xác định dương)
Ma trận đối xứng gọi là xác định dương nếu với mọi , và nửa xác định dương nếu với mọi . Tương đương: mọi trị riêng của dương (tương ứng, không âm).
Sự tương đương với trị riêng suy ra ngay từ định lý phổ: viết trong hệ toạ độ vector riêng, , thì . Tổng này dương với mọi khi và chỉ khi mọi .
Các chương sau cần tới khái niệm này ở ba chỗ. Thứ nhất, hàm bậc hai là hàm lồi khi và chỉ khi nửa xác định dương (Chương 11), và khi xác định dương thì có đúng một điểm cực tiểu. Thứ hai, ma trận luôn nửa xác định dương, vì ; nó xác định dương khi và chỉ khi với mọi , tức khi đủ hạng cột. Đó chính là điều kiện để phương trình chuẩn của hồi quy tuyến tính có nghiệm duy nhất (Mục 4.3). Với bốn căn hộ, hai trị riêng 21 604 và 0,37 của đều dương, nên ma trận này xác định dương. Thứ ba, nếu nửa xác định dương và thì xác định dương, vì với mọi ; các trị riêng của là , đều lớn hơn hoặc bằng . Nhờ tính chất này, hồi quy ridge luôn có nghiệm duy nhất, kể cả khi hồi quy tuyến tính thông thường không có (Mục 9.2).
2.6Phân tích giá trị suy biến (SVD)#
Định lý phổ chỉ áp dụng cho ma trận vuông đối xứng. Ma trận dữ liệu thường chữ nhật, và công cụ tương ứng cho nó là SVD.
Định lý 2.3 (Phân tích giá trị suy biến)
Mọi ma trận viết được dưới dạng
trong đó và là ma trận trực giao, còn có các phần tử trên đường chéo và bằng 0 ở mọi chỗ khác. Các số gọi là giá trị suy biến của .
Về mặt hình học, SVD nói rằng mọi phép biến đổi tuyến tính đều gồm ba bước: xoay (nhân ), kéo dãn theo các trục toạ độ (nhân ), rồi xoay lần nữa (nhân ). Các chương sau dùng ba hệ quả của nó.
Hệ quả thứ nhất là liên hệ với trị riêng. Ta có , nên các vector riêng của là các cột của và các trị riêng là . Khi đã được trừ trung bình theo cột, ma trận hiệp phương sai mẫu là , nên trị riêng của nó bằng . Mục 14.2 kiểm chứng điều này bằng số: tính theo hai cách, kết quả lệch nhau .
Hệ quả thứ hai là số điều kiện bị bình phương. Vì trị riêng của là bình phương giá trị suy biến của , ta có , trong đó . Nếu thì . Với bốn căn hộ, hai giá trị suy biến của là khoảng 146,98 và 0,609, nên và , đúng số điều kiện ở Mục 2.4. Khi giải một hệ tuyến tính có số điều kiện bằng số thực dấu phẩy động, ta có thể mất khoảng chữ số có nghĩa, nên lập làm mất gấp đôi số chữ số so với làm việc trực tiếp trên . Vì vậy các thư viện giải bài toán bình phương tối thiểu bằng phân tích QR hoặc SVD của thay vì dùng công thức .
Hệ quả thứ ba là xấp xỉ hạng thấp tốt nhất. Giữ lại giá trị suy biến lớn nhất và đặt các giá trị còn lại bằng 0 cho ma trận hạng gần nhất theo chuẩn Frobenius; đây là định lý Eckart–Young, và Mục 14.3 kiểm chứng đẳng thức sai số của nó tới .
2.7Đạo hàm theo vector#
Hầu hết thuật toán học máy tìm tham số bằng cách cho gradient của hàm mất mát bằng 0 hoặc đi ngược hướng gradient. Vì vậy cần tính được đạo hàm của hàm nhiều biến.
Định nghĩa 2.6 (Gradient)
Với hàm , gradient của tại là vector các đạo hàm riêng
Ma trận các đạo hàm riêng cấp hai gọi là ma trận Hessian, ký hiệu .
Bốn công thức trong bảng dưới đủ cho toàn bộ giáo trình.
| Hàm | Gradient |
|---|---|
| , bằng khi đối xứng | |
Công thức cuối được dùng nhiều nhất, và suy ra được từ ba công thức đầu. Khai triển
Số hạng đầu không phụ thuộc nên có gradient bằng 0. Số hạng thứ hai có dạng với . Số hạng thứ ba có dạng với đối xứng, nên gradient là . Cộng lại, ta được
Cho gradient này bằng 0 ta được phương trình chuẩn của Chương 4. Với bốn căn hộ, giá thật là tỉ, và với ở Mục 2.1, phần dư là . Thành phần thứ nhất của là tổng các phần dư, bằng 0; thành phần thứ hai là tổng có trọng số theo diện tích, . Gradient bằng 0, nên này là nghiệm, đúng như Chương 4 sẽ tìm ra. Ma trận Hessian của hàm này là , nửa xác định dương theo Mục 2.5, nên hàm lồi và mọi điểm có gradient bằng 0 đều là cực tiểu.
Lưu ý
Công thức gradient tự suy ra bằng tay rất dễ sai dấu hoặc thiếu hệ số 2. Cách kiểm tra đáng tin là so sánh với đạo hàm tính bằng sai phân hữu hạn. Mục 5.5 trình bày cách làm và cách chọn bước sai phân , trong đó quá nhỏ lại cho kết quả kém hơn.
2.8Tóm tắt#
Ma trận dữ liệu xếp mỗi điểm thành một hàng, và tích vừa là vector dự đoán vừa là tổ hợp tuyến tính của các cột. Hạng của cho biết các cột có độc lập hay không, nên quyết định hồi quy tuyến tính có nghiệm duy nhất hay không. Tích vô hướng đo độ chiếu của vector này lên vector kia, và mặt là một siêu phẳng với khoảng cách từ một điểm tới nó bằng . Chuẩn và khác nhau ở hình dạng quả cầu đơn vị, và khác biệt đó quyết định hành vi của lasso và ridge. Ma trận đối xứng chỉ kéo dãn các trục vector riêng của nó, số điều kiện đo độ dẹt của phép kéo dãn đó, và SVD mở rộng ý tưởng này cho ma trận chữ nhật. Cuối cùng, gradient của là , công thức sẽ dùng ngay ở Chương 4. Ma trận của bốn căn hộ minh hoạ cả chương: cho giá dự đoán, đủ hạng cột, là bình phương của , và gradient bằng 0 tại .
Đại số tuyến tính mô tả dữ liệu và mô hình, nhưng chưa nói gì về nhiễu. Dữ liệu thật luôn có nhiễu, và mô hình học từ một mẫu hữu hạn nên kết quả của nó cũng ngẫu nhiên. Chương 3 nhắc lại các công cụ xác suất để mô tả sự không chắc chắn đó.
3Xác suất và thống kê#
Chương 2 mô tả dữ liệu và mô hình bằng vector và ma trận, như thể mọi con số đều chính xác. Thực tế thì không: hai căn nhà cùng diện tích vẫn có giá khác nhau, nhãn do người gán có lúc sai, và mỗi lần thu thập lại dữ liệu ta được một mẫu khác. Mô hình học từ một mẫu hữu hạn như vậy, nên bản thân nó cũng là một đại lượng ngẫu nhiên. Xác suất là ngôn ngữ để nói về sự không chắc chắn đó, và nó còn trả lời được hai câu hỏi mà đại số tuyến tính không trả lời được: vì sao hàm mất mát có dạng như vậy, và vì sao regularization có tác dụng.
3.1Vai trò của xác suất trong học máy#
Xác suất xuất hiện trong giáo trình theo ba cách. Cách thứ nhất là mô tả dự đoán không chắc chắn. Hồi quy logistic (Chương 6) trả về xác suất một điểm thuộc lớp dương chứ không chỉ một nhãn, và nhờ có xác suất, ta chọn được ngưỡng quyết định theo chi phí của từng loại sai (Chương 8). Cách thứ hai là giải thích nguồn gốc của hàm mất mát. Bình phương sai số và cross-entropy không phải hai lựa chọn tuỳ ý; Chương 10 chỉ ra rằng chúng là hệ quả của nguyên lý hợp lý cực đại dưới hai giả thiết khác nhau về nhiễu. Cách thứ ba là giải thích nguồn gốc của regularization: Mục 10.4 chỉ ra rằng hồi quy ridge trùng với ước lượng hậu nghiệm cực đại khi tiên nghiệm của trọng số là phân phối Gauss, và kiểm chứng điều này bằng số.
3.2Kỳ vọng và phương sai#
Định nghĩa 3.1 (Kỳ vọng, phương sai)
Với biến ngẫu nhiên có hàm xác suất (hoặc hàm mật độ) , kỳ vọng của là
và phương sai của là .
Kỳ vọng là giá trị trung bình nếu lặp lại phép thử rất nhiều lần. Phương sai đo mức phân tán quanh giá trị trung bình đó; căn bậc hai của nó là độ lệch chuẩn, có cùng đơn vị với .
Các tính chất sau được dùng nhiều lần. Với hằng số ,
Kỳ vọng của tổng luôn bằng tổng các kỳ vọng, không cần điều kiện gì: . Phương sai của tổng thì phụ thuộc vào mức độ hai biến liên quan với nhau:
trong đó hiệp phương sai . Chuẩn hoá hiệp phương sai bằng tích hai độ lệch chuẩn ta được hệ số tương quan . Chỉ khi và không tương quan (), chẳng hạn khi chúng độc lập, phương sai của tổng mới bằng tổng các phương sai.
Ví dụ 3.1 (Trung bình của nhiều mô hình)
Giả sử có mô hình, dự đoán của mỗi mô hình là một biến ngẫu nhiên có phương sai , và mỗi cặp mô hình có hệ số tương quan . Phương sai của trung bình dự đoán là
Với và : nếu các mô hình không tương quan (), phương sai giảm còn ; nếu , phương sai chỉ giảm còn . Dù có thêm bao nhiêu mô hình, phương sai không xuống dưới .
Ví dụ này là cơ sở lý thuyết của phương pháp bagging và rừng ngẫu nhiên: lấy trung bình nhiều mô hình chỉ giảm phương sai hiệu quả khi các mô hình ít tương quan với nhau. Rừng ngẫu nhiên chọn ngẫu nhiên một tập con đặc trưng ở mỗi nhát cắt của cây chính là để giảm . Mục 3.3 của Học sâu đo hiện tượng này trên dữ liệu.
3.3Ma trận hiệp phương sai#
Khi dữ liệu có nhiều chiều, ta cần biết phương sai của từng chiều và hiệp phương sai giữa mọi cặp chiều. Các con số đó được xếp vào một ma trận.
Định nghĩa 3.2 (Ma trận hiệp phương sai)
Với vector ngẫu nhiên có kỳ vọng , ma trận hiệp phương sai là
Từ điểm dữ liệu, gọi là ma trận dữ liệu đã trừ trung bình của từng cột, ước lượng mẫu của là
Đường chéo của chứa phương sai của từng đặc trưng; các phần tử ngoài đường chéo chứa hiệp phương sai giữa từng cặp đặc trưng. Ma trận này có ba tính chất, ứng với ba chỗ dùng ở các chương sau. Trước hết, đối xứng và nửa xác định dương, vì với mọi . Theo định lý phổ, có hệ vector riêng trực chuẩn, và đó là các thành phần chính của PCA (Chương 14). Tiếp theo, trị riêng lớn nhất của là phương sai lớn nhất mà một phép chiếu lên một hướng đơn vị có thể đạt được, và hướng đạt giá trị đó là vector riêng tương ứng. Cuối cùng, giả thiết "naive" của thuật toán Naive Bayes Gauss tương đương với việc ép của mỗi lớp thành ma trận đường chéo, tức coi mọi cặp đặc trưng là không tương quan khi đã biết lớp; Mục 7.4 kiểm chứng điều này bằng số và cho thấy Naive Bayes, LDA và QDA chỉ khác nhau ở ràng buộc đặt lên .
Bốn căn hộ của Chương 2 cho một ma trận hiệp phương sai cụ thể. Lấy hai đặc trưng là diện tích và giá; trừ trung bình 70 m² và 2,25 tỉ, các hàng của là , , và , nên
Phương sai của diện tích là 666,7, tức độ lệch chuẩn khoảng 25,8 m²; phương sai của giá là 0,39, tức độ lệch chuẩn khoảng 0,62 tỉ. Hiệp phương sai 16 dương, tức căn rộng hơn thì đắt hơn, và hệ số tương quan cho thấy giá gần như tỉ lệ thuận với diện tích. Tỉ số là con số sẽ gặp lại ở Chương 4: đó là độ dốc của đường thẳng khớp bốn căn hộ tốt nhất. Hai phần tử trên đường chéo chênh nhau khoảng 1 700 lần chỉ vì đơn vị đo, mét vuông so với tỉ đồng, nên vector riêng ứng với trị riêng lớn nhất gần như trùng với trục diện tích; Mục 14.2 cho thấy vì sao cần chuẩn hoá trước khi dùng các vector riêng này.
Mẫu số thay cho trong ước lượng mẫu có lý do, được giải thích ở Ví dụ 3.4.
3.4Phân phối Gauss#
Phân phối Gauss, hay phân phối chuẩn, là phân phối được dùng nhiều nhất, vì hai lý do. Về lý thuyết, định lý giới hạn trung tâm nói rằng tổng của nhiều biến ngẫu nhiên độc lập nhỏ xấp xỉ phân phối Gauss, nên nhiễu tổng hợp từ nhiều nguồn thường có dạng Gauss. Về tính toán, logarit của mật độ Gauss là một hàm bậc hai, nên các bài toán tối ưu dẫn xuất từ nó thường có nghiệm dạng đóng.
Định nghĩa 3.3 (Phân phối Gauss)
Biến ngẫu nhiên một chiều có mật độ
Vector ngẫu nhiên có phân phối Gauss nhiều chiều , với xác định dương, nếu có mật độ
Đại lượng trong hàm mũ, , gọi là bình phương khoảng cách Mahalanobis từ tới . Các điểm có cùng khoảng cách Mahalanobis nằm trên một đường elip, có các trục là vector riêng của và độ dài bán trục tỉ lệ với căn bậc hai của trị riêng tương ứng.
Ví dụ 3.2
Cho và , tức độ lệch chuẩn theo trục thứ nhất là 2 và theo trục thứ hai là 1. Hai điểm và cùng cách gốc 2 đơn vị theo khoảng cách Euclid. Nhưng còn , tức cách tâm 1 độ lệch chuẩn còn cách tâm 2 độ lệch chuẩn. Theo phân phối này, điểm bình thường hơn điểm nhiều.
Ví dụ trên cho thấy khoảng cách Mahalanobis là khoảng cách Euclid sau khi đã quy mỗi hướng về đơn vị độ lệch chuẩn của dữ liệu theo hướng đó. Đi một đơn vị theo hướng dữ liệu trải rộng thì "gần", còn theo hướng dữ liệu co hẹp thì "xa".
Lấy logarit của mật độ Gauss ta được
một hàm bậc hai của . Nhận xét đơn giản này có hai hệ quả lớn: hợp lý cực đại dưới giả thiết nhiễu Gauss dẫn tới bài toán bình phương tối thiểu (Mục 10.2), và bộ phân loại dùng phân phối Gauss cho mỗi lớp có biên quyết định là mặt bậc hai (Mục 7.4).
3.5Định lý Bayes#
Định lý 3.1 (Định lý Bayes)
Với hai biến cố (hoặc biến ngẫu nhiên) và , :
Định lý Bayes cho phép đổi chiều một xác suất có điều kiện: biết xác suất quan sát được khi xảy ra, suy ra xác suất xảy ra khi đã quan sát được . Hai chiều này rất khác nhau, và nhầm lẫn chúng là lỗi suy luận phổ biến.
Ví dụ 3.3 (Xét nghiệm bệnh hiếm)
Một bệnh có tỉ lệ mắc 1% dân số. Xét nghiệm cho kết quả dương tính với 99% người mắc bệnh, và dương tính nhầm với 5% người không mắc bệnh. Một người có kết quả dương tính. Xác suất người đó thật sự mắc bệnh là
Chỉ khoảng 1 trong 6 người có kết quả dương tính thật sự mắc bệnh, dù xét nghiệm "đúng 99%". Lý do là số người khoẻ rất lớn, nên 5% dương tính nhầm của họ vẫn nhiều hơn số người bệnh được phát hiện.
Hiện tượng trong Ví dụ 3.3 xuất hiện lại ở Chương 8 dưới tên gọi khác: khi lớp dương hiếm, precision của bộ phân loại có thể rất thấp dù tỉ lệ báo động nhầm nhỏ.
Trong học máy, định lý Bayes được dùng với là tham số của mô hình và là dữ liệu :
Phân phối tiên nghiệm mô tả hiểu biết về tham số trước khi thấy dữ liệu. Hàm hợp lý cho biết dữ liệu quan sát được có khả năng xảy ra tới mức nào nếu tham số là . Phân phối hậu nghiệm là hiểu biết đã được cập nhật sau khi thấy dữ liệu. Mẫu số không phụ thuộc , nên khi tìm làm hậu nghiệm lớn nhất có thể bỏ qua nó:
Vế phải có dạng "mất mát cộng thành phần phạt". Chương 10 khai triển đẳng thức này và cho thấy thành phần phạt chính là regularization.
3.6Ước lượng tham số: độ chệch và phương sai#
Học một mô hình từ dữ liệu là ước lượng tham số của nó. Vì dữ liệu là một mẫu ngẫu nhiên, ước lượng thu được cũng là ngẫu nhiên: lấy một mẫu khác thì được một giá trị khác.
Định nghĩa 3.4 (Độ chệch, phương sai của ước lượng)
Một ước lượng của tham số là một hàm của dữ liệu. Độ chệch (bias) và phương sai của nó là
Ước lượng có độ chệch bằng 0 gọi là ước lượng không chệch.
Ở đây kỳ vọng được lấy trên mọi tập dữ liệu có thể rút ra từ cùng một phân phối, không phải trên các điểm trong một tập dữ liệu. Để hình dung, hãy lặp lại việc thu thập dữ liệu và huấn luyện rất nhiều lần: độ chệch là khoảng cách từ trung bình các kết quả tới giá trị thật, còn phương sai là mức các kết quả tản ra quanh trung bình của chúng.
Định lý 3.2 (Phân tích sai số bình phương trung bình)
Với mọi ước lượng ,
Chứng minh
Đặt . Viết rồi bình phương và lấy kỳ vọng. Số hạng chéo bằng 0 vì . Hai số hạng còn lại là và .
Ví dụ 3.4 (Vì sao chia cho )
Với quan sát độc lập có phương sai , ước lượng có kỳ vọng , tức luôn nhỏ hơn giá trị thật. Nguyên nhân là được tính từ chính dữ liệu, nên các điểm luôn gần hơn so với gần giá trị trung bình thật. Chia cho thay cho cho ước lượng không chệch. Với và , mô phỏng 200 000 lần cho giá trị trung bình của là , khớp với .
Định lý 3.2 cho thấy một ước lượng không chệch chưa chắc là ước lượng tốt: nếu phương sai lớn, sai số tổng vẫn lớn. Ngược lại, chấp nhận một chút độ chệch để đổi lấy phương sai nhỏ hơn nhiều có thể làm sai số tổng giảm. Hồi quy ridge ở Chương 9 là ví dụ điển hình: nó là ước lượng có chệch, trong khi bình phương tối thiểu thông thường là ước lượng không chệch, vậy mà ridge thường có sai số nhỏ hơn. Mục 9.3 chỉ ra phần phương sai mà ridge cắt đi nằm ở những hướng nào.
Cùng ý tưởng này áp dụng cho dự đoán của cả mô hình, dưới tên gọi đánh đổi độ chệch – phương sai (bias–variance tradeoff). Chương 2 của Học sâu trình bày đầy đủ phân tích đó và đo từng thành phần trên 250 tập huấn luyện mô phỏng.
3.7Tóm tắt#
Kỳ vọng và phương sai mô tả giá trị trung bình và mức phân tán của một đại lượng ngẫu nhiên. Phương sai của tổng phụ thuộc vào hiệp phương sai, nên lấy trung bình nhiều mô hình chỉ giảm phương sai xuống tới mức . Ma trận hiệp phương sai gom phương sai và hiệp phương sai của mọi cặp đặc trưng; nó đối xứng, nửa xác định dương, và các vector riêng của nó là các thành phần chính của PCA. Với bốn căn hộ, hiệp phương sai 16 giữa diện tích và giá chia cho phương sai 666,7 của diện tích cho đúng độ dốc 0,024 của Chương 4. Logarit mật độ Gauss là một hàm bậc hai, điều sẽ biến hợp lý cực đại thành bình phương tối thiểu. Định lý Bayes đổi chiều xác suất có điều kiện, như ví dụ xét nghiệm bệnh hiếm cho thấy chỉ khoảng 16,7% người dương tính thật sự mắc bệnh, và viết hậu nghiệm thành dạng mất mát cộng thành phần phạt. Cuối cùng, sai số bình phương của một ước lượng tách thành độ chệch bình phương cộng phương sai, nên một ước lượng có chệch nhưng ít dao động có thể tốt hơn một ước lượng không chệch.
Có đại số tuyến tính và xác suất, ta đã đủ công cụ cho thuật toán học máy đầu tiên. Chương 4 xét hồi quy tuyến tính, bài toán đơn giản tới mức có nghiệm dạng đóng, nên mọi hiện tượng của nó quan sát được trực tiếp.
4Hồi quy tuyến tính#
Ta bắt đầu với một bài toán quen thuộc: định giá căn hộ. Bảng dưới ghi diện tích và giá bán của bốn căn hộ trong cùng một khu, chính là bốn căn hộ của ma trận dữ liệu ở Mục 2.1. Đây là số liệu minh hoạ, chọn tròn để tính tay được.
| Căn hộ | Diện tích (m²) | Giá (tỉ đồng) |
|---|---|---|
| A | 40 | 1,5 |
| B | 60 | 2,1 |
| C | 80 | 2,4 |
| D | 100 | 3,0 |
Nếu được hỏi một căn 90 m² trong khu này đáng giá bao nhiêu, hầu hết mọi người sẽ trả lời khoảng 2,7 tỉ, vì giá tăng gần đều theo diện tích. Hồi quy tuyến tính biến trực giác "tăng gần đều" đó thành một quy trình chính xác: chọn một đường thẳng, đo xem đường thẳng khớp dữ liệu tới mức nào, rồi tìm đường khớp nhất. Đây là thuật toán học có giám sát đơn giản nhất, nhưng đáng học kỹ vì bài toán có nghiệm dạng đóng. Nhờ vậy, những hiện tượng sẽ gặp lại ở mọi mô hình phức tạp hơn, như overfitting, regularization, ảnh hưởng của số điều kiện và đánh đổi độ chệch – phương sai, đều quan sát được trực tiếp mà không bị lẫn với câu hỏi thuật toán tối ưu có hội tụ hay không.
4.1Bài toán hồi quy tuyến tính#
Mô hình đơn giản nhất cho bảng trên là một đường thẳng,
Hệ số là phần giá tăng thêm khi diện tích tăng 1 m², còn là điểm đường thẳng cắt trục tung. Học từ dữ liệu ở đây nghĩa là chọn và . Nhưng trước khi chọn, ta cần một cách nói đường thẳng nào tốt hơn đường thẳng nào.
Với mỗi căn hộ, đường thẳng mắc một sai số , tức chênh lệch giữa giá thật và giá dự đoán. Cộng thẳng các sai số thì không dùng được, vì sai số dương và sai số âm triệt tiêu nhau: một đường dự đoán quá cao cho nửa số căn và quá thấp cho nửa còn lại vẫn có thể cho tổng bằng 0. Cách phổ biến nhất là lấy trung bình bình phương sai số,
Bình phương làm mọi sai số thành số dương, phạt sai số lớn nặng hơn nhiều so với sai số nhỏ, và cho một hàm trơn, dễ lấy đạo hàm. Còn vì sao là bình phương mà không phải trị tuyệt đối thì có một câu trả lời chính xác hơn, trình bày ở Mục 10.2: bình phương sai số là hệ quả của giả thiết nhiễu có phân phối Gauss.
Có hàm , ta so sánh được các đường thẳng bằng số. Đường , tức giá 30 triệu đồng mỗi mét vuông, dự đoán 1,2; 1,8; 2,4 và 3,0 tỉ cho bốn căn. Sai số là 0,3; 0,3; 0 và 0, nên . Đường dự đoán 1,56; 2,04; 2,52 và 3,0 tỉ, với sai số ; ; và , nên , nhỏ hơn khoảng tám lần. Đường thứ hai tốt hơn hẳn. Câu hỏi còn lại là có đường nào tốt hơn nữa không, và đường tốt nhất là đường nào. Mục 4.2 trả lời câu hỏi đó.
Trước khi giải, ta viết bài toán ở dạng tổng quát. Giá căn hộ còn phụ thuộc số phòng, tầng và khoảng cách tới trung tâm, nên mỗi điểm dữ liệu thường là một vector đặc trưng chứ không phải một số. Để công thức gọn, ta thêm vào mỗi một thành phần hằng bằng 1 ở vị trí đầu. Khi đó hệ số chặn trở thành trọng số ứng với thành phần này, và mô hình viết được là . Xếp các thành các hàng của ma trận và các nhãn thành vector , toàn bộ dự đoán trên tập dữ liệu là . Giáo trình dùng quy ước này ở mọi chỗ: cột đầu tiên của ma trận dữ liệu gồm toàn số 1.
Một cách tốt để nắm ký hiệu là tự kiểm tra kích thước. Với điểm dữ liệu, có hàng và cột, vector có thành phần, nên là vector chiều, cùng kích thước với , đúng như cần để so từng dự đoán với nhãn của nó. Trong ví dụ căn hộ, , , và hàng đầu tiên của là .
Định nghĩa 4.1 (Hồi quy tuyến tính bình phương tối thiểu)
Với ma trận dữ liệu và vector nhãn , hồi quy tuyến tính tìm
Phương pháp này còn gọi là bình phương tối thiểu thông thường (ordinary least squares, OLS).
Theo khung ở Hình 1, đây là đủ ba thành phần của một thuật toán học: mô hình là họ hàm tuyến tính , hàm mất mát là bình phương sai số, còn thuật toán tối ưu là cách tìm mà Mục 4.2 sẽ trình bày.
Bài toán còn có một cách hiểu hình học, sẽ dùng nhiều ở các mục sau. Khi chạy khắp , vector dự đoán chạy khắp không gian cột của (Mục 2.1). Trong ví dụ căn hộ, là một vector trong , còn không gian cột là mặt phẳng hai chiều sinh bởi và : dự đoán của mọi đường thẳng đều nằm trên mặt phẳng này. Cực tiểu nghĩa là tìm điểm trên mặt phẳng gần nhất, tức hình chiếu vuông góc của lên không gian cột. Vector phần dư vì thế phải vuông góc với mọi cột của .
4.2Phương trình chuẩn#
Ta tìm đường thẳng tốt nhất cho ví dụ căn hộ trước, rồi mới tổng quát hoá. Hàm là hàm bậc hai của hai biến và có dạng một cái chén: đi xa theo hướng nào nó cũng tăng. Đáy chén là điểm mà đạo hàm riêng theo cả hai biến đều bằng 0.
Đạo hàm theo cho
với và là trung bình của các và các . Phương trình này đã cho biết một điều cụ thể: đường thẳng tốt nhất luôn đi qua điểm trung bình của dữ liệu. Đạo hàm theo cho
Thay vào phương trình thứ hai, mỗi số hạng trong tổng trở thành , và giải ra
Ở bước cuối, thừa số đứng trước được thay bằng . Phép thay không làm đổi tử số và mẫu số, vì và .
Công thức có một cách đọc quen thuộc từ Chương 3. Chia cả tử và mẫu cho , hệ số góc chính là hiệp phương sai mẫu giữa và chia cho phương sai mẫu của ; với bốn căn hộ, đó là tỉ số ở Mục 3.3. Hệ số góc lớn khi biến thiên cùng chiều với và mạnh so với độ phân tán của .
Với bốn căn hộ, và . Các độ lệch là ; ; ; và các độ lệch là ; ; ; , nên tử số bằng và mẫu số bằng . Do đó tỉ đồng mỗi mét vuông, tức 24 triệu đồng, và . Đường thẳng này dự đoán 1,53; 2,01; 2,49 và 2,97 tỉ cho bốn căn, với sai số ; ; ; và , nhỏ hơn cả đường thứ hai ở Mục 4.1. Căn 90 m² được định giá tỉ, khớp với ước đoán bằng mắt ở đầu chương.
Hệ số chặn tỉ không có nghĩa một căn hộ 0 m² đáng giá 570 triệu đồng. Nó chỉ là điểm đường thẳng cắt trục tung, cần có để đường thẳng khớp dữ liệu trong khoảng 40 tới 100 m². Dùng mô hình cho những điểm nằm xa ngoài khoảng dữ liệu đã thấy, gọi là ngoại suy (extrapolation), luôn cần thận trọng.
Cách làm vừa rồi tổng quát hoá trực tiếp sang đặc trưng nhờ ký hiệu ma trận. Viết bình phương chuẩn thành tích vô hướng rồi khai triển như khai triển :
Hai số hạng chéo và gộp được làm một vì chúng là cùng một số: một số thực bằng chuyển vị của chính nó. Áp dụng hai quy tắc đạo hàm ở Mục 2.7, và với đối xứng, ta được
Cho gradient bằng 0:
Hệ phương trình tuyến tính này gọi là phương trình chuẩn (normal equations). Nó có đúng phương trình và ẩn, bất kể có bao nhiêu điểm dữ liệu. Với một đặc trưng, hai phương trình của nó chính là hai phương trình đạo hàm riêng ở trên.
Viết dưới dạng , phương trình chuẩn giải thích được tên gọi của nó và cho thấy nghiệm có tính chất gì. Đặt là vector phần dư. Thành phần thứ của bằng , tích vô hướng giữa cột đặc trưng thứ và phần dư. Phương trình chuẩn đòi hỏi mọi tích vô hướng này bằng 0, tức phần dư vuông góc (normal) với mọi cột của , đúng như cách hiểu hình học ở Mục 4.1. Theo cách nhìn thống kê, ở nghiệm tối ưu phần dư không còn tương quan tuyến tính với đặc trưng nào. Nếu còn, ta chưa ở điểm tốt nhất: chỉnh trọng số theo đặc trưng đó còn giảm được sai số. Riêng cột hằng số cho , nên với mọi mô hình có hệ số chặn, tổng phần dư bằng 0. Bốn sai số ; ; ; ở ví dụ căn hộ đúng là có tổng bằng 0.
Định lý 4.1 (Nghiệm của bình phương tối thiểu)
Nếu đủ hạng cột thì khả nghịch và bài toán ở Định nghĩa 4.1 có nghiệm duy nhất
Nghiệm này là cực tiểu chứ không phải cực đại hay điểm yên ngựa, vì ma trận Hessian của bằng , nửa xác định dương theo Mục 2.5. Do đó là hàm lồi và mọi điểm có gradient bằng 0 đều là cực tiểu toàn cục. Khi đủ hạng cột, Hessian xác định dương và cực tiểu là duy nhất. Chương 11 trình bày tính lồi một cách đầy đủ.
Ví dụ 4.1
Với bốn căn hộ ở đầu chương, ma trận dữ liệu và các tích cần thiết là
Định thức của là , nên
trùng với kết quả tính bằng trung bình, hiệp phương sai và phương sai ở trên.
Trên dữ liệu lớn hơn, ta có thể kiểm tra rằng các cách tính khác nhau cho cùng một nghiệm. Thí nghiệm trong code/nentang/experiments.py sinh 200 điểm với bốn hệ số thật cộng nhiễu, rồi giải bằng ba cách.
| Cách giải | ||||
|---|---|---|---|---|
| Phương trình chuẩn | 1,9906 | −1,4985 | 0,7992 | 2,9749 |
| Giả nghịch đảo Moore–Penrose | 1,9906 | −1,4985 | 0,7992 | 2,9749 |
lstsq (phân tích QR/SVD) |
1,9906 | −1,4985 | 0,7992 | 2,9749 |
Ba cách lệch nhau lớn nhất , tức bằng nhau tới sai số làm tròn của máy tính. Các hệ số ước lượng cũng gần hệ số thật, và sai lệch còn lại là do nhiễu.
Lưu ý
Công thức dùng để suy luận, không nên dùng để tính trong mã. Theo Mục 2.6, , nên lập ma trận làm mất khoảng gấp đôi số chữ số có nghĩa so với làm việc trực tiếp với . Hàm
np.linalg.lstsqgiải bài toán bằng phân tích SVD của và tránh được vấn đề này.
4.3Trường hợp ma trận suy biến#
Định lý 4.1 cần một điều kiện: đủ hạng cột, tức không cột nào biểu diễn được qua các cột còn lại. Theo Mục 2.5, đó cũng là điều kiện để khả nghịch. Trong thực tế có hai tình huống khiến điều kiện này không thoả. Tình huống thứ nhất là số đặc trưng lớn hơn số điểm dữ liệu (): hạng của không vượt quá , nên không thể đủ hạng cột. Tình huống thứ hai là có đặc trưng phụ thuộc tuyến tính vào các đặc trưng khác. Nếu bảng căn hộ có thêm cột diện tích tính bằng feet vuông, cột đó đúng bằng 10,764 lần cột diện tích tính bằng mét vuông, và dữ liệu không có cách nào tách ảnh hưởng của hai cột ra khỏi nhau. Một trường hợp hay gặp hơn là mã hoá one-hot một biến hạng mục có giá trị thành đủ cột trong khi vẫn giữ cột hằng số, vì tổng cột one-hot đúng bằng cột hằng số; cách xử lý thông thường là bỏ một cột one-hot, hoặc bỏ cột hằng số.
Thí nghiệm sau sao chép một cột của rồi thử giải.
hang cua X = 4 nhung X co 5 cot  ->  X^T X suy bien
  solve: BAO LOI 'Singular matrix'
  pinv : van cho mot nghiem, chuan ||w|| = 3.8176
  mot nghiem khac cung du bao y het: ||w|| = 4.0711 (sai so du bao lech 0.00e+00)
Dòng cuối cho thấy bản chất của trường hợp suy biến. Bài toán không vô nghiệm mà có vô số nghiệm cho cùng một dự đoán: cộng một lượng vào hệ số của cột gốc và trừ đi đúng lượng đó ở cột bản sao thì không đổi. Tập nghiệm là một đường thẳng, tổng quát là một không gian affine, trong không gian tham số.
Khi có nhiều nghiệm, ta cần một quy tắc chọn. Giả nghịch đảo Moore–Penrose chọn nghiệm có chuẩn nhỏ nhất: là nghiệm của phương trình chuẩn có nhỏ nhất trong mọi nghiệm. Trong thí nghiệm, nghiệm của pinv có chuẩn 3,8176, nhỏ hơn nghiệm khác có chuẩn 4,0711 dù hai nghiệm cho cùng dự đoán. Quy tắc này hợp lý, và Mục 9.2 sẽ cho thấy nó trùng với giới hạn của hồi quy ridge khi hệ số regularization tiến về 0 từ phía dương.
4.4Đa cộng tuyến#
Phụ thuộc tuyến tính chính xác dễ phát hiện, vì thuật toán giải báo lỗi. Khó hơn là trường hợp các cột gần phụ thuộc tuyến tính mà không phụ thuộc hẳn, như diện tích sàn xây dựng và diện tích sử dụng của một căn hộ: hai con số gần tỉ lệ với nhau nhưng không đúng tỉ lệ. Khi đó vẫn đủ hạng cột và nghiệm vẫn duy nhất, nhưng không ổn định. Hiện tượng này gọi là đa cộng tuyến (multicollinearity). Thí nghiệm sau dựng hai đặc trưng có hệ số tương quan tăng dần. Với mỗi , ma trận được giữ cố định và nhãn được sinh lại 300 lần với nhiễu khác nhau, để đo xem hệ số và dự đoán dao động bao nhiêu.
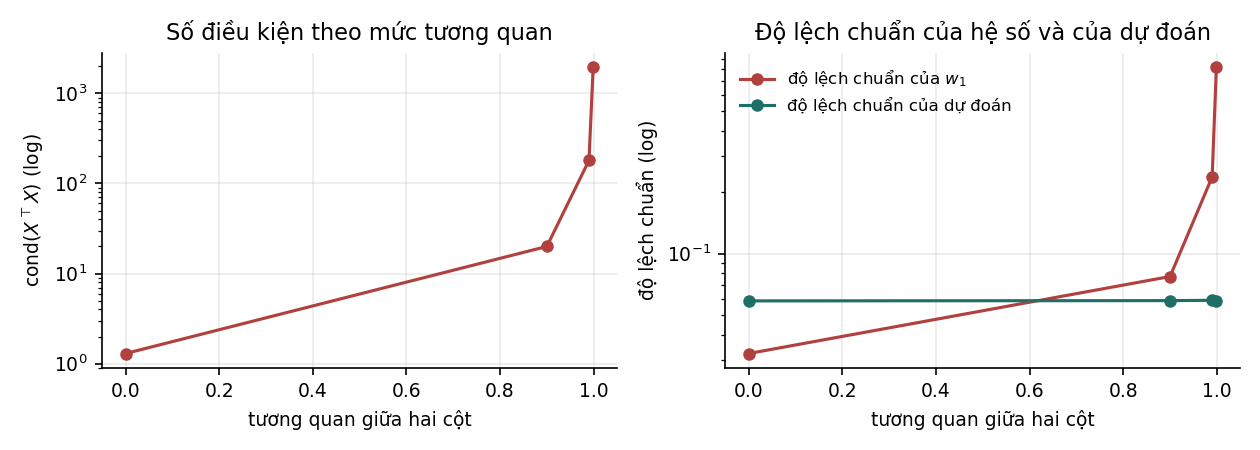
| Tương quan hai cột | Độ lệch chuẩn của | Độ lệch chuẩn của dự đoán | |
|---|---|---|---|
| 0,000 | 1,3 | 0,0324 | 0,0586 |
| 0,900 | 20,0 | 0,0772 | 0,0588 |
| 0,990 | 180,3 | 0,2373 | 0,0590 |
| 0,999 | 1958,9 | 0,8196 | 0,0585 |
Khi tương quan tăng từ 0 lên 0,999, độ lệch chuẩn của hệ số tăng khoảng 25 lần, trong khi độ lệch chuẩn của dự đoán gần như không đổi, từ 0,0586 xuống 0,0585.
Nguyên nhân nằm ở chỗ khi hai cột gần trùng nhau, dữ liệu chỉ xác định được tổng ảnh hưởng của hai đặc trưng, còn cách chia ảnh hưởng đó cho từng đặc trưng thì gần như tuỳ ý. Tổng ảnh hưởng ổn định nên dự đoán ổn định; cách chia phụ thuộc vào nhiễu nên từng hệ số dao động mạnh.
Mức tăng này có thể dự đoán bằng lý thuyết. Với mô hình có hệ số chặn, phương sai của hệ số bằng phương sai khi các đặc trưng không tương quan nhân với hệ số phóng đại phương sai (variance inflation factor)
trong đó là hệ số xác định khi hồi quy đặc trưng theo các đặc trưng còn lại. Với hai đặc trưng có tương quan thì , nên độ lệch chuẩn của hệ số tăng theo , tức khoảng 2,3; 7,1 và 22,4 lần tại ; ; . Số đo trong bảng là 2,4; 7,3 và 25,3 lần. Chênh lệch nhỏ đến từ việc mỗi hàng dùng một ma trận sinh ngẫu nhiên riêng, nên tương quan mẫu và phương sai mẫu của các cột không đúng bằng giá trị danh nghĩa.
Như vậy đa cộng tuyến là vấn đề của việc diễn giải hệ số, không phải của dự đoán. Nếu mô hình chỉ dùng để dự đoán trên dữ liệu có cùng cấu trúc tương quan, không cần xử lý gì. Nếu cần đọc hệ số để kết luận "đặc trưng này ảnh hưởng bao nhiêu", các hệ số đó không đáng tin, và cách xử lý là dùng hồi quy ridge (Chương 9), gộp các đặc trưng tương quan thành một, hoặc bỏ bớt đặc trưng. Quy tắc kinh nghiệm thường dùng là VIF lớn hơn 10 cho thấy đa cộng tuyến đáng kể.
4.5Các giả định của mô hình#
Phương pháp bình phương tối thiểu luôn cho ra một nghiệm, nhưng việc diễn giải nghiệm đó, như khoảng tin cậy của hệ số hay kiểm định ý nghĩa thống kê, dựa trên ba giả định.
Giả định đầu tiên là mô hình tuyến tính theo tham số, tức kỳ vọng của là hàm tuyến tính của . Cần chú ý là tuyến tính theo tham số chứ không nhất thiết theo đầu vào: vẫn là hồi quy tuyến tính vì nó tuyến tính theo , chỉ cần coi là một đặc trưng mới. Để kiểm tra, ta vẽ phần dư theo giá trị dự đoán; nếu thấy dạng cong có hệ thống thì giả định bị vi phạm và cần thêm đặc trưng phi tuyến. Chẳng hạn, nếu giá căn hộ tăng nhanh dần theo diện tích, một đường thẳng sẽ dự đoán thấp ở hai đầu và cao ở giữa, và đồ thị phần dư có dạng chữ U.
Giả định thứ hai là phương sai của nhiễu không đổi. Độ lớn của nhiễu thay đổi theo , hiện tượng gọi là phương sai thay đổi, rất hay gặp với dữ liệu tiền tệ: sai số dự đoán giá một căn nhà đắt lớn hơn sai số với căn nhà rẻ. Khi đó bình phương tối thiểu vẫn cho ước lượng không chệch, nhưng không còn là ước lượng có phương sai nhỏ nhất, và các khoảng tin cậy tính theo công thức chuẩn bị sai. Cách xử lý thường dùng là lấy logarit của , hoặc dùng bình phương tối thiểu có trọng số.
Giả định thứ ba là các quan sát độc lập. Dữ liệu chuỗi thời gian hầu như luôn vi phạm giả định này, vì sai số ở các thời điểm liền nhau thường tương quan.
Giả định thứ hai và thứ ba không ảnh hưởng tới giá trị của , mà ảnh hưởng tới độ tin cậy ta gán cho nó. Khi mục tiêu chỉ là dự đoán, vi phạm hai giả định này ít nghiêm trọng hơn; khi mục tiêu là suy luận thống kê về hệ số, chúng cần được kiểm tra.
4.6Tóm tắt#
Hồi quy tuyến tính chọn đường thẳng, hay tổng quát là siêu phẳng, có trung bình bình phương sai số nhỏ nhất. Với một đặc trưng, đường tốt nhất đi qua điểm trung bình của dữ liệu và có hệ số góc bằng hiệp phương sai chia phương sai; trong ví dụ căn hộ, hệ số góc là 24 triệu đồng mỗi mét vuông. Với nhiều đặc trưng, cho gradient bằng 0 được phương trình chuẩn , nói rằng phần dư vuông góc với mọi cột của , tức là hình chiếu vuông góc của lên không gian cột. Phương trình có nghiệm duy nhất khi đủ hạng cột; trong mã nên giải bằng lstsq thay vì lập , vì số điều kiện bị bình phương. Khi không đủ hạng cột, bài toán có vô số nghiệm cho cùng dự đoán, và giả nghịch đảo chọn nghiệm có chuẩn nhỏ nhất. Khi các cột gần phụ thuộc tuyến tính, hệ số dao động mạnh, gấp khoảng 25 lần ở tương quan 0,999 trong thí nghiệm, trong khi dự đoán gần như không đổi; hệ số phóng đại phương sai dự đoán được mức tăng này. Việc diễn giải hệ số còn dựa trên các giả định về tính tuyến tính, phương sai không đổi và tính độc lập của nhiễu.
Hồi quy tuyến tính giải được bằng một công thức, nhưng công thức đó đòi hỏi giải một hệ phương trình, còn hầu hết các mô hình khác không có công thức nào cả. Chương 5 trình bày phương pháp lặp được dùng cho gần như mọi mô hình học máy: gradient descent.
5Gradient descent#
Chương 4 tìm đường thẳng tốt nhất cho bốn căn hộ bằng một công thức. Phần lớn bài toán học máy không có công thức như vậy: chỉ cần đổi hàm mất mát sang cross-entropy của hồi quy logistic là phương trình "gradient bằng 0" đã không giải tường minh được nữa. Khi đó ta tìm nghiệm bằng cách đi từng bước nhỏ xuống dốc của hàm mất mát. Để thấy cách làm này vận hành ra sao, ta giải lại bài toán căn hộ như thể không biết công thức, rồi dùng chính ví dụ đó để trả lời hai câu hỏi thực tế: cần bao nhiêu bước, và làm sao biết mình đã tính gradient đúng.
5.1Lý do dùng phương pháp lặp#
Có ba lý do khiến ta dùng phương pháp lặp thay cho nghiệm dạng đóng. Lý do đầu tiên là nhiều bài toán không có nghiệm dạng đóng: cho gradient của hàm mất mát logistic bằng 0 dẫn tới một hệ phương trình phi tuyến không giải được bằng biểu thức tường minh, và mọi mạng nơ-ron cũng thuộc loại này. Lý do thứ hai là nghiệm dạng đóng có thể quá đắt. Lập và giải tốn khoảng phép tính; với đặc trưng, riêng đã vượt khả năng tính toán thông thường, trong khi một bước gradient chỉ tốn . Lý do thứ ba là dữ liệu có thể không vừa bộ nhớ, và các biến thể ngẫu nhiên của gradient descent (Mục 5.6) chỉ cần một phần nhỏ dữ liệu ở mỗi bước.
5.2Thuật toán gradient descent#
Gradient của hàm tại một điểm chỉ hướng mà tăng nhanh nhất. Muốn giảm , ta đi một bước nhỏ theo hướng ngược lại, rồi lặp lại.
Định nghĩa 5.1 (Gradient descent)
Bắt đầu từ , lặp
trong đó là tốc độ học (learning rate). Thuật toán dừng khi gradient đủ nhỏ hoặc khi đạt số vòng lặp tối đa.
Vì sao hướng ngược gradient là hướng giảm nhanh nhất? Với bước dịch chuyển nhỏ , khai triển Taylor bậc nhất cho
Trong mọi có cùng độ dài, số hạng âm nhất khi ngược hướng với , theo bất đẳng thức Cauchy–Schwarz. Lập luận này chỉ đúng cục bộ, vì xấp xỉ bậc nhất chỉ chính xác khi bước đi đủ nhỏ. Nếu quá lớn, bước đi có thể vượt qua cực tiểu và làm tăng lên.
Ta thử thuật toán trên bốn căn hộ của Chương 4. Để các con số gọn, đổi biến diện tích thành , tức độ lệch so với diện tích trung bình, tính bằng chục mét vuông; bốn căn có lần lượt là ; ; ; . Mô hình là , trong đó là phần giá tăng thêm cho mỗi 10 m². Nghiệm của Chương 4 khi đó ứng với , đúng bằng giá trung bình vì đường thẳng tốt nhất đi qua điểm trung bình, và .
Vì các có trung bình bằng 0, hàm mất mát tách được thành
Khi khai triển và lấy trung bình, các số hạng chéo giữa và có tổng bằng 0, còn trung bình của bằng 5; có thể kiểm tra tại điểm , nơi cả hai cách tính đều cho . Dạng này cho thấy ngay hình dạng của bài toán: một cái chén có đáy tại , cong theo hướng gấp 5 lần theo hướng . Gradient là
và tại nó bằng : cả hai thành phần âm, nên bước đầu tiên tăng cả lẫn .
Với , bước đầu tiên đưa từ tới , và mất mát giảm từ 5,355 xuống 3,2445. Hệ số góc đã đúng ngay sau một bước, còn hệ số chặn thì chưa. Lý do nằm ở cách mỗi bước tác động lên từng toạ độ. Thay gradient vào quy tắc cập nhật,
Mỗi bước nhân khoảng cách tới đáy theo hướng với , theo hướng với . Vì vậy tới đích sau một bước, còn đi các giá trị 0,45; 0,81; 1,098; 1,3284 và cần 35 bước mới cách 2,25 dưới 0,001.
Thử tăng tốc độ học lên thì hệ số co theo hướng tốt lên thành , nhưng theo hướng thành : nhảy qua lại giữa 0,48 và 0 mãi mãi, và thuật toán không hội tụ. Ví dụ nhỏ này chứa gần như mọi điều cần biết về tốc độ học. Mỗi hướng có độ cong co sai số theo hệ số mỗi bước, nên hội tụ khi và chỉ khi . Hướng cong nhất đặt giới hạn trên cho , còn hướng phẳng nhất quyết định thuật toán chạy chậm tới đâu. Mục 5.3 và 5.4 tổng quát hoá hai nhận xét này.
5.3Tốc độ hội tụ và số điều kiện#
Ví dụ căn hộ cho thấy khó khăn của hàm nhiều biến: mỗi hướng cần một tốc độ học riêng, mà thuật toán chỉ có một. Tốc độ học tốt nhất cân bằng hai hướng, , cho , và khi đó cả hai hướng cùng co sai số theo hệ số mỗi bước. Để thấy hệ số này phụ thuộc vào điều gì, xét hàm bậc hai hai biến
có cực tiểu tại gốc. Ma trận Hessian là , nên số điều kiện đúng bằng (Định nghĩa 2.4). Các đường mức của là elip, dẹt theo trục khi lớn. Một bước gradient descent cập nhật hai toạ độ độc lập với nhau:
Toạ độ chỉ hội tụ nếu , tức . Nhưng với nhỏ như vậy, toạ độ chỉ co lại theo hệ số mỗi bước, rất chậm. Tốc độ học tối ưu cân bằng hai hệ số co, , cho và hệ số co chung
Sai số sau bước là lần sai số ban đầu. Để giảm sai số đi lần cần bước; với , con số này là .
Một cải tiến đơn giản làm giảm đáng kể con số đó là momentum, còn gọi là phương pháp heavy ball của Polyak. Momentum cộng thêm vào bước cập nhật một phần của bước trước, . Với tham số chọn tối ưu cho hàm bậc hai, hệ số co trở thành , nên số vòng lặp chỉ còn tỉ lệ với thay vì .
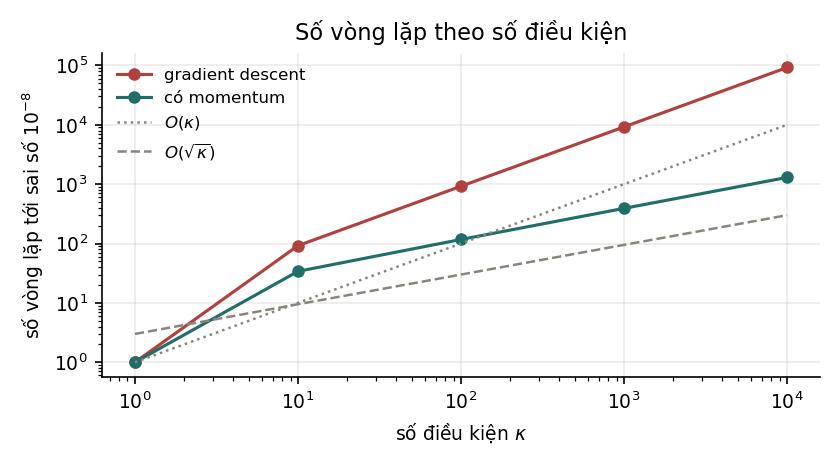
| Gradient descent | Có momentum | Tỉ số | ||
|---|---|---|---|---|
| 1 | 1 | 1 | 1,00 | 1,00 |
| 10 | 92 | 34 | 2,71 | 3,16 |
| 100 | 922 | 117 | 7,88 | 10,00 |
| 1 000 | 9 211 | 391 | 23,56 | 31,62 |
| 10 000 | 92 104 | 1 297 | 71,01 | 100,00 |
Bảng khớp với phân tích ở trên theo ba cách. Cột gradient descent tăng đúng 10 lần mỗi khi tăng 10 lần, và ở số đo 92 104 gần như trùng với ước lượng 92 103. Cột momentum tăng khoảng 3,3 lần mỗi hàng, xấp xỉ . Còn tỉ số giữa hai cột tăng theo với hệ số khoảng 0,7.
Như vậy tốc độ hội tụ của gradient descent phụ thuộc vào hình dạng của hàm mất mát, đo bằng số điều kiện, chứ không phụ thuộc vào số chiều. Một bài toán một triệu chiều có nhỏ dễ hơn nhiều một bài toán hai chiều có lớn. Với hồi quy tuyến tính, lớn thường do các đặc trưng có thang đo rất khác nhau, chẳng hạn một cột tính bằng mét và một cột tính bằng milimét, hoặc do đặc trưng không được trừ trung bình. Bốn căn hộ cho thấy mức độ của vấn đề. Nếu để diện tích nguyên đơn vị mét vuông, từ 40 tới 100, và không trừ trung bình, Hessian của hàm mất mát có hai trị riêng khoảng 10 802 và 0,185, nên . Tốc độ học khi đó phải nhỏ hơn , và theo công thức trên cần khoảng 537 000 bước để giảm sai số lần. Chỉ chia diện tích cho 100, còn khoảng 45; trừ trung bình rồi chia cho 10 như ở Mục 5.2, ; còn chia cho độ lệch chuẩn 22,36 thì , và gradient descent với tới nghiệm sau đúng một bước. Chuẩn hoá đặc trưng về cùng thang đo, như trừ trung bình rồi chia độ lệch chuẩn, vì vậy là cách rẻ nhất để giảm và tăng tốc huấn luyện.
5.4Chọn tốc độ học#
Ví dụ căn hộ ở Mục 5.2 cho thấy với hàm bậc hai, hướng có độ cong hội tụ khi và chỉ khi . Với hàm bậc hai nhiều biến, mỗi hướng riêng của Hessian có một điều kiện như vậy, và hướng khắt khe nhất là hướng có trị riêng lớn nhất:
Vượt ngưỡng này thì thuật toán chắc chắn phân kỳ theo hướng đó, không chỉ là chậm. Với bốn căn hộ, nên ngưỡng là : đúng tại ngưỡng, hệ số góc dao động mãi giữa hai giá trị như đã thấy, còn vượt ngưỡng một chút là nó phân kỳ. Với hàm không phải bậc hai, không có ngưỡng chính xác như vậy, nhưng đường cong mất mát vẫn cho biết khá rõ tốc độ học đang ở mức nào, như bảng dưới tóm tắt.
| Tốc độ học | Hiện tượng | Dấu hiệu trên đường cong mất mát |
|---|---|---|
| Quá nhỏ | hội tụ nhưng rất chậm | mất mát giảm đều và chậm, chưa phẳng khi hết số vòng lặp |
| Phù hợp | hội tụ nhanh | mất mát giảm nhanh lúc đầu rồi phẳng dần |
| Hơi lớn | dao động quanh cực tiểu | mất mát giảm rồi dao động, không phẳng hẳn |
| Quá lớn | phân kỳ | mất mát tăng, rồi thành inf hoặc nan |
Trong thực tế, ta thử các giá trị cách nhau 3 tới 10 lần, chẳng hạn 0,3; 0,1; 0,03; 0,01, chạy một số vòng lặp ngắn, rồi chọn giá trị lớn nhất mà mất mát vẫn giảm ổn định. Nhiều quy trình huấn luyện còn giảm dần tốc độ học theo thời gian. Chương 5 của Học sâu trình bày các lịch tốc độ học và các thuật toán tự điều chỉnh tốc độ học theo từng tham số như RMSProp, Adam và AdamW.
5.5Kiểm tra gradient bằng sai phân hữu hạn#
Suy ra công thức gradient bằng tay, hoặc cài đặt nó trong mã, rất dễ sai: sai dấu, thiếu hệ số, nhầm chiều ma trận. Một lỗi như vậy thường không làm chương trình báo lỗi, mà chỉ làm mô hình học kém đi một cách khó giải thích. Cách phát hiện đáng tin cậy là so sánh gradient tính bằng công thức với gradient xấp xỉ bằng sai phân hữu hạn:
Với hàm nhiều biến, ta áp dụng công thức cho từng toạ độ, mỗi lần dịch chuyển một toạ độ một lượng .
Thử trên ví dụ căn hộ tại điểm , nơi công thức cho gradient . Sai phân trung tâm với cho khoảng và , lệch khỏi công thức cỡ . Với hàm bậc hai như hàm mất mát này, sai phân trung tâm đúng tuyệt đối về mặt toán học, nên phần lệch nhỏ đó hoàn toàn do làm tròn số. Với hàm tổng quát, xấp xỉ còn mắc thêm sai số cắt cụt, và việc chọn cần cân nhắc.
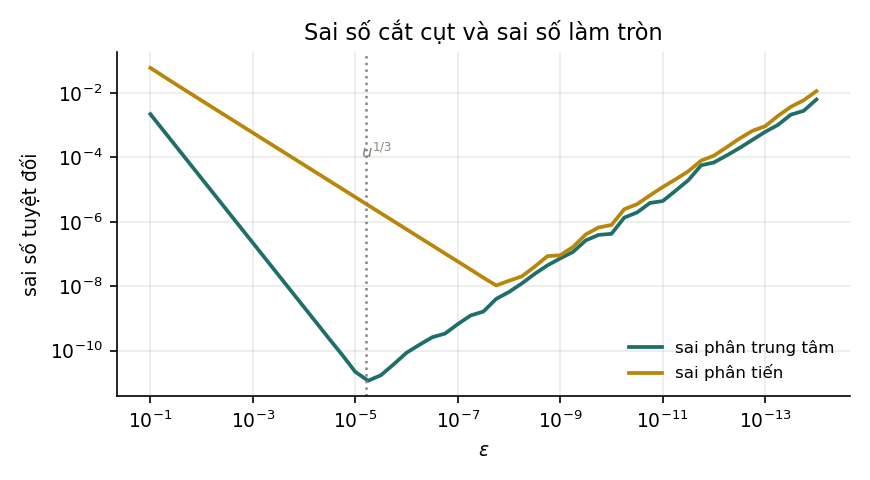
Câu hỏi là chọn bao nhiêu. Theo định nghĩa đạo hàm, càng nhỏ thì xấp xỉ càng chính xác. Trên máy tính điều đó không đúng, vì có hai nguồn sai số ngược chiều nhau.
| Sai phân trung tâm | Sai phân tiến | |
|---|---|---|
Nguồn thứ nhất là sai số cắt cụt, sinh ra do bỏ các số hạng bậc cao trong khai triển Taylor. Khai triển tới bậc ba cho thấy sai số này tỉ lệ với ở sai phân tiến và với ở sai phân trung tâm, vì các số hạng bậc chẵn triệt tiêu nhau khi lấy hiệu. Sai số này giảm khi nhỏ đi. Nguồn thứ hai là sai số làm tròn, sinh ra do mỗi giá trị chỉ được lưu với độ chính xác tương đối khoảng , tức epsilon máy của số thực 64 bit. Lấy hiệu hai số gần bằng nhau rồi chia cho khuếch đại sai số này lên cỡ , nên nó tăng khi nhỏ đi.
Tổng sai số của sai phân trung tâm có dạng . Đạo hàm theo và cho bằng 0 được điểm tối ưu . Làm tương tự với sai phân tiến, , được :
Giá trị đo được trong thí nghiệm là và , khớp với lý thuyết trong phạm vi độ mịn của lưới quét. Tại điểm tối ưu của từng cách, sai số của sai phân trung tâm xuống tới , còn sai số của sai phân tiến chỉ xuống tới khoảng , kém hơn hơn ba bậc độ lớn. Sai phân trung tâm tốn gấp đôi số lần tính , nhưng độ chính xác tăng thêm xứng đáng với chi phí đó.
Lưu ý (Quy tắc kiểm tra gradient)
Dùng sai phân trung tâm với khoảng tới khi tính bằng số thực 64 bit. So sánh bằng sai số tương đối
Sai số tương đối dưới cho thấy công thức đúng; trên gần như chắc chắn có lỗi. Không chọn với suy nghĩ nhỏ hơn là chính xác hơn: bảng trên cho thấy cho sai số lớn gấp khoảng lần so với tối ưu.
5.6Batch, stochastic và mini-batch gradient descent#
Với hàm mất mát là trung bình trên điểm dữ liệu, , gradient cũng là trung bình của gradient thành phần. Ba biến thể của gradient descent khác nhau ở số điểm dữ liệu dùng để tính gradient mỗi bước.
| Biến thể | Mỗi bước dùng | Ưu điểm | Nhược điểm |
|---|---|---|---|
| Batch gradient descent | toàn bộ điểm | gradient chính xác, đường đi trơn | mỗi bước đắt, cần toàn bộ dữ liệu trong bộ nhớ |
| Stochastic gradient descent (SGD) | 1 điểm chọn ngẫu nhiên | mỗi bước rất rẻ | gradient nhiễu lớn, đường đi dao động |
| Mini-batch gradient descent | điểm chọn ngẫu nhiên | cân bằng hai cách trên, tận dụng tính toán song song | thêm siêu tham số |
Bốn căn hộ cho thấy gradient tính trên một điểm dữ liệu có thể khác gradient đầy đủ tới mức nào. Tại , gradient tính riêng trên căn A, B, C, D lần lượt là , , và . Thành phần theo đi từ tới , thậm chí đổi dấu, nên một bước SGD có thể đi sai hướng hẳn. Nhưng trung bình của bốn vector đúng bằng gradient đầy đủ .
Gradient tính trên một mini-batch chọn ngẫu nhiên là một ước lượng không chệch của gradient đầy đủ, vì kỳ vọng của nó đúng bằng . Phương sai của ước lượng này giảm tỉ lệ với , nên tăng kích thước mini-batch làm hướng đi chính xác hơn, nhưng lợi ích giảm dần: tăng gấp 4 lần chỉ giảm độ lệch chuẩn của gradient đi 2 lần.
Vì gradient ngẫu nhiên luôn có nhiễu, SGD với tốc độ học cố định không hội tụ hẳn về cực tiểu mà dao động trong một vùng quanh nó. Muốn hội tụ, tốc độ học phải giảm dần theo thời gian. Điều kiện cổ điển của Robbins và Monro (1951) là , để đi đủ xa mà tới được cực tiểu, và , để nhiễu bị dập dần; chẳng hạn .
Mini-batch được dùng phổ biến nhất trên thực tế, chủ yếu vì lý do phần cứng: nhân một ma trận với vector trọng số tận dụng GPU tốt hơn nhiều so với phép nhân vector riêng lẻ. Nhiễu của gradient ngẫu nhiên còn có ích với các bài toán không lồi như mạng nơ-ron, vì nó giúp thuật toán thoát khỏi các điểm yên ngựa và các cực tiểu địa phương nông. Với bài toán lồi, nhiễu chỉ là thứ phải chấp nhận để đổi lấy các bước tính rẻ.
5.7Tóm tắt#
Gradient descent đi từng bước ngược hướng gradient, và tốc độ học quyết định nó hội tụ, dao động hay phân kỳ. Trên bốn căn hộ, mỗi bước nhân khoảng cách tới đáy theo một hướng với , trong đó là độ cong theo hướng đó; vì vậy với hàm bậc hai, điều kiện hội tụ là , và ở ví dụ này ngưỡng là 0,2. Số vòng lặp cần thiết tỉ lệ với số điều kiện , tăng từ 1 lên 92 104 khi tăng từ 1 lên trong thí nghiệm, còn momentum hạ con số đó xuống tỉ lệ với . Chuẩn hoá đặc trưng là cách tăng tốc rẻ nhất: với diện tích để nguyên mét vuông, bài toán căn hộ có ; sau khi chuẩn hoá, . Gradient tự tính cần được kiểm tra bằng sai phân trung tâm với cỡ tới , vì quá nhỏ làm sai số làm tròn lấn át. Mini-batch là cách dùng phổ biến nhất: gradient trên từng điểm có thể lệch hẳn hướng, nhưng trung bình của chúng không chệch, và phương sai giảm theo .
Có công cụ tối ưu cho các hàm mất mát không giải được bằng công thức, ta chuyển sang loại bài toán cần tới nó nhiều nhất: phân loại. Chương 6 dùng lại mô hình tuyến tính, thay đổi hàm mất mát, và thấy mỗi lựa chọn hàm mất mát cho một thuật toán khác nhau.
6Phân loại tuyến tính#
Chương 4 và 5 dự đoán giá căn hộ, một số thực. Phần lớn bài toán thực tế lại cần dự đoán một lớp: thư là rác hay không, giao dịch có gian lận không, sinh viên đỗ hay trượt. Ta lấy một ví dụ nhỏ để đi suốt chương: sáu sinh viên, số giờ mỗi người ôn thi và kết quả.
| Sinh viên | 1 | 2 | 3 | 4 | 5 | 6 |
|---|---|---|---|---|---|---|
| Giờ ôn | 1 | 2 | 3 | 4 | 5 | 6 |
| Kết quả | trượt | trượt | đỗ | trượt | đỗ | đỗ |
Nhìn chung ôn nhiều thì dễ đỗ hơn, nhưng sinh viên 3 ôn 3 giờ đã đỗ còn sinh viên 4 ôn 4 giờ lại trượt, nên không có ngưỡng giờ ôn nào chia đúng cả sáu người. Dữ liệu thật thường như vậy, và cách mỗi thuật toán xử lý những điểm chồng lấn như sinh viên 3 và 4 là chỗ chúng khác nhau.
Cách đơn giản nhất là dùng lại mô hình tuyến tính, nhưng lấy dấu của làm nhãn. Ba thuật toán kinh điển làm đúng như vậy: perceptron, hồi quy logistic và hồi quy softmax. Chúng dùng chung mô hình và chung cách tối ưu, chỉ khác nhau ở hàm mất mát, và chính khác biệt đó quyết định perceptron có hội tụ hay không, hồi quy logistic có cho ra xác suất hay không. Ta bắt đầu bằng việc đặt các hàm mất mát cạnh nhau.
6.1Mô hình tuyến tính và các hàm mất mát cho phân loại#
Xét bài toán phân loại hai lớp với nhãn . Một bộ phân loại tuyến tính tính điểm số rồi dự đoán lớp nếu và lớp nếu . Theo Mục 2.2, biên quyết định là một siêu phẳng. Với sáu sinh viên, một bộ phân loại tự nhiên là , tức dự đoán đỗ khi ôn hơn 3,5 giờ; nó đoán sai đúng hai người, sinh viên 3 và 4.
Định nghĩa 6.1 (Lề của một điểm)
Lề (margin) của điểm đối với bộ phân loại là
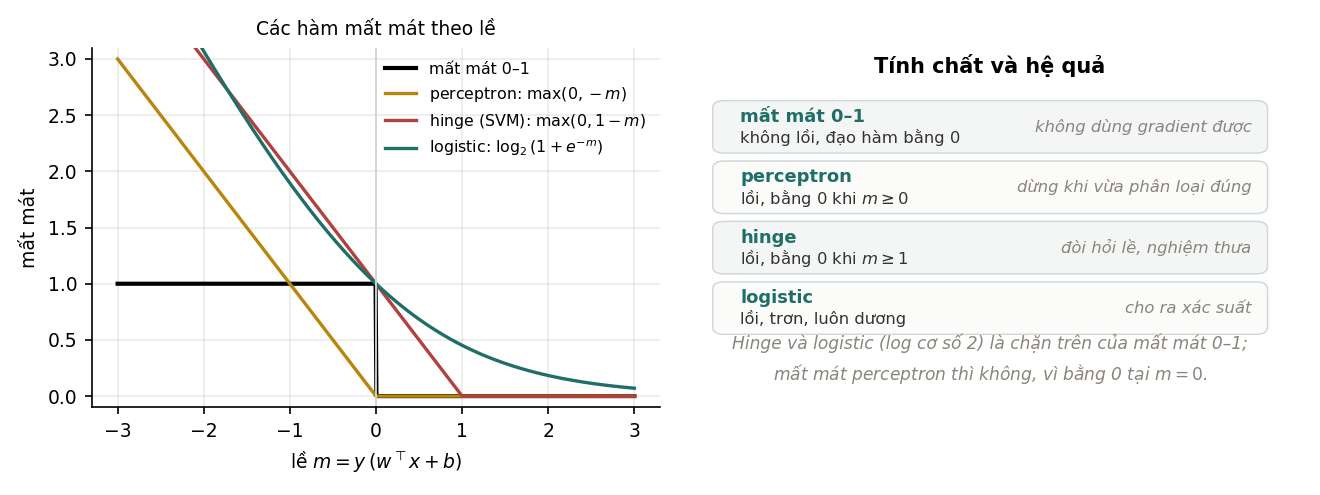
Lề dương nghĩa là điểm được phân loại đúng, lề âm nghĩa là phân loại sai, và trị tuyệt đối của lề cho biết điểm nằm xa biên quyết định tới mức nào, tỉ lệ với khoảng cách ở Định lý 2.1. Với bộ phân loại và nhãn đỗ là , trượt là , lề của sáu sinh viên là 2,5; 1,5; ; ; 1,5; 2,5. Hai người bị đoán sai có lề âm, còn hai người ở hai đầu, ôn 1 giờ và 6 giờ, nằm xa biên nhất. Mọi hàm mất mát cho phân loại hai lớp trong chương này đều viết được như một hàm của lề, như Hình 5 và bảng dưới cho thấy.
| Hàm mất mát | Công thức | Tính chất | Thuật toán tương ứng |
|---|---|---|---|
| 0–1 | không lồi, đạo hàm bằng 0 hầu khắp nơi | không tối ưu trực tiếp được | |
| Perceptron | lồi, bằng 0 khi | perceptron | |
| Hinge | lồi, bằng 0 khi | SVM (Chương 13) | |
| Logistic | lồi, trơn, luôn dương | hồi quy logistic |
Áp dụng bốn hàm mất mát cho sáu sinh viên với bộ phân loại :
| Hàm mất mát | Sinh viên 1 và 6 () | Sinh viên 2 và 5 () | Sinh viên 3 và 4 () |
|---|---|---|---|
| 0–1 | 0 | 0 | 1 |
| Perceptron | 0 | 0 | 0,5 |
| Hinge | 0 | 0 | 1,5 |
| Logistic | 0,114 | 0,291 | 1,405 |
Bảng cho thấy mỗi hàm mất mát chú ý tới ai. Perceptron chỉ phạt hai người bị đoán sai, và phạt nhẹ vì họ nằm sát biên. Hinge cũng chỉ phạt hai người đó nhưng nặng hơn, và sẽ phạt cả người được đoán đúng nếu lề của họ nhỏ hơn 1. Logistic phạt tất cả, kể cả người được đoán đúng ở xa biên, chỉ là phạt rất nhẹ: nó luôn còn lý do để đẩy các điểm ra xa biên hơn nữa.
Mất mát 0–1 đếm số điểm bị phân loại sai, đúng là thứ ta muốn giảm. Nhưng nó là hàm bậc thang: đạo hàm bằng 0 ở mọi chỗ khả vi và không tồn tại tại , nên gradient không chỉ ra hướng nào để cải thiện. Hơn nữa, bài toán cực tiểu hoá mất mát 0–1 trên một tập dữ liệu là bài toán NP-khó. Vì vậy người ta thay nó bằng một hàm thay thế lồi (convex surrogate) để có thể tối ưu bằng gradient.
Hinge và logistic viết theo logarit cơ số 2 còn là chặn trên của mất mát 0–1: với mọi , giá trị của chúng lớn hơn hoặc bằng . Do đó làm nhỏ tổng mất mát hinge hoặc logistic kéo theo làm nhỏ số điểm bị phân loại sai trên tập huấn luyện. Mất mát perceptron không có tính chất này: tại nó bằng 0 trong khi mất mát 0–1 bằng 1, và với lề âm rất nhỏ nó gần bằng 0. Đây là một cách nhìn vì sao perceptron yếu hơn hai thuật toán kia, như Mục 6.2 sẽ cho thấy bằng thí nghiệm. Dùng logarit tự nhiên thay cho cơ số 2 chỉ nhân hàm mất mát logistic với hằng số , không làm thay đổi nghiệm.
6.2Perceptron#
Perceptron (Rosenblatt, 1958) là thuật toán học đầu tiên cho bộ phân loại tuyến tính. Để đơn giản, ta gộp hệ số chặn vào bằng cách thêm thành phần hằng 1 vào như ở Chương 4.
Định nghĩa 6.2 (Thuật toán perceptron)
Khởi tạo . Lần lượt duyệt các điểm dữ liệu; mỗi khi gặp một điểm bị phân loại sai hoặc nằm đúng trên biên, tức , cập nhật
Dừng khi một lượt duyệt toàn bộ dữ liệu không có cập nhật nào.
Bước cập nhật có ý nghĩa trực quan: nếu một điểm lớp bị đoán sai, cộng vào làm tăng thêm , kéo điểm số của nó về phía dương. Quy tắc này chính là SGD trên mất mát perceptron với tốc độ học 1, vì đạo hàm của theo bằng khi và bằng 0 khi .
Với dữ liệu tách được tuyến tính, perceptron có một bảo đảm hội tụ rất gọn.
Định lý 6.1 (Novikoff, 1962)
Giả sử mọi điểm dữ liệu thoả , và tồn tại vector đơn vị sao cho với mọi (dữ liệu tách được với lề ). Khi đó perceptron thực hiện không quá lần cập nhật.
Chặn trên trong định lý không phụ thuộc số điểm dữ liệu hay số chiều , mà chỉ phụ thuộc tỉ số giữa kích thước của dữ liệu và độ rộng của lề. Thí nghiệm sinh dữ liệu tách được với lề cho trước để kiểm tra.
| Lề | Chặn | Số lần cập nhật đo được | Hội tụ | |
|---|---|---|---|---|
| 0,300 | 1,3273 | 19,5 | 4 | có |
| 0,201 | 1,2631 | 39,5 | 4 | có |
| 0,100 | 1,1703 | 136,8 | 10 | có |
| 0,050 | 1,1519 | 526,9 | 14 | có |
Ở cả bốn trường hợp, số lần cập nhật nằm dưới chặn lý thuyết, và tăng lên khi lề hẹp lại, đúng xu hướng mà định lý dự báo. Chặn khá lỏng so với số đo, điều thường gặp với các chặn trong trường hợp xấu nhất.
Trên dữ liệu không tách được tuyến tính, tình hình khác hẳn:
hoi tu = False, so lan sai sau 2000 luot = 17,977
Thuật toán không dừng. Định lý Novikoff chỉ áp dụng cho dữ liệu tách được; ngoài trường hợp đó, perceptron không có bảo đảm nào và có thể dao động mãi mãi. Nguyên nhân nhìn thấy được trên Hình 5: mất mát perceptron bằng 0 ngay khi , nên thuật toán ngừng điều chỉnh một điểm ngay khi điểm đó vừa được phân loại đúng, dù nó nằm sát biên. Khi các lớp chồng lấn, sửa một điểm sai này lại làm một điểm khác thành sai, và quá trình lặp lại không kết thúc. Sáu sinh viên là phiên bản nhỏ nhất của tình huống này: muốn đoán đúng sinh viên 3 thì ngưỡng phải dưới 3 giờ, muốn đoán đúng sinh viên 4 thì ngưỡng phải trên 4 giờ, nên mỗi lần perceptron sửa cho người này thì người kia lại sai.
6.3Hồi quy logistic#
Hồi quy logistic khắc phục hạn chế của perceptron bằng một hàm mất mát trơn và không bao giờ bằng 0. Thay vì chỉ đưa ra nhãn, mô hình đưa ra xác suất. Trong mục này ta dùng nhãn , cách viết thuận tiện hơn cho xác suất.
Định nghĩa 6.3 (Hồi quy logistic)
Mô hình hồi quy logistic cho xác suất lớp dương là
trong đó là hàm sigmoid. Tham số được học bằng cách cực tiểu hoá hàm mất mát cross-entropy
Hàm sigmoid ép mọi số thực vào khoảng , với . Nghịch đảo của nó cho một cách hiểu hệ số rất cụ thể: , tức mô hình tuyến tính đang dự đoán log tỉ lệ cược (log-odds). Tăng đặc trưng thêm một đơn vị làm log tỉ lệ cược tăng , tức nhân tỉ lệ cược với . Tên gọi "hồi quy" đến từ đây: mô hình hồi quy log tỉ lệ cược theo , dù bài toán là phân loại.
Ví dụ 6.1
Với và hệ số chặn , xác suất đỗ mà mô hình gán cho sáu sinh viên là :
Sinh viên 3 được cho 38% khả năng đỗ dù thực tế đã đỗ, sinh viên 4 được cho 62% dù đã trượt. Mỗi giờ ôn thêm nhân tỉ lệ cược đỗ với . Cross-entropy cộng cho người đỗ và cho người trượt; sáu số hạng là 0,079; 0,201; 0,974; 0,974; 0,201; 0,079, trung bình . Hai người bị đoán sai đóng góp hơn ba phần tư tổng mất mát.
Gradient của cross-entropy có dạng rất gọn. Dùng tính chất , đạo hàm của số hạng thứ theo là
Lấy trung bình trên mọi điểm, ta được
Mỗi điểm dữ liệu kéo trọng số theo hướng của chính nó, với độ mạnh bằng sai lệch giữa xác suất dự đoán và nhãn: điểm được đoán gần đúng gần như không kéo, điểm bị đoán sai kéo mạnh nhất. Ở Ví dụ 6.1, các sai lệch là 0,076; 0,182; ; 0,622; ; . Chúng có tổng bằng 0, nên đạo hàm theo hệ số chặn bằng 0, còn đạo hàm theo là . Đạo hàm âm nên tăng còn giảm được mất mát. Chạy tối ưu tới hội tụ được và hệ số chặn : biên quyết định vẫn ở 3,5 giờ, mất mát giảm còn 0,413, và mỗi giờ ôn thêm nhân tỉ lệ cược với khoảng 3,37.
Công thức có cùng dạng với gradient của hồi quy tuyến tính, : ma trận dữ liệu chuyển vị nhân với vector sai lệch giữa dự đoán và nhãn. Đây không phải trùng hợp. Mục 10.3 giải thích rằng cả hai đều là mô hình tuyến tính tổng quát với hàm liên kết chính tắc, và mọi mô hình như vậy đều có gradient dạng này.
Hàm mất mát cross-entropy của hồi quy logistic là hàm lồi theo (Mục 11.4 kiểm tra bằng số), nên gradient descent với tốc độ học phù hợp hội tụ về cực tiểu toàn cục, nếu cực tiểu đó tồn tại. Mục 6.5 trình bày trường hợp nó không tồn tại.
Lưu ý (Vì sao không dùng bình phương sai số cho phân loại)
Có hai lý do. Thứ nhất, không lồi theo , nên mất bảo đảm hội tụ về cực tiểu toàn cục. Thứ hai, khi mô hình đoán sai với độ tự tin cao, ví dụ trong khi , đạo hàm của bình phương sai số chứa thừa số nên gần như triệt tiêu, và mô hình học rất chậm từ chính những lỗi nặng nhất. Gradient của cross-entropy là , không bị triệt tiêu.
6.4Hồi quy softmax#
Khi kết quả có nhiều hơn hai mức, chẳng hạn trượt, đỗ và đỗ loại giỏi, ta có lớp. Mỗi lớp có một vector trọng số và một điểm số . Hàm softmax biến điểm số thành xác suất.
Định nghĩa 6.4 (Hồi quy softmax)
Mô hình hồi quy softmax cho
và được huấn luyện bằng cross-entropy nhiều lớp .
Softmax có một tính chất cần biết: cộng cùng một vector vào mọi không làm thay đổi xác suất, vì cả tử số và mẫu số đều nhân thêm . Do đó chỉ hiệu giữa các vector trọng số được dữ liệu xác định, còn bản thân từng vector thì không. Trên thực tế người ta cố định một vector bằng 0, hoặc thêm regularization để chọn ra một nghiệm.
Tính chất này dẫn tới một liên hệ quan trọng. Với ,
Vậy hồi quy softmax với hai lớp chính là hồi quy logistic, với vector trọng số . Thí nghiệm khớp cả hai mô hình trên cùng dữ liệu, không dùng regularization, chạy tới hội tụ:
Sai khac lon nhat giua xac suat cua logistic va cua softmax(K=2): 3.331e-16
Hieu hai cot trong so cua softmax:  [ 0.10864027  1.53215349 -1.83422929]
Trong so cua hoi quy logistic:      [ 0.10864027  1.53215349 -1.83422929]
  -> lech 1.554e-15
Tong hai cot trong so cua softmax (phai bang 0): 6.661e-16
Hai mô hình cho xác suất lệch nhau và trọng số lệch nhau , tức trùng nhau tới sai số làm tròn. Dòng cuối cho thấy thuật toán, xuất phát từ , luôn giữ tổng hai vector bằng 0, vì gradient của hai lớp luôn đối nhau.
Lưu ý (Tính softmax ổn định số học)
Khi các điểm số lớn, có thể vượt quá giới hạn của số thực dấu phẩy động. Vì cộng cùng một hằng số vào mọi điểm số không đổi kết quả, các thư viện luôn tính để số mũ lớn nhất bằng 0.
6.5Dữ liệu tách được và sự cần thiết của regularization#
Có một trường hợp hồi quy logistic không có nghiệm, và trường hợp này gặp trên thực tế nhiều hơn người ta nghĩ.
Giả sử dữ liệu tách được hoàn toàn: tồn tại sao cho mọi điểm lớp 1 có và mọi điểm lớp 0 có . Nhân với một số không đổi biên quyết định, nhưng đẩy mọi xác suất về gần 0 hoặc 1 hơn, tức gần nhãn đúng hơn, nên hàm mất mát giảm. Hàm mất mát giảm mãi khi mà không bao giờ đạt giá trị nhỏ nhất. Do đó không tồn tại nghiệm hữu hạn, và gradient descent làm tăng không giới hạn.
Sáu sinh viên cho thấy điều này bằng số. Đổi kết quả của sinh viên 3 và 4 cho nhau thì dữ liệu tách được ở ngưỡng 3,5 giờ. Giữ biên ở 3,5 giờ và tăng dần độ dốc , cross-entropy là 0,2515 ở , 0,1229 ở , 0,0431 ở và 0,0061 ở : càng dốc càng tốt, không có điểm dừng. Thí nghiệm dưới chạy gradient descent trên một tập dữ liệu tách được lớn hơn.
| Số vòng lặp | khi | khi |
|---|---|---|
| 500 | 10,164 | 3,993 |
| 2 000 | 15,930 | 3,993 |
| 10 000 | 24,703 | 3,993 |
| 50 000 | 34,784 | 3,993 |
Không có regularization, chuẩn của tăng chậm dần nhưng không có dấu hiệu dừng. Về lý thuyết, trên dữ liệu tách được, gradient descent làm tăng theo logarit của số vòng lặp, còn hướng của tiến dần tới hướng của siêu phẳng có lề lớn nhất (Soudry và cộng sự, 2018). Thêm thành phần regularization với làm hàm mất mát có cực tiểu duy nhất, và đứng yên ở 3,993 từ vòng lặp thứ 500.
Hiện tượng này có mấy hệ quả thực tế. LogisticRegression của scikit-learn mặc định dùng regularization với , trong đó là nghịch đảo của cường độ regularization, và đây là lựa chọn có chủ đích. Khi thấy hệ số hồi quy logistic lớn bất thường, nên kiểm tra xem có đặc trưng nào làm lộ nhãn không, vì dữ liệu tách được hoàn toàn thường là dấu hiệu của rò rỉ dữ liệu. Và hiện tượng tương tự xuất hiện với mạng nơ-ron phân loại, là một trong các lý do dùng weight decay (xem Chương 6 của Học sâu).
6.6Các lỗi thường gặp#
Bảng dưới gom các phát biểu sai hay gặp về phân loại tuyến tính, cùng điều đúng tương ứng.
| Phát biểu sai | Thực tế |
|---|---|
| Hồi quy logistic là thuật toán hồi quy. | Nó là thuật toán phân loại. Chữ "hồi quy" đến từ việc nó hồi quy log tỉ lệ cược theo (Mục 6.3). |
| Perceptron và SVM là hai loại mô hình khác nhau. | Cả hai dùng mô hình tuyến tính. Khác biệt nằm ở hàm mất mát: hinge bằng 0 khi thay vì , và khác biệt đó sinh ra khái niệm lề. |
| Softmax với lớp có vector trọng số độc lập. | Chỉ vector là tự do, vì cộng cùng một vector vào tất cả không đổi kết quả (Mục 6.4). |
| Xác suất do hồi quy logistic đưa ra là xác suất thật. | Chỉ đúng khi mô hình được hiệu chuẩn (calibrated) tốt. Regularization mạnh kéo xác suất về gần 0,5; lấy mẫu lại để cân bằng lớp làm xác suất lệch khỏi tỉ lệ thật. Kiểm tra bằng biểu đồ độ tin cậy (reliability diagram) và hiệu chỉnh bằng Platt scaling hoặc hồi quy isotonic trên tập xác thực. |
| Perceptron không hội tụ thì giảm tốc độ học. | Trên dữ liệu không tách được, perceptron dao động với mọi tốc độ học (khởi tạo từ 0, tốc độ học chỉ nhân với một hằng số). Vấn đề nằm ở hàm mất mát. |
6.7Tóm tắt#
Perceptron, hồi quy logistic và hồi quy softmax dùng chung mô hình tuyến tính và khác nhau ở hàm mất mát, viết được như hàm của lề . Mất mát 0–1 không tối ưu trực tiếp được, nên được thay bằng các hàm lồi; hinge và logistic là chặn trên của nó, còn mất mát perceptron thì không. Với sáu sinh viên, perceptron và hinge chỉ phạt hai người bị đoán sai, còn logistic phạt cả những người được đoán đúng nhưng chưa đủ xa biên. Perceptron hội tụ sau không quá lần cập nhật trên dữ liệu tách được, nhưng dao động mãi trên dữ liệu chồng lấn. Hồi quy logistic dự đoán log tỉ lệ cược, có gradient cùng dạng với hồi quy tuyến tính, trong đó mỗi điểm kéo trọng số theo sai lệch của chính nó; softmax hai lớp trùng với nó tới sai số làm tròn. Trên dữ liệu tách được hoàn toàn, hồi quy logistic không có nghiệm hữu hạn và cần regularization.
Cả ba thuật toán trên đều học trực tiếp một biên quyết định. Chương 7 xét hai cách tiếp cận khác: không học tham số nào mà tra cứu những điểm gần nhất, hoặc mô tả dữ liệu của từng lớp rồi suy ngược bằng định lý Bayes.
7k láng giềng gần nhất và Naive Bayes#
Cả ba thuật toán ở Chương 6 đều học trực tiếp một biên quyết định tuyến tính. Trở lại sáu sinh viên và hỏi: một người ôn 3,6 giờ có đỗ không? Có hai cách trả lời rất khác với cách của Chương 6. Cách thứ nhất không học tham số nào cả: xem những người ôn số giờ gần 3,6 nhất đã đỗ hay trượt. Cách thứ hai mô tả số giờ ôn của nhóm đỗ và của nhóm trượt trông như thế nào, rồi dùng định lý Bayes để xem người này giống nhóm nào hơn. Hai cách này lần lượt dẫn tới k láng giềng gần nhất và Naive Bayes, và cách thứ hai còn cho thấy Naive Bayes, LDA và QDA thực ra là cùng một mô hình với ba ràng buộc khác nhau.
7.1Mô hình phân biệt và mô hình sinh#
Có hai cách để xây dựng một bộ phân loại theo xác suất. Mô hình phân biệt (discriminative model) mô hình hoá trực tiếp , tức xác suất của nhãn khi đã biết đầu vào. Hồi quy logistic ở Chương 6 là ví dụ điển hình; SVM và cây quyết định cũng được xếp vào nhóm này, dù chúng học thẳng biên quyết định mà không qua xác suất. Mô hình sinh (generative model) thì mô hình hoá và , tức mô tả dữ liệu của mỗi lớp trông như thế nào và mỗi lớp phổ biến tới đâu, rồi dùng định lý Bayes để tính . Naive Bayes, LDA và QDA thuộc nhóm này. Với sáu sinh viên, hồi quy logistic mô hình hoá thẳng xác suất đỗ theo số giờ ôn; một mô hình sinh thì mô tả số giờ ôn của những người đỗ, của những người trượt và tỉ lệ đỗ chung, rồi mới suy ra xác suất đỗ. Bảng dưới đặt hai cách cạnh nhau.
| Mô hình hoá | Ví dụ | Thường phù hợp khi | |
|---|---|---|---|
| Phân biệt | hồi quy logistic, SVM, cây quyết định | nhiều dữ liệu, chỉ cần dự đoán nhãn | |
| Sinh | và | Naive Bayes, LDA, QDA | ít dữ liệu, cần sinh mẫu mới hoặc xử lý giá trị thiếu |
Mô hình sinh đặt nhiều giả định hơn về dữ liệu. Khi giả định đúng, nó cần ít dữ liệu hơn để đạt hiệu năng tốt; khi giả định sai, nó bị giới hạn bởi chính giả định đó. Ng và Jordan (2002) so sánh cặp Naive Bayes và hồi quy logistic và thấy đúng xu hướng này: Naive Bayes đạt tới mức sai số tiệm cận của nó nhanh hơn theo số mẫu, nhưng hồi quy logistic thường đạt mức sai số tiệm cận thấp hơn khi có đủ dữ liệu.
7.2Thuật toán k láng giềng gần nhất#
Định nghĩa 7.1 (k láng giềng gần nhất, k-NN)
Để phân loại một điểm mới , tìm điểm trong tập huấn luyện gần nhất theo một khoảng cách cho trước, rồi dự đoán lớp chiếm đa số trong điểm đó. Với hồi quy, dự đoán trung bình nhãn của điểm đó.
k-NN không có bước huấn luyện theo nghĩa thông thường: nó chỉ lưu lại dữ liệu. Vì vậy nó được gọi là phương pháp lười (lazy learning) và phi tham số, vì "tham số" chính là toàn bộ dữ liệu và tăng theo . Toàn bộ chi phí dồn vào lúc dự đoán: tìm láng giềng gần nhất bằng cách so với mọi điểm tốn cho mỗi truy vấn.
Với người ôn 3,6 giờ, láng giềng gần nhất là sinh viên 4, cách 0,4 giờ và đã trượt, nên 1-NN đoán trượt. Ba láng giềng gần nhất là sinh viên 4, 3 và 5, gồm hai người đỗ và một người trượt, nên 3-NN đoán đỗ; năm láng giềng gần nhất có ba người đỗ, nên 5-NN cũng đoán đỗ. Nhìn trên cả trục giờ ôn, 1-NN chia trục thành bốn đoạn: trượt dưới 2,5 giờ, đỗ từ 2,5 tới 3,5 giờ, trượt từ 3,5 tới 4,5 giờ, rồi đỗ từ 4,5 giờ trở lên. Đoạn trượt quanh 4 giờ tồn tại chỉ vì một người, sinh viên 4. Với , biên chỉ còn một điểm ở 3,5 giờ, đúng chỗ hồi quy logistic đặt biên ở Chương 6.
Chất lượng của k-NN phụ thuộc vào ba lựa chọn. Lựa chọn quan trọng nhất là số láng giềng . Với , biên quyết định bám theo từng điểm dữ liệu và rất gồ ghề: độ chệch thấp nhưng phương sai cao, vì chỉ cần một điểm nhiễu là đủ đổi dự đoán của cả vùng quanh nó, như sinh viên 4 ở trên. Tăng làm biên trơn hơn, phương sai giảm và độ chệch tăng; ở cực điểm , mọi dự đoán đều là lớp phổ biến nhất. Đây là đánh đổi độ chệch – phương sai ở dạng dễ thấy nhất, và được chọn bằng cross-validation (Mục 9.5). Lựa chọn thứ hai là khoảng cách. Khoảng cách Euclid là lựa chọn mặc định, nhưng nó chỉ có nghĩa khi các đặc trưng cùng thang đo: nếu một đặc trưng là thu nhập tính bằng đồng, cỡ hàng triệu, và một đặc trưng là tuổi, cỡ hàng chục, thì khoảng cách gần như chỉ phản ánh thu nhập. Lựa chọn thứ ba là cách bỏ phiếu: có thể cho mỗi láng giềng một phiếu như nhau, hoặc cho láng giềng gần hơn trọng số lớn hơn, chẳng hạn tỉ lệ với nghịch đảo khoảng cách.
Lưu ý
Luôn chuẩn hoá đặc trưng trước khi dùng k-NN hoặc bất kỳ phương pháp nào dựa trên khoảng cách (K-means ở Chương 15 cũng vậy). Tham số chuẩn hoá (trung bình, độ lệch chuẩn) chỉ ước lượng trên tập huấn luyện.
Dù đơn giản, k-NN có một bảo đảm lý thuyết khá mạnh. Gọi sai số Bayes là sai số nhỏ nhất mà bất kỳ bộ phân loại nào có thể đạt được trên phân phối dữ liệu.
Định lý 7.1 (Cover và Hart, 1967)
Với bài toán hai lớp, khi số điểm huấn luyện , sai số của bộ phân loại 1 láng giềng gần nhất thoả
Như vậy, với đủ dữ liệu, chỉ nhìn vào một láng giềng gần nhất đã cho sai số không quá hai lần sai số tốt nhất có thể. Nhưng "đủ dữ liệu" có thể là một lượng không tưởng khi số chiều lớn, vì một hiện tượng gọi là lời nguyền số chiều (curse of dimensionality). Giả sử dữ liệu phân bố đều trong hình lập phương đơn vị . Để một hình lập phương con quanh một điểm chứa được tỉ lệ số điểm dữ liệu, cạnh của nó phải dài . Với , tức láng giềng là 1% dữ liệu gần nhất, cạnh cần dài khi , khi và khi . Ở 100 chiều, "vùng lân cận" chứa 1% dữ liệu trải gần hết chiều dài mỗi cạnh, tức láng giềng gần nhất không còn gần theo nghĩa thông thường. Một hệ quả liên quan là ở số chiều cao, khoảng cách từ một điểm tới điểm gần nhất và tới điểm xa nhất trở nên gần bằng nhau, nên thứ hạng theo khoảng cách mang ít thông tin.
Vì vậy k-NN trên dữ liệu thô chỉ hiệu quả ở số chiều thấp. Ở số chiều cao, người ta áp dụng nó sau khi giảm chiều (Chương 14), hoặc trong một không gian embedding đã được học sao cho khoảng cách phản ánh độ giống nhau về nghĩa. Tìm kiếm ảnh, tìm kiếm văn bản theo ngữ nghĩa và bước truy xuất trong hệ thống RAG đều là k-NN trong không gian embedding, kết hợp với các chỉ mục tìm kiếm gần đúng để tránh chi phí mỗi truy vấn. Giáo trình Ứng dụng LLM trình bày các chỉ mục đó.
7.3Naive Bayes#
Theo định lý Bayes, bộ phân loại tối ưu chọn lớp có hậu nghiệm lớn nhất:
Ước lượng thì đơn giản: tỉ lệ các điểm thuộc lớp trong tập huấn luyện. Khó khăn nằm ở khi có nhiều chiều. Với đặc trưng nhị phân, một phân phối tổng quát trên cần tham số cho mỗi lớp, quá nhiều để ước lượng từ dữ liệu.
Định nghĩa 7.2 (Giả thiết Naive Bayes)
Các đặc trưng độc lập có điều kiện khi đã biết lớp:
Với giả thiết này, thay vì một phân phối chiều ta chỉ cần ước lượng phân phối một chiều cho mỗi lớp, và số tham số giảm từ cấp số mũ xuống tuyến tính theo . Mỗi phân phối một chiều có thể là Bernoulli với đặc trưng nhị phân, như từ có xuất hiện trong thư hay không, là đa thức với số lần xuất hiện của từ, hoặc là Gauss với đặc trưng liên tục.
Cần chú ý chữ "có điều kiện". Giả thiết không nói các đặc trưng độc lập với nhau, mà nói chúng độc lập khi đã biết lớp. Trong một thư rác, từ "miễn phí" và từ "khuyến mãi" hay cùng xuất hiện, tức không độc lập; Naive Bayes giả định rằng trong riêng nhóm thư rác, biết thư có "miễn phí" không cho thêm thông tin gì về việc có "khuyến mãi". Giả thiết này gần như luôn sai với dữ liệu thật. Tuy vậy Naive Bayes vẫn thường phân loại tốt, vì để chọn đúng nhãn chỉ cần thứ tự của các đúng, không cần giá trị của chúng đúng. Ngược lại, các xác suất do Naive Bayes đưa ra thường bị đẩy về gần 0 hoặc 1 quá mức, vì những bằng chứng tương quan với nhau bị đếm nhiều lần như thể độc lập, nên không nên dùng đầu ra của nó như xác suất đã hiệu chuẩn.
Ví dụ 7.1 (Lọc thư rác với hai từ)
Tập huấn luyện có 4 thư rác và 6 thư thường. Từ "miễn phí" xuất hiện trong 3 thư rác và 1 thư thường; từ "cuộc họp" xuất hiện trong 0 thư rác và 4 thư thường. Dùng mô hình Bernoulli và ước lượng mỗi xác suất bằng tần suất:
Mô hình Bernoulli tính cả những từ vắng mặt: thư không chứa "cuộc họp" nhận thừa số . Một thư mới chỉ chứa "miễn phí" mà không chứa "cuộc họp". Điểm của lớp rác là , điểm của lớp thường là , nên . Một thư khác chứa cả hai từ thì điểm của lớp rác là , và .
Kết quả thứ hai không ổn. Vì Naive Bayes nhân các xác suất, một thừa số bằng 0 làm cả tích bằng 0: mọi thư chứa "cuộc họp" sẽ có xác suất là rác bằng đúng 0, bất kể nó chứa bao nhiêu từ đáng ngờ khác, chỉ vì "cuộc họp" chưa từng xuất hiện trong 4 thư rác của tập huấn luyện. Một từ chưa từng gặp trong một lớp đủ để phủ quyết mọi bằng chứng còn lại. Cách khắc phục là cộng thêm một lượng nhỏ vào mọi ô đếm. Với đặc trưng rời rạc có giá trị,
trong đó là số lần đặc trưng nhận giá trị trong lớp , và là số điểm của lớp . Với ta có làm trơn Laplace; với , cách làm gọi là làm trơn Lidstone. Mục 10.4 chỉ ra rằng công thức này là một ước lượng MAP với tiên nghiệm Dirichlet.
Tính lại Ví dụ 7.1 với ; mỗi từ là đặc trưng nhị phân nên :
Với thư chứa cả hai từ, điểm của lớp rác giờ là và điểm của lớp thường là . Chuẩn hoá, : thư được xếp là thư thường, nhưng bằng chứng từ "miễn phí" vẫn được tính. Với thư chỉ chứa "miễn phí", điểm của hai lớp là và , cho thay vì 0,9: sau khi làm trơn, các ước lượng bớt cực đoan hơn.
Lưu ý (Tính trong không gian logarit)
Tích của hàng nghìn xác suất nhỏ nhanh chóng nhỏ hơn số dương nhỏ nhất biểu diễn được bằng số thực dấu phẩy động và bị làm tròn về 0. Các cài đặt thực tế luôn cộng logarit thay vì nhân xác suất: .
7.4Naive Bayes, LDA và QDA#
Khi đặc trưng liên tục, lựa chọn tự nhiên cho là phân phối Gauss nhiều chiều . Mô hình này gọi chung là phân tích biệt thức Gauss (Gaussian discriminant analysis). Ba thuật toán quen thuộc là ba cách ràng buộc các ma trận hiệp phương sai , như bảng dưới cho thấy.
| Mô hình | Ràng buộc trên | Biên quyết định | Độ chính xác đo được |
|---|---|---|---|
| Naive Bayes Gauss | riêng từng lớp, đường chéo | bậc hai | 0,8550 |
| LDA (Linear Discriminant Analysis) | dùng chung cho mọi lớp, đầy đủ | tuyến tính | 0,8550 |
| QDA (Quadratic Discriminant Analysis) | riêng từng lớp, đầy đủ | bậc hai | 0,8600 |
| Naive Bayes, đường chéo dùng chung | dùng chung, đường chéo | tuyến tính | 0,8550 |
Dòng đầu thể hiện ý chính của mục này: với đặc trưng Gauss, giả thiết độc lập có điều kiện của Naive Bayes tương đương với việc ép thành ma trận đường chéo. Lý do là một phân phối Gauss nhiều chiều có ma trận hiệp phương sai đường chéo phân tích được thành tích các phân phối Gauss một chiều, và ngược lại. Naive Bayes Gauss vì vậy không phải một thuật toán riêng biệt, mà là bộ phân loại Gauss với một ràng buộc cụ thể.
Thí nghiệm kiểm tra điều này bằng hai cài đặt độc lập: một bên nhân các mật độ Gauss một chiều lại với nhau đúng như định nghĩa Naive Bayes, không đụng tới ma trận hiệp phương sai; một bên dùng mật độ Gauss nhiều chiều với đường chéo.
sai khac lon nhat cua hieu diem phan biet: 1.222e-08
hai mo hinh du bao giong nhau o 100.0% so mau
ham quyet dinh cua LDA co TUYEN TINH khong? sai so khop tuyen tinh = 4.441e-15  -> co
con QDA thi sao? sai so khop tuyen tinh = 1.780e+01 -> khong, no bac hai
Hai cài đặt cho hàm phân biệt lệch nhau , giới hạn bởi lượng nhỏ thêm vào đường chéo để nghịch đảo ma trận ổn định, và dự đoán trùng nhau trên 100% số mẫu.
Hai dòng cuối kiểm chứng một kết quả lý thuyết. Viết logarit tỉ số hậu nghiệm của hai lớp:
Khai triển hai dạng toàn phương, số hạng bậc hai theo là . Nếu hai lớp dùng chung ma trận hiệp phương sai, , số hạng này triệt tiêu và phần còn lại tuyến tính theo :
Vì vậy LDA có biên quyết định tuyến tính: trong thí nghiệm, khớp hàm quyết định của LDA bằng một hàm tuyến tính cho sai số . Khi mỗi lớp có ma trận riêng, số hạng bậc hai còn lại và biên là mặt bậc hai: khớp tuyến tính cho sai số 17,8.
Công thức trên còn cho thấy hậu nghiệm của LDA có dạng , đúng dạng của hồi quy logistic. Hai phương pháp cho ra cùng họ hàm nhưng ước lượng tham số theo hai cách: LDA ước lượng và rồi suy ra , còn hồi quy logistic tối ưu trực tiếp trên . Khi dữ liệu đúng là Gauss với chung, LDA dùng dữ liệu hiệu quả hơn; khi giả định sai, hồi quy logistic thường bền vững hơn. Đây là một trường hợp cụ thể của so sánh giữa mô hình sinh và mô hình phân biệt ở Mục 7.1.
Sáu sinh viên cho thấy khác biệt đó bằng số. Gọi đỗ là lớp 1 và trượt là lớp 0. Với một đặc trưng là số giờ ôn, trung bình của nhóm trượt là giờ, của nhóm đỗ là giờ, và phương sai chung ước lượng bằng hợp lý cực đại là . Ở một chiều, hệ số của trong công thức trên là . Hằng số là , cộng thêm với là tỉ lệ của lớp , ở đây bằng 0 vì hai nhóm đông như nhau. Vậy log tỉ lệ cược của LDA là . Biên quyết định nằm ở 3,5 giờ, trùng với hồi quy logistic ở Chương 6, nhưng độ dốc 1,5 lớn hơn độ dốc 1,214 của hồi quy logistic: với người ôn 3 giờ, LDA cho xác suất đỗ 0,321, còn hồi quy logistic cho 0,353. Hai nhóm ở đây tình cờ có cùng phương sai , nên QDA cho đúng kết quả của LDA; và với một đặc trưng duy nhất, ma trận hiệp phương sai nào cũng là đường chéo, nên Naive Bayes Gauss cũng cho cùng kết quả.
Về chi phí, QDA cần ước lượng ma trận hiệp phương sai, mỗi ma trận có tham số, trong khi LDA chỉ cần một ma trận. Với và , QDA cần khoảng 50 000 tham số cho các ma trận hiệp phương sai, LDA cần khoảng 5 000 và Naive Bayes Gauss chỉ cần 1 000. Khi nhỏ, QDA dễ overfitting và ma trận ước lượng có thể suy biến.
7.5Tóm tắt#
Mô hình phân biệt học trực tiếp , còn mô hình sinh học và rồi suy ngược bằng định lý Bayes; mô hình sinh cần ít dữ liệu hơn khi giả định đúng nhưng bị giới hạn khi giả định sai. k-NN không học tham số mà tra cứu các điểm gần nhất: với sáu sinh viên, 1-NN tạo ra một đoạn trượt quanh 4 giờ chỉ vì một người, còn 3-NN cho lại biên 3,5 giờ. Nó cần chuẩn hoá đặc trưng, chọn theo đánh đổi độ chệch – phương sai, và mất tác dụng ở số chiều cao vì lời nguyền số chiều. Naive Bayes giả định các đặc trưng độc lập khi đã biết lớp, nên chỉ cần ước lượng các phân phối một chiều; nó vẫn phân loại tốt dù giả định sai, nhưng cho xác suất quá tự tin, và nếu không làm trơn Laplace thì một số đếm bằng 0 đủ để phủ quyết mọi bằng chứng khác. Với đặc trưng Gauss, Naive Bayes, LDA và QDA là cùng một mô hình với ba ràng buộc trên ma trận hiệp phương sai, và ma trận dùng chung làm biên của LDA tuyến tính; trên sáu sinh viên, LDA đặt biên ở đúng chỗ hồi quy logistic đặt, chỉ khác độ dốc.
Đến đây ta đã có năm bộ phân loại. Câu hỏi tự nhiên tiếp theo là làm sao so sánh chúng, và câu hỏi đó khó hơn vẻ ngoài: Ví dụ 3.3 đã cho thấy một xét nghiệm "đúng 99%" có thể sai ở 5 trên 6 ca dương tính. Chương 8 bàn về cách đánh giá một mô hình phân loại.
8Đánh giá mô hình phân loại#
Một mô hình chỉ tốt hay xấu so với một thước đo, và chọn sai thước đo thì so sánh mô hình cũng sai theo. Ta dùng một ví dụ nhỏ suốt chương: trong 1 000 giao dịch thẻ có 50 giao dịch gian lận, và một mô hình đánh dấu 60 giao dịch là đáng ngờ, trong đó 40 giao dịch đúng là gian lận. Mô hình này tốt tới đâu? Thước đo quen thuộc nhất là độ chính xác, và nó đặc biệt dễ đánh lừa khi lớp cần quan tâm là lớp hiếm, mà trong thực tế lớp cần quan tâm thường là lớp hiếm: giao dịch gian lận, thiết bị sắp hỏng, bệnh hiếm gặp. Ta bắt đầu bằng việc xem độ chính xác nói gì về mô hình này và che đi điều gì, rồi xây dựng các thước đo thay thế, và kết thúc bằng những lỗi chia dữ liệu làm mọi thước đo mất ý nghĩa.
8.1Hạn chế của độ chính xác#
Độ chính xác (accuracy) là tỉ lệ điểm được phân loại đúng. Mô hình trong ví dụ bỏ sót 10 vụ gian lận và đánh dấu nhầm 20 giao dịch hợp lệ, nên phân loại đúng 970 giao dịch, độ chính xác . Một mô hình không làm gì cả, luôn trả lời "không gian lận", phân loại đúng cả 950 giao dịch hợp lệ và đạt . Một bên phát hiện được 40 trong 50 vụ gian lận, bên kia không phát hiện được vụ nào, vậy mà độ chính xác của hai bên chỉ chênh nhau 2 điểm phần trăm. Thước đo này dễ hiểu nhưng có một điểm yếu lớn: nó không phân biệt các loại lỗi. Bỏ sót một vụ gian lận và chặn nhầm một giao dịch hợp lệ đều chỉ là một lỗi, và khi lớp dương chỉ chiếm 5%, đoán âm cho tất cả đã đúng 95%.
Khi lớp dương còn hiếm hơn, điểm yếu này đủ để đảo ngược kết luận.
Thí nghiệm dựng 20 000 điểm dữ liệu, trong đó 0,98% thuộc lớp dương, và một bộ phân loại cho điểm số cao hơn một chút với lớp dương. Bảng dưới so sánh bộ phân loại này ở ba ngưỡng với một bộ phân loại luôn đoán lớp âm.
| Bộ phân loại | Độ chính xác | Precision | Recall | F1 |
|---|---|---|---|---|
| Luôn đoán lớp âm | 0,9902 | không xác định | 0,0000 | 0,0000 |
| Ngưỡng 2,6 | 0,9900 | 0,4928 | 0,5204 | 0,5062 |
| Ngưỡng 1,0 | 0,8408 | 0,0559 | 0,9592 | 0,1056 |
| Ngưỡng −1,0 | 0,1699 | 0,0117 | 1,0000 | 0,0231 |
Bộ phân loại luôn đoán lớp âm không phát hiện được ca dương nào, nhưng có độ chính xác 0,9902, cao hơn bộ phân loại ở ngưỡng 2,6 (0,9900) vốn phát hiện được hơn một nửa số ca dương. Nếu chọn mô hình theo độ chính xác, ta sẽ chọn mô hình vô dụng. Muốn phân biệt hai mô hình này, thước đo phải tách được các loại lỗi khác nhau, và việc tách đó bắt đầu từ ma trận nhầm lẫn.
8.2Ma trận nhầm lẫn, precision và recall#
Với bài toán hai lớp, mỗi dự đoán rơi vào một trong bốn ô, tuỳ theo nhãn thật và nhãn dự đoán. Coi gian lận là lớp dương, bốn ô của ví dụ giao dịch là:
| Dự đoán dương | Dự đoán âm | |
|---|---|---|
| Thật sự dương | TP (dương thật) = 40 | FN (âm giả) = 10 |
| Thật sự âm | FP (dương giả) = 20 | TN (âm thật) = 930 |
Bảng này gọi là ma trận nhầm lẫn (confusion matrix), và các thước đo phổ biến đều tính từ bốn ô của nó. Độ chính xác chỉ dùng tổng hai ô trên đường chéo, , nên không biết 30 lỗi còn lại nằm ở ô nào. Các thước đo dưới đây nhìn vào từng ô.
Định nghĩa 8.1 (Precision, recall, F1)
Recall còn gọi là độ nhạy (sensitivity) hoặc tỉ lệ dương thật (true positive rate, TPR). Tỉ lệ dương giả (false positive rate) là .
Người mới hay nhầm precision với recall. Cách nhớ đúng bản chất là đặt mỗi thước đo thành một câu hỏi. Precision trả lời câu hỏi: trong những trường hợp mô hình báo là dương, bao nhiêu phần đúng là dương? Mẫu số của nó là những gì mô hình khẳng định. Recall trả lời câu hỏi: trong những trường hợp thật sự dương, mô hình phát hiện được bao nhiêu phần? Mẫu số của nó là những gì thực tế có.
Ví dụ 8.1
Trên 1 000 giao dịch có 50 giao dịch gian lận, mô hình ở trên cho TP = 40, FN = 10, FP = 20, TN = 930. Precision : hai phần ba số giao dịch bị đánh dấu đúng là gian lận. Recall : mô hình phát hiện được bốn phần năm số vụ gian lận. Từ hai số đó, . Mô hình luôn đoán "không gian lận" có recall bằng 0 và precision không xác định, vì nó không đánh dấu giao dịch nào. Độ chính xác 0,97 và 0,95 gần như không phân biệt được hai mô hình, còn recall 0,80 và 0 thì tách hẳn chúng ra.
Precision và recall đánh đổi nhau qua ngưỡng quyết định. Muốn bắt nốt 10 vụ gian lận còn sót trong ví dụ giao dịch, ta phải hạ ngưỡng, và ngưỡng thấp hơn cũng đánh dấu thêm những giao dịch hợp lệ có điểm số cao. Bảng ở Mục 8.1 cho thấy khi hạ ngưỡng từ 2,6 xuống 1,0 rồi −1,0, recall tăng từ 0,52 lên 0,96 rồi 1,00, còn precision giảm từ 0,49 xuống 0,056 rồi 0,012. Không có ngưỡng nào tốt nhất cho cả hai, và chọn ngưỡng là một quyết định dựa trên chi phí của từng loại lỗi: bỏ sót một ca gian lận tốn bao nhiêu so với chặn nhầm một giao dịch hợp lệ.
là trung bình điều hoà của precision và recall. Trung bình điều hoà bị kéo mạnh về phía giá trị nhỏ hơn, nên chỉ cao khi cả hai cùng cao: ở ngưỡng −1,0, recall bằng 1,00 nhưng chỉ bằng 0,023. Khi hai loại lỗi có chi phí khác nhau, ta dùng dạng tổng quát
trong đó coi recall quan trọng hơn precision, như trong sàng lọc bệnh, còn coi precision quan trọng hơn. Ở ví dụ giao dịch, recall 0,80 cao hơn precision 0,667, nên cao hơn , còn thấp hơn: cùng một mô hình được chấm cao hơn khi người dùng coi trọng việc không bỏ sót.
8.3Đường cong ROC và đường cong precision–recall#
Mỗi ngưỡng cho một cặp giá trị thước đo. Để đánh giá mô hình mà không phụ thuộc vào một ngưỡng cụ thể, ta quét mọi ngưỡng và vẽ đường cong. Đường cong ROC vẽ TPR (recall) theo FPR khi ngưỡng thay đổi. Diện tích dưới đường cong, ROC-AUC, bằng xác suất một điểm dương chọn ngẫu nhiên được mô hình cho điểm số cao hơn một điểm âm chọn ngẫu nhiên; bộ phân loại ngẫu nhiên có ROC-AUC bằng 0,5, bộ phân loại hoàn hảo có ROC-AUC bằng 1.
Ví dụ 8.2 (ROC-AUC của sáu sinh viên)
Ở Ví dụ 6.1, hồi quy logistic cho ba người đỗ các xác suất 0,378; 0,818; 0,924 và cho ba người trượt 0,076; 0,182; 0,622. Ghép mỗi người đỗ với mỗi người trượt được 9 cặp. Người đỗ được cho điểm cao hơn ở 8 cặp; cặp duy nhất bị xếp ngược là sinh viên 3 (0,378) với sinh viên 4 (0,622). Vậy ROC-AUC . Quét ngưỡng từ cao xuống thấp cũng ra con số đó: hai người đầu danh sách đều đỗ nên TPR lên 2/3 trong khi FPR vẫn bằng 0; người thứ ba trượt nên FPR lên 1/3; người thứ tư đỗ nên TPR lên 1; hai người cuối trượt. Diện tích dưới đường bậc thang này là .
ROC-AUC chỉ phụ thuộc vào thứ tự của các điểm số chứ không phụ thuộc vào giá trị của chúng: mô hình tối ưu ở Mục 6.3, với độ dốc 1,214, xếp sáu sinh viên theo đúng thứ tự trên nên cũng có ROC-AUC bằng 8/9.
Đường cong precision–recall (PR) vẽ precision theo recall, và diện tích dưới nó, PR-AUC, thường tính bằng average precision. PR-AUC của bộ phân loại ngẫu nhiên bằng tỉ lệ lớp dương trong dữ liệu. Với sáu sinh viên, average precision lấy trung bình precision tại vị trí của từng người đỗ trong danh sách xếp theo điểm số, tức 1, 1 và 3/4, được 0,917, so với mốc 0,5 vì một nửa số sinh viên đỗ.
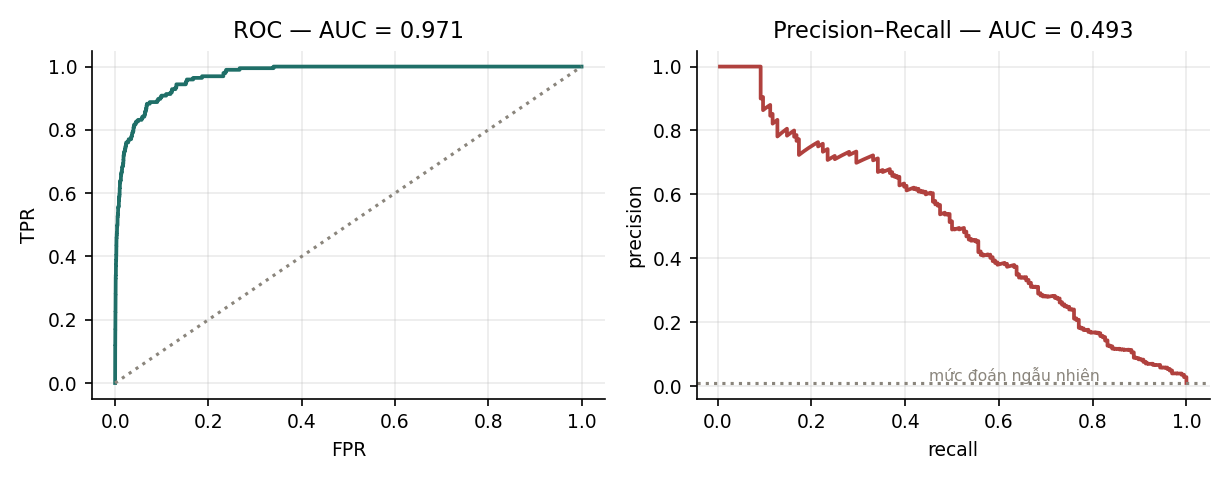
Trên dữ liệu của Mục 8.1, hai con số này là
Chúng chênh nhau nhiều vì mẫu số của FPR là toàn bộ lớp âm:
Ví dụ giao dịch cho thấy cơ chế này ở quy mô nhỏ. Ở đó . Thêm 20 dương giả nữa, FPR chỉ tăng lên , một bước dịch nhỏ trên trục hoành của đồ thị ROC, nhưng precision giảm từ xuống . Lớp âm trong thí nghiệm có 19 804 điểm, nên thêm 100 dương giả chỉ làm FPR tăng khoảng 0,005, gần như không thấy trên đồ thị ROC. Cũng 100 dương giả đó có thể làm precision giảm mạnh, vì mẫu số của precision chỉ gồm những điểm được báo là dương, và số điểm này nhỏ.
Để đọc đúng hai con số, cần so với mốc của bộ phân loại ngẫu nhiên. ROC-AUC = 0,9715 được so với mốc 0,5. PR-AUC = 0,4931 được so với mốc bằng tỉ lệ lớp dương, tức 0,0100: mô hình tốt hơn đoán ngẫu nhiên khoảng 49 lần, nhưng vẫn còn nhiều dương giả so với số ca dương thật.
Từ đó có thể chọn thước đo theo bài toán. Khi hai lớp tương đối cân bằng và cả hai đều quan trọng, ROC-AUC là thước đo phù hợp. Khi lớp dương hiếm và điều cần quan tâm là chất lượng của các cảnh báo dương, PR-AUC phản ánh thực tế tốt hơn, vì ROC-AUC có thể rất cao trong khi phần lớn cảnh báo là sai (Davis và Goadrich, 2006; Saito và Rehmsmeier, 2015).
8.4Đánh giá bài toán nhiều lớp#
Với lớp, precision, recall và F1 được tính cho từng lớp theo cách "lớp đó so với tất cả các lớp còn lại", rồi gộp lại theo một trong ba cách trong bảng dưới.
| Cách gộp | Tính thế nào | Khi nào dùng |
|---|---|---|
| Macro | tính thước đo cho từng lớp rồi lấy trung bình không trọng số | mọi lớp quan trọng như nhau, kể cả lớp hiếm |
| Micro | cộng dồn TP, FP, FN của mọi lớp rồi tính một lần | quan tâm hiệu năng tổng thể; lớp đông chi phối kết quả |
| Weighted | trung bình có trọng số theo số điểm của mỗi lớp | cân bằng giữa hai cách trên, nhưng che khuất lớp hiếm |
Trở lại ba mức kết quả ở Mục 6.4: trượt, đỗ và đỗ loại giỏi, gọi tắt là giỏi. Một mô hình phân loại 100 sinh viên, trong đó 20 người trượt, 70 người đỗ và 10 người giỏi, cho ma trận nhầm lẫn dưới đây; mỗi hàng là kết quả thật, mỗi cột là dự đoán.
| Dự đoán trượt | Dự đoán đỗ | Dự đoán giỏi | |
|---|---|---|---|
| Thật sự trượt | 14 | 6 | 0 |
| Thật sự đỗ | 5 | 62 | 3 |
| Thật sự giỏi | 0 | 6 | 4 |
Mô hình đúng ở người, độ chính xác 0,80. Tính precision, recall và F1 cho từng lớp theo cách lớp đó so với phần còn lại, chẳng hạn precision của lớp trượt là 14 người trượt thật trong 19 người bị đoán trượt:
| Lớp | Precision | Recall | F1 |
|---|---|---|---|
| Trượt | 14/19 = 0,737 | 14/20 = 0,700 | 0,718 |
| Đỗ | 62/74 = 0,838 | 62/70 = 0,886 | 0,861 |
| Giỏi | 4/7 = 0,571 | 4/10 = 0,400 | 0,471 |
Lớp giỏi chỉ được nhận ra 4 trong 10 người. Macro-F1 là trung bình không trọng số của cột F1, bằng 0,683, và bị lớp giỏi kéo xuống. Weighted-F1 lấy trọng số theo số người của mỗi lớp, 20, 70 và 10, nên bằng 0,793, sát độ chính xác và gần như không cho thấy lớp giỏi đang bị bỏ sót. Micro-F1 cộng dồn ba lớp được 80 dương thật, 20 dương giả và 20 âm giả, nên bằng 80/100 = 0,80, đúng bằng độ chính xác.
Sự trùng nhau cuối cùng không phải ngẫu nhiên. Với bài toán phân loại đơn nhãn nhiều lớp, tức mỗi điểm thuộc đúng một lớp, micro-F1 bằng đúng độ chính xác. Lý do là mỗi dự đoán sai đồng thời là một dương giả của lớp được dự đoán và một âm giả của lớp thật, nên tổng FP bằng tổng FN, kéo theo micro-precision bằng micro-recall bằng tỉ lệ dự đoán đúng. Báo cáo micro-F1 cho bài toán đơn nhãn vì vậy không cung cấp thêm thông tin gì so với độ chính xác.
8.5Chia dữ liệu và rò rỉ dữ liệu#
Mọi thước đo ở chương này chỉ có ý nghĩa nếu tập kiểm tra phản ánh đúng dữ liệu mà mô hình sẽ gặp khi sử dụng. Rò rỉ dữ liệu (data leakage) là khi thông tin không có ở thời điểm dự đoán lọt vào quá trình huấn luyện, làm kết quả đánh giá tốt hơn thực tế. Có ba dạng rò rỉ hay gặp nhất.
Dạng thứ nhất là chuẩn hoá trước khi chia dữ liệu. Tính trung bình và độ lệch chuẩn trên toàn bộ dữ liệu rồi mới chia tập là đã đưa thông tin của tập kiểm tra vào tập huấn luyện. Với bốn căn hộ ở Chương 4, nếu giữ căn 100 m² làm dữ liệu kiểm tra thì trung bình dùng để chuẩn hoá phải tính trên ba căn còn lại, bằng 60 m², chứ không phải 70 m² của cả bốn căn. Mọi bước tiền xử lý có tham số, như chuẩn hoá, điền giá trị thiếu hay chọn đặc trưng, chỉ được khớp trên tập huấn luyện, rồi áp dụng nguyên vẹn cho tập kiểm tra.
Dạng thứ hai là chia ngẫu nhiên dữ liệu có yếu tố thời gian. Với bài toán dự báo, mô hình chỉ được dùng quá khứ để dự đoán tương lai, nhưng chia ngẫu nhiên cho phép nó học từ các điểm nằm sau thời điểm cần dự đoán. Cách đúng là chia theo thời gian: huấn luyện trên giai đoạn trước, kiểm tra trên giai đoạn sau. Một mô hình phát hiện gian lận sẽ chạy trên giao dịch của tháng tới cần được kiểm tra trên một tháng nằm sau toàn bộ dữ liệu huấn luyện, vì kiểu gian lận thay đổi theo thời gian.
Dạng thứ ba là chia ngẫu nhiên khi dữ liệu có nhóm. Nếu một bệnh nhân có nhiều lần khám, một chủ thẻ có nhiều giao dịch, hoặc một người dùng có nhiều phiên, các bản ghi của cùng một người rất giống nhau. Chia ngẫu nhiên theo bản ghi khiến mô hình được kiểm tra trên chính những người nó đã thấy, nên cần chia theo nhóm, tức theo bệnh nhân, theo chủ thẻ hay theo người dùng.
Cả ba lỗi làm kết quả đánh giá tốt lên giả tạo, và thường chỉ bị phát hiện khi mô hình đã được đưa vào sử dụng. Chương 4 của MLOps trình bày cách bảo đảm đặc trưng được tính đúng theo thời điểm để tránh dạng rò rỉ thứ hai.
8.6Tóm tắt#
Độ chính xác không phân biệt các loại lỗi: trên 1 000 giao dịch có 50 vụ gian lận, một mô hình phát hiện được 40 vụ chỉ hơn mô hình không làm gì 2 điểm phần trăm, và trên dữ liệu có 0,98% lớp dương, mô hình luôn đoán lớp âm còn đạt độ chính xác cao hơn một mô hình phát hiện được nửa số ca dương. Ma trận nhầm lẫn tách bốn loại kết quả; precision hỏi trong những gì mô hình báo dương bao nhiêu là đúng, còn recall hỏi trong những gì thật sự dương mô hình phát hiện được bao nhiêu, và hai thước đo đánh đổi nhau qua ngưỡng. ROC-AUC là xác suất một điểm dương được xếp trên một điểm âm, bằng 8/9 với sáu sinh viên, và chỉ phụ thuộc vào thứ tự điểm số. Nó có thể rất cao trên dữ liệu mất cân bằng, như 0,9715 so với PR-AUC 0,4931 trong thí nghiệm, vì mẫu số của FPR là toàn bộ lớp âm; khi lớp dương hiếm, PR-AUC phản ánh thực tế tốt hơn. Với nhiều lớp, macro-F1 làm lộ ra lớp hiếm bị bỏ sót, weighted-F1 che nó đi, còn micro-F1 của bài toán đơn nhãn chỉ là độ chính xác. Mọi con số chỉ có ý nghĩa khi dữ liệu được chia đúng, không rò rỉ qua chuẩn hoá, thời gian hay nhóm.
Thước đo đúng cho biết mô hình tốt tới đâu trên dữ liệu mới. Chương 9 xét lý do một mô hình có thể rất tốt trên dữ liệu huấn luyện mà kém trên dữ liệu mới, và cách kiểm soát điều đó.
9Overfitting và regularization#
Chương 8 nhấn mạnh việc đo trên dữ liệu mà mô hình chưa thấy. Lý do của yêu cầu đó là hiện tượng quan trọng nhất của học máy: một mô hình có thể khớp dữ liệu huấn luyện rất tốt mà vẫn dự đoán dữ liệu mới rất tệ. Bốn căn hộ của Chương 4 đủ để thấy điều này. Đường thẳng ở Chương 4 có sai số huấn luyện 0,0045; một đa thức bậc ba đi qua đúng cả bốn căn nên có sai số huấn luyện bằng 0, nhưng lại đoán một căn 20 m² có giá 0 đồng. Ta gọi tên hiện tượng đó trước, rồi xét công cụ chính để kiểm soát nó là regularization. Hồi quy tuyến tính một lần nữa là nơi thấy cơ chế rõ nhất, vì ridge và lasso đều phân tích được chính xác, và trên bốn căn hộ chúng tính được bằng tay. Cuối cùng là câu hỏi chọn cường độ regularization, và câu trả lời là cross-validation.
9.1Overfitting và underfitting#
Định nghĩa 9.1 (Overfitting, underfitting)
Mô hình bị overfitting (quá khớp) khi nó khớp tốt dữ liệu huấn luyện nhưng dự đoán kém trên dữ liệu mới: sai số huấn luyện nhỏ, sai số trên tập xác thực lớn hơn nhiều. Mô hình bị underfitting (chưa khớp) khi nó quá đơn giản để nắm được quan hệ trong dữ liệu: cả sai số huấn luyện lẫn sai số xác thực đều lớn.
Ví dụ 9.1 (Đa thức bậc ba qua bốn căn hộ)
Dùng lại biến của Mục 5.2, bốn căn hộ có và giá 1,5; 2,1; 2,4; 3,0 tỉ. Đa thức bậc ba có bốn hệ số, đủ để đi qua đúng bốn điểm; giải hệ bốn phương trình được
Sai số huấn luyện bằng 0. Với căn 120 m², tức , đa thức dự đoán 4,5 tỉ, còn đường thẳng của Chương 4 dự đoán 3,45 tỉ. Với căn 20 m², tức , đa thức dự đoán đúng 0 đồng, và với căn 10 m² nó cho giá âm, tỉ.
Đa thức bậc ba khớp cả phần nhiễu trong bốn mức giá, và vì vậy nó rất nhạy với nhiễu. Tăng giá căn 80 m² thêm 0,1 tỉ, dự đoán của đường thẳng cho căn 120 m² chỉ đổi 0,05 tỉ, từ 3,45 lên 3,5, còn dự đoán của đa thức bậc ba đổi 0,6 tỉ, từ 4,5 xuống 3,9.
Ví dụ kinh điển cho thấy cùng hiện tượng với nhiều điểm hơn: khớp đa thức vào 10 điểm dữ liệu có nhiễu sinh từ một đường cong trơn. Đa thức bậc 1 là đường thẳng, không theo được độ cong, nên underfitting. Đa thức bậc 3 theo được hình dạng chung mà bỏ qua nhiễu. Đa thức bậc 9 có đủ 10 hệ số để đi qua chính xác mọi điểm, kể cả phần nhiễu, và dao động mạnh giữa các điểm: sai số huấn luyện bằng 0 nhưng dự đoán ở các điểm mới rất tệ.
Theo ngôn ngữ của Mục 3.6, overfitting là tình trạng phương sai cao: mô hình thay đổi nhiều khi tập huấn luyện thay đổi, như đa thức bậc ba ở trên, vì nó đủ linh hoạt để khớp cả nhiễu của từng tập. Underfitting là tình trạng độ chệch cao: dù có bao nhiêu dữ liệu, mô hình vẫn sai theo cùng một cách vì họ hàm của nó không chứa quan hệ thật. Chương 2 của Học sâu trình bày phân tích độ chệch – phương sai đầy đủ và đo từng thành phần trên dữ liệu.
Cách chẩn đoán thông dụng là so sánh sai số trên tập huấn luyện và tập xác thực, như bảng dưới.
| Sai số huấn luyện | Sai số xác thực | Chẩn đoán | Hướng xử lý |
|---|---|---|---|
| lớn | lớn, gần sai số huấn luyện | underfitting | mô hình linh hoạt hơn, thêm đặc trưng, giảm regularization |
| nhỏ | lớn hơn nhiều | overfitting | thêm dữ liệu, mô hình đơn giản hơn, tăng regularization |
| nhỏ | nhỏ, gần sai số huấn luyện | phù hợp |
Regularization là cách xử lý overfitting mà không cần đổi họ mô hình: giữ nguyên mô hình, nhưng thêm vào hàm mất mát một thành phần phạt các tham số lớn, để mô hình ưu tiên các nghiệm "đơn giản" hơn.
9.2Hồi quy ridge#
Định nghĩa 9.2 (Hồi quy ridge)
Hồi quy ridge thêm thành phần phạt bình phương chuẩn của trọng số vào bình phương tối thiểu:
Cho gradient bằng 0 được nghiệm
Gradient của thành phần phạt là (Mục 2.7), nên phương trình chuẩn chỉ thay đổi một chỗ: được cộng thêm . Thay đổi nhỏ này có ba tác dụng. Trước hết, ridge luôn có nghiệm duy nhất: theo Mục 2.5, xác định dương với mọi , kể cả khi không đủ hạng cột, nên ridge giải được cả những bài toán mà bình phương tối thiểu thông thường không có nghiệm duy nhất, như hoặc đặc trưng trùng lặp (Mục 4.3). Tiếp theo, số điều kiện được cải thiện: trị riêng của là , nên số điều kiện giảm từ xuống , và gradient descent trên hàm mất mát ridge hội tụ nhanh hơn (Mục 5.3). Cuối cùng, ridge co các hệ số về phía 0, qua đó giảm phương sai của ước lượng; Mục 9.3 chỉ ra việc co này diễn ra không đều giữa các hướng.
Khi , nghiệm ridge tiến tới nghiệm có chuẩn nhỏ nhất của bình phương tối thiểu, tức nghiệm của giả nghịch đảo ở Mục 4.3. Khi , mọi hệ số tiến về 0.
Bốn căn hộ cho thấy sự co này bằng số. Với biến , ta có và . Không phạt hệ số chặn, phương trình chuẩn của ridge cho độ dốc theo là
Với ta được lại độ dốc 0,24 của Chương 5; với , độ dốc giảm một nửa còn 0,12; độ dốc chỉ tiến về 0 khi . Hệ số chặn vẫn là giá trung bình 2,25 tỉ, vì có trung bình bằng 0.
Lưu ý
Thành phần phạt phụ thuộc vào thang đo của các đặc trưng: một đặc trưng đo bằng milimét có hệ số nhỏ hơn 1 000 lần so với khi đo bằng mét, nên bị phạt ít hơn hẳn. Vì vậy cần chuẩn hoá đặc trưng trước khi dùng ridge hoặc lasso. Ngoài ra, hệ số chặn thường không bị phạt, vì dịch toàn bộ đi một hằng số không nên làm thay đổi mô hình.
9.3Hồi quy ridge nhìn qua SVD#
Để thấy ridge co các hệ số như thế nào, ta viết dưới dạng SVD, (Mục 2.6), với , là các cột của , và là các giá trị suy biến. Thay vào công thức nghiệm và rút gọn, ta được
So sánh từng số hạng, ridge nhân thành phần theo hướng của nghiệm bình phương tối thiểu với hệ số co
Với bốn căn hộ, khi hệ số chặn không bị phạt và có trung bình 0, phần bị phạt chỉ gồm một cột , nên chỉ có một giá trị suy biến, . Hệ số co là , đúng tỉ lệ giữa độ dốc ridge ở Mục 9.2 và độ dốc 0,24 của bình phương tối thiểu. Với nhiều đặc trưng, mỗi hướng có một hệ số co riêng.
Thí nghiệm dùng 80 điểm dữ liệu với 12 đặc trưng và ; nghiệm tính qua SVD khớp với nghiệm dạng đóng tới . Bảng liệt kê năm trong mười hai giá trị suy biến, gồm hai lớn nhất, một ở giữa và hai nhỏ nhất, cùng hệ số co tương ứng.
| Giá trị suy biến | Hệ số co |
|---|---|
| 12,2680 | 0,9377 |
| 12,0678 | 0,9357 |
| 8,3651 | 0,8750 |
| 6,4450 | 0,8060 |
| 6,1730 | 0,7921 |
Hướng có giá trị suy biến lớn gần như giữ nguyên; hướng có giá trị suy biến nhỏ bị co mạnh hơn. Giá trị suy biến nhỏ nghĩa là dữ liệu trải rất ít theo hướng đó, nên dữ liệu cung cấp ít thông tin về thành phần của theo hướng đó, và ước lượng bình phương tối thiểu có phương sai lớn, vì chia cho số nhỏ khuếch đại nhiễu. Ridge co mạnh nhất đúng những hướng ước lượng kém tin cậy nhất. Đây cũng là mối liên hệ với Mục 4.4: đa cộng tuyến tạo ra giá trị suy biến rất nhỏ, và ridge là một cách xử lý đa cộng tuyến.
Tổng các hệ số co, , gọi là số bậc tự do hiệu dụng của mô hình ridge. Nó bằng số đặc trưng khi và giảm dần về 0 khi tăng, cho một cách đo độ phức tạp của mô hình liên tục theo (Hastie, Tibshirani và Friedman, 2009).
9.4Lasso#
Định nghĩa 9.3 (Lasso)
Lasso (Tibshirani, 1996) dùng chuẩn trong thành phần phạt:
Hệ số trước bình phương sai số là quy ước thường dùng cho lasso, và cũng là quy ước của thư viện scikit-learn sau khi nhân hàm mục tiêu của thư viện với ; nó chỉ làm thay đổi thang đo của . Khác với ridge, lasso không có nghiệm dạng đóng tổng quát và được giải bằng các thuật toán lặp như coordinate descent.
Đổi thành nghe như một thay đổi nhỏ, nhưng hành vi của nghiệm khác hẳn, như Hình 7 cho thấy.
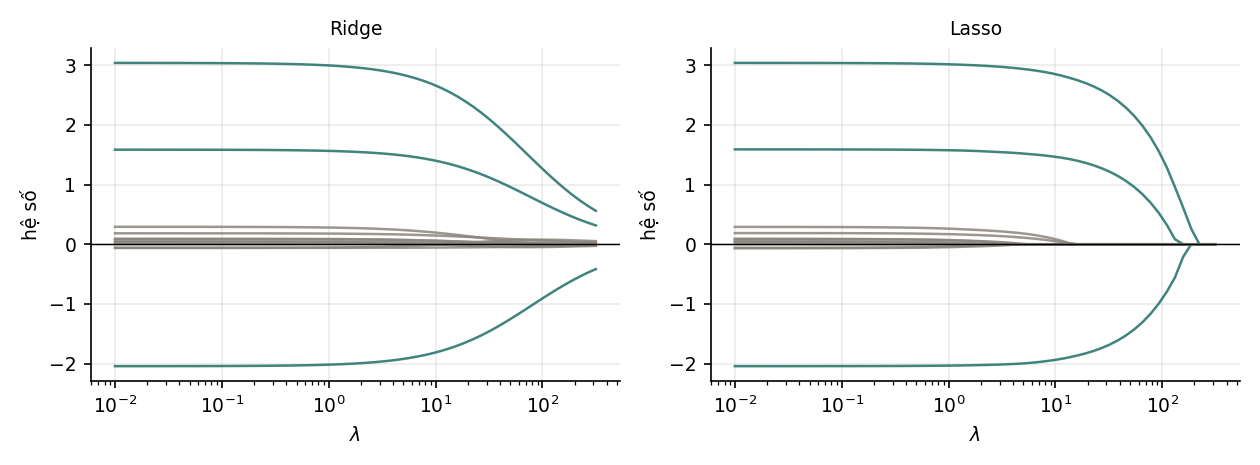
Thí nghiệm dùng dữ liệu 80 điểm, 12 đặc trưng, trong đó mô hình sinh dữ liệu chỉ có 3 hệ số khác 0 và 9 hệ số bằng 0.
| của ridge | Số hệ số bằng 0, ridge | Số hệ số bằng 0, lasso | |
|---|---|---|---|
| 0,01 | 4,0106 | 0 | 0 |
| 0,10 | 4,0056 | 0 | 1 |
| 1,00 | 3,9559 | 0 | 1 |
| 10,00 | 3,5234 | 0 | 7 |
| 100,00 | 1,7090 | 0 | 9 |
Ở , lasso đưa đúng 9 hệ số về 0, trùng với 9 hệ số bằng 0 của mô hình thật. Ridge không đưa hệ số nào về 0 ở bất kỳ giá trị nào, dù chuẩn của vector trọng số giảm dần.
Có hai cách giải thích vì sao lasso cho nghiệm thưa, tức nhiều hệ số bằng đúng 0. Cách thứ nhất là giải tích. Xét trường hợp đơn giản các cột của trực chuẩn, , và gọi là nghiệm bình phương tối thiểu của hệ số thứ . Bài toán tách thành từng toạ độ, và nghiệm là
Ridge nhân mọi hệ số với cùng một số nhỏ hơn 1, nên hệ số nào khác 0 vẫn khác 0. Lasso trừ mỗi hệ số đi một lượng và cắt về 0 những hệ số có trị tuyệt đối nhỏ hơn ; phép toán này gọi là ngưỡng mềm (soft thresholding). Nguồn gốc của khác biệt nằm ở đạo hàm. Đạo hàm của là , tiến về 0 khi tiến về 0, nên lực kéo về 0 yếu dần và không bao giờ kéo được tới đúng 0. Còn không khả vi tại 0, và dưới vi phân của nó tại 0 là cả đoạn ; muốn một hệ số rời khỏi 0, gradient của phần bình phương sai số phải lớn hơn , nếu không thì hệ số nằm yên ở 0.
Bốn căn hộ cho thấy hai công thức này bằng số. Cột có chứ không bằng 1, và . Cùng lập luận cho độ dốc ridge như ở Mục 9.2, và độ dốc lasso
Ngưỡng 4,8 chính là độ lớn gradient của phần bình phương sai số tại độ dốc bằng 0. Với , lasso cho độ dốc 0,12, bằng độ dốc ridge ở . Với mọi , lasso cho độ dốc đúng bằng 0: mô hình bỏ hẳn diện tích và đoán mọi căn hộ có giá 2,25 tỉ. Ridge không có giá trị hữu hạn nào cho độ dốc bằng 0.
Cách thứ hai là hình học. Bài toán có phạt tương đương với cực tiểu bình phương sai số trong một quả cầu chuẩn có bán kính phụ thuộc . Các đường mức của bình phương sai số là những elip quanh nghiệm bình phương tối thiểu, và nghiệm có ràng buộc là điểm đầu tiên elip chạm vào quả cầu. Quả cầu tròn nên điểm chạm thường nằm ở vị trí bất kỳ. Quả cầu là hình thoi có các đỉnh nhọn nằm trên trục toạ độ (Mục 2.3), nên elip hay chạm vào đúng các đỉnh, nơi một số toạ độ bằng 0.
Từ đó có thể chọn giữa hai phương pháp. Khi cần chọn đặc trưng, hoặc khi tin rằng chỉ một số ít đặc trưng thật sự có ảnh hưởng, nên dùng lasso. Khi nhiều đặc trưng đều có ảnh hưởng nhỏ, hoặc có các nhóm đặc trưng tương quan cao, nên dùng ridge. Với một nhóm đặc trưng tương quan cao, lasso có xu hướng chọn một đặc trưng đại diện và đưa các đặc trưng còn lại về 0, và đặc trưng được chọn phụ thuộc vào nhiễu. Elastic net (Zou và Hastie, 2005) kết hợp cả hai thành phần phạt, , để vừa cho nghiệm thưa vừa giữ ổn định với các nhóm đặc trưng tương quan.
9.5Cross-validation#
Cường độ regularization không thể học từ tập huấn luyện: tăng luôn làm sai số huấn luyện tăng, nên cực tiểu sai số huấn luyện luôn chọn . Ta cần ước lượng sai số trên dữ liệu mới cho từng giá trị rồi chọn giá trị tốt nhất. Nếu dữ liệu nhiều, một tập xác thực riêng là đủ. Nếu dữ liệu ít, giữ riêng một phần lớn cho xác thực làm lãng phí dữ liệu huấn luyện, và kết quả phụ thuộc nhiều vào cách chia. Cross-validation giải quyết vấn đề này.
Định nghĩa 9.4 (k-fold cross-validation)
Chia dữ liệu thành phần có kích thước gần bằng nhau. Lần lượt với : huấn luyện mô hình trên phần, đo sai số trên phần thứ . Ước lượng cross-validation là trung bình của sai số đó.
Mỗi điểm dữ liệu được dùng để đánh giá đúng một lần và để huấn luyện lần. Để chọn , ta tính ước lượng cross-validation cho mỗi giá trị trong một lưới, chẳng hạn , chọn giá trị cho sai số nhỏ nhất, rồi huấn luyện lại trên toàn bộ dữ liệu với giá trị đó. Cùng cách làm chọn được cả bậc của đa thức.
Ví dụ 9.2 (Leave-one-out trên bốn căn hộ)
Lấy : mỗi lần bỏ ra một căn, khớp mô hình trên ba căn còn lại rồi dự đoán căn bị bỏ ra. Ta so sánh đường thẳng với đa thức bậc hai. Trên cả bốn căn, hai mô hình có cùng sai số huấn luyện 0,0045, vì hệ số bậc hai khớp được bằng 0.
Căn bị bỏ ra Giá thật Đường thẳng dự đoán Đa thức bậc hai dự đoán 40 m² 1,5 1,600 2,100 60 m² 2,1 1,971 1,900 80 m² 2,4 2,529 2,600 100 m² 3,0 2,900 2,400 Trung bình bình phương sai số 0,0133 0,2000 Với ba điểm, đa thức bậc hai đi qua đúng cả ba và cong mạnh ở hai đầu, nên đoán sai 0,6 tỉ cho căn nhỏ nhất và căn lớn nhất.
Sai số huấn luyện không phân biệt được hai mô hình, còn cross-validation cho thấy đường thẳng tốt hơn khoảng 15 lần. Trường hợp như trên gọi là leave-one-out; bảng dưới liệt kê nó cùng các biến thể thường dùng khác.
| Biến thể | Dùng khi |
|---|---|
| k-fold với hoặc 10 | lựa chọn mặc định |
| Stratified k-fold | phân loại, nhất là khi lớp mất cân bằng: giữ tỉ lệ các lớp trong mỗi phần |
| Leave-one-out () | dữ liệu rất ít; tốn lần huấn luyện và ước lượng có phương sai cao |
| Chia theo thời gian | chuỗi thời gian: luôn huấn luyện trên quá khứ, đánh giá trên tương lai |
| Chia theo nhóm | dữ liệu có nhóm tự nhiên như bệnh nhân hay người dùng (Mục 8.5) |
Khi nhiều giá trị cho sai số cross-validation gần như nhau, một quy tắc thường dùng là quy tắc một độ lệch chuẩn: chọn mô hình đơn giản nhất, tức regularization mạnh nhất, có sai số không vượt quá sai số nhỏ nhất cộng một độ lệch chuẩn của ước lượng.
Lưu ý
Không dùng cùng một vòng cross-validation vừa để chọn siêu tham số vừa để báo cáo hiệu năng cuối cùng. Vì cấu hình được chọn là cấu hình tốt nhất trên chính các phần dữ liệu đó, sai số báo cáo sẽ lạc quan một cách có hệ thống, và càng thử nhiều cấu hình thì càng lạc quan. Cách đúng là dùng cross-validation lồng nhau (vòng trong chọn siêu tham số, vòng ngoài đánh giá), hoặc giữ riêng một tập kiểm tra chỉ dùng một lần ở bước cuối cùng.
9.6Tóm tắt#
Overfitting là khi mô hình khớp cả nhiễu của dữ liệu huấn luyện, tức phương sai cao: đa thức bậc ba đi qua đúng bốn căn hộ nhưng đoán căn 20 m² có giá 0 đồng, và chỉ 0,1 tỉ nhiễu ở một căn làm dự đoán của nó đổi 0,6 tỉ. Underfitting là khi họ hàm quá hẹp, tức độ chệch cao; so sánh sai số huấn luyện với sai số xác thực cho biết đang ở tình huống nào. Ridge cộng vào , nên luôn có nghiệm duy nhất, cải thiện số điều kiện, và nhân thành phần theo mỗi hướng với , co mạnh nhất những hướng có giá trị suy biến nhỏ, nơi ước lượng kém tin cậy nhất. Lasso dùng chuẩn nên cho nghiệm thưa: với bốn căn hộ, độ dốc lasso bằng đúng 0 khi , còn độ dốc ridge không bao giờ bằng 0; trong thí nghiệm 12 đặc trưng, lasso đưa đúng 9 hệ số về 0 như mô hình thật. Cường độ regularization, cũng như bậc của mô hình, được chọn bằng cross-validation, và hiệu năng cuối cùng phải được báo cáo trên dữ liệu không tham gia vào việc chọn.
Ridge thêm , lasso thêm , Naive Bayes cộng vào mọi ô đếm. Tới đây, các thành phần phạt này trông như những mẹo có tác dụng. Chương 10 cho thấy chúng, cùng với bình phương sai số và cross-entropy, đều suy ra được từ hai nguyên lý thống kê.
10Ước lượng hợp lý cực đại và hậu nghiệm cực đại#
Đến đây ta đã dùng khá nhiều hàm mất mát và thành phần phạt: bình phương sai số, cross-entropy, phạt , phạt , làm trơn Laplace. Nhìn riêng lẻ, chúng giống một danh sách lựa chọn phải ghi nhớ, và câu hỏi "vì sao là bình phương mà không phải trị tuyệt đối" ở Mục 4.1 vẫn còn treo đó; con số 1 cộng vào mỗi ô đếm khi làm trơn Laplace ở Mục 7.3 cũng chưa có lý do. Thực ra phần lớn chúng suy ra được từ hai nguyên lý thống kê: ước lượng hợp lý cực đại cho ra hàm mất mát, còn ước lượng hậu nghiệm cực đại cho thêm thành phần regularization. Khi đã thấy điều này, câu hỏi "dùng hàm mất mát nào" được thay bằng một câu hỏi dễ trả lời hơn: dữ liệu có nhiễu dạng gì.
10.1Mô hình xác suất và hàm mất mát#
Ý tưởng chung của chương là mô tả quá trình sinh ra dữ liệu bằng một mô hình xác suất có tham số , rồi chọn làm dữ liệu quan sát được trở nên "hợp lý" nhất. Mỗi giả thiết về phân phối của nhiễu hay của nhãn sẽ cho ra một hàm mất mát cụ thể, như các mục sau lần lượt chỉ ra.
Ví dụ nhỏ nhất là một từ trong thư rác. Ở Ví dụ 7.1, từ "miễn phí" xuất hiện trong 3 trên 4 thư rác. Giả sử mỗi thư rác chứa từ này với cùng một xác suất , độc lập với nhau. Xác suất để thấy đúng dữ liệu đã thấy, ba thư có từ và một thư không có, là . Với xác suất này là 0,0625, với là 0,105, với là 0,073. Giá trị làm dữ liệu quan sát được hợp lý nhất trong ba giá trị, và nó đúng bằng tần suất 3/4 mà Mục 7.3 đã dùng.
10.2Ước lượng hợp lý cực đại#
Định nghĩa 10.1 (Hàm hợp lý, MLE)
Cho mô hình xác suất và dữ liệu độc lập . Hàm hợp lý (likelihood) là xác suất của dữ liệu quan sát được, xem như hàm của tham số:
Ước lượng hợp lý cực đại (maximum likelihood estimation, MLE) là tham số làm hàm hợp lý lớn nhất.
Tích của nhiều xác suất khó tối ưu và dễ bị làm tròn về 0 khi tính bằng máy. Vì logarit là hàm đồng biến, cực đại tương đương cực đại , và tương đương cực tiểu âm logarit của nó:
Đại lượng đóng vai trò hàm mất mát của điểm thứ , và bài toán có đúng dạng của Định nghĩa 1.1. Với từ "miễn phí", âm log hợp lý là . Cho đạo hàm bằng 0 được , nên giá trị 0,75 ở Mục 10.1 là tốt nhất trong mọi giá trị của , chứ không riêng ba giá trị đã thử. Cùng phép tính với thư có từ trong thư cho : tần suất là ước lượng hợp lý cực đại.
Định lý 10.1 (Nhiễu Gauss cho bình phương tối thiểu)
Giả sử với độc lập. Khi đó ước lượng hợp lý cực đại của trùng với nghiệm bình phương tối thiểu.
Chứng minh
Theo giả thiết, , nên
Số hạng thứ hai không phụ thuộc , còn hệ số dương không đổi vị trí cực tiểu. Do đó cực tiểu tổng theo tương đương cực tiểu .
Định lý trả lời câu hỏi đã nêu ở Mục 4.1: bình phương sai số không phải một lựa chọn tuỳ ý, mà là hệ quả của giả thiết nhiễu Gauss. Cực tiểu theo cho thêm ước lượng , và giống Ví dụ 3.4, ước lượng hợp lý cực đại này có chệch: mẫu số không chệch là . Với bốn căn hộ, đường thẳng của Chương 4 chính là ước lượng hợp lý cực đại dưới nhiễu Gauss, và là sai số huấn luyện 0,0045, tức độ lệch chuẩn của nhiễu khoảng 0,067 tỉ. Mẫu số không chệch là , cho ước lượng 0,009, gấp đôi.
Đổi giả thiết về nhiễu thì đổi hàm mất mát. Nếu nhiễu có phân phối Laplace, , thì , và MLE trở thành hồi quy trị tuyệt đối (least absolute deviations). Phân phối Laplace có đuôi dày hơn Gauss, tức coi các sai số lớn là bình thường hơn, nên hồi quy trị tuyệt đối ít bị ảnh hưởng bởi điểm ngoại lai hơn bình phương tối thiểu. Một điểm ngoại lai có sai số 10 đóng góp 100 vào bình phương sai số nhưng chỉ đóng góp 10 vào tổng trị tuyệt đối. Trên bốn căn hộ, hồi quy trị tuyệt đối cho đường , khá gần đường bình phương tối thiểu . Thêm một căn thứ năm, 70 m², bị ghi nhầm giá thành 4,0 tỉ. Căn này nằm đúng ở diện tích trung bình, nên nó kéo cả đường bình phương tối thiểu lên 0,35 tỉ mà không đổi độ dốc: hệ số chặn từ 0,57 thành 0,92. Đường hồi quy trị tuyệt đối thì không đổi chút nào.
10.3Cross-entropy là hợp lý cực đại với phân phối Bernoulli#
Với phân loại hai lớp, nhãn được mô hình như một biến Bernoulli có xác suất thành công :
Lấy âm logarit, ta được
Vế phải đúng là số hạng của hàm mất mát cross-entropy ở Mục 6.3. Với sáu sinh viên ở Ví dụ 6.1, và hệ số chặn , tích sáu xác suất là : cross-entropy trung bình 0,418 chính là âm log hợp lý chia cho số điểm. Nghiệm , hệ số chặn ở Mục 6.3 làm cross-entropy nhỏ nhất, tức làm hợp lý lớn nhất, bằng . Vậy cross-entropy không phải một định nghĩa độc lập, mà là âm log hợp lý dưới giả thiết nhãn có phân phối Bernoulli. Tương tự, với lớp và nhãn có phân phối phân loại (categorical) với xác suất cho bởi softmax, âm log hợp lý là cross-entropy nhiều lớp của hồi quy softmax.
Cross-entropy còn có một cách hiểu theo lý thuyết thông tin. Với phân phối dữ liệu và phân phối của mô hình , cross-entropy bằng entropy cộng với phân kỳ Kullback–Leibler . Entropy của dữ liệu không phụ thuộc mô hình, nên cực tiểu cross-entropy tương đương cực tiểu khoảng cách KL từ phân phối dữ liệu tới phân phối của mô hình.
Mục 6.3 đã nhận xét rằng gradient của hồi quy logistic, , có cùng dạng với gradient của hồi quy tuyến tính. Lý do chung là cả phân phối Gauss và phân phối Bernoulli đều thuộc họ số mũ (exponential family). Một mô hình trong đó có phân phối thuộc họ số mũ và tham số tự nhiên của phân phối là hàm tuyến tính của gọi là mô hình tuyến tính tổng quát (generalized linear model, GLM) với hàm liên kết chính tắc. Với mọi GLM như vậy, gradient của âm log hợp lý có dạng , trong đó là kỳ vọng của theo mô hình. Hồi quy tuyến tính, hồi quy logistic, hồi quy softmax và hồi quy Poisson cho dữ liệu đếm đều là các trường hợp riêng.
10.4Ước lượng hậu nghiệm cực đại và regularization#
Hợp lý cực đại chỉ dùng dữ liệu, nên không có chỗ nào để đưa vào hiểu biết có sẵn, chẳng hạn "các hệ số hồi quy thường không quá lớn". Định lý Bayes ở Mục 3.5 cho ta chỗ đó.
Định nghĩa 10.2 (MAP)
Với phân phối tiên nghiệm , ước lượng hậu nghiệm cực đại (maximum a posteriori, MAP) là tham số làm hậu nghiệm lớn nhất:
Số hạng thứ nhất là hàm mất mát của MLE. Số hạng thứ hai chỉ phụ thuộc tham số, và đóng vai trò thành phần regularization.
Định lý 10.2 (Tiên nghiệm Gauss cho hồi quy ridge)
Với mô hình nhiễu Gauss của Định lý 10.1 và tiên nghiệm , ước lượng MAP của trùng với nghiệm hồi quy ridge với
Chứng minh
Âm log tiên nghiệm là . Cộng với âm log hợp lý ở Mục 10.2, bỏ hằng số và nhân với , hàm cần cực tiểu là
đúng là hàm mất mát ridge ở Định nghĩa 9.2 với .
Công thức có cách hiểu tự nhiên. Tiên nghiệm càng chặt, tức nhỏ và ta tin chắc các hệ số nhỏ, thì càng lớn. Dữ liệu càng nhiễu, tức lớn và dữ liệu ít đáng tin, thì tiên nghiệm càng được coi trọng, và cũng càng lớn.
Với bốn căn hộ, lấy như ước lượng ở Mục 10.2. Giả sử trước khi xem dữ liệu ta tin rằng thêm 10 m² hiếm khi làm giá đổi quá 0,2 tỉ, và diễn đạt niềm tin đó bằng tiên nghiệm Gauss cho độ dốc theo với . Khi đó , và theo Mục 9.2 độ dốc MAP là , chỉ nhỏ hơn độ dốc 0,24 của MLE một chút. Nhiễu nhỏ nên dữ liệu gần như quyết định tất cả.
Thí nghiệm kiểm chứng định lý bằng hai cách tính độc lập: một bên giải hệ tuyến tính dạng đóng của ridge, một bên dùng thuật toán tối ưu BFGS cực tiểu trực tiếp âm log hậu nghiệm.
lambda ly thuyet = sigma^2/tau^2 = 1.0/0.49 = 2.040816
Sai khac giua ridge dang dong va MAP toi uu bang so: 1.973e-08
Hai nghiệm khớp nhau tới , giới hạn bởi dung sai dừng của thuật toán tối ưu.
Tương tự, tiên nghiệm Laplace cho từng hệ số, , cho , tức ước lượng MAP là lasso. Hai tiên nghiệm diễn đạt hai niềm tin khác nhau: phân phối Gauss phẳng quanh 0 và nói "các hệ số nên nhỏ", còn phân phối Laplace có đỉnh nhọn tại 0 và nói "nhiều hệ số nên bằng 0". Hình dạng của tiên nghiệm tại 0 chính là nguồn gốc của khác biệt giữa ridge và lasso ở Mục 9.4.
Làm trơn Laplace của Naive Bayes (Mục 7.3) cũng là một ước lượng Bayes. Với biến rời rạc có giá trị và tiên nghiệm Dirichlet có mọi tham số bằng , ước lượng MAP của xác suất mỗi giá trị là , đúng công thức làm trơn. Nếu lấy kỳ vọng hậu nghiệm thay vì điểm cực đại, tiên nghiệm Dirichlet với tham số cho cùng công thức.
Từ "cuộc họp" ở Ví dụ 7.1 cho thấy điều này với , khi tiên nghiệm Dirichlet trở thành phân phối Beta. Từ này xuất hiện trong 0 trên 4 thư rác, nên hợp lý là và MLE là , đúng số đếm bằng 0 đã phủ quyết cả thư ở Mục 7.3. Với , tiên nghiệm có hai tham số bằng 2 và mật độ tỉ lệ với . Mật độ này bằng 0 ở hai đầu, tức nó không tin một từ có xác suất xuất hiện đúng bằng 0 hay đúng bằng 1. Hậu nghiệm tỉ lệ với ; cho đạo hàm của logarit, , bằng 0 được , đúng xác suất sau làm trơn ở Ví dụ 7.1.
Bảng dưới gom các thành phần regularization và tiên nghiệm tương ứng.
| Thành phần regularization | Tiên nghiệm tương ứng | Niềm tin được diễn đạt |
|---|---|---|
| (ridge) | Gauss | các hệ số nên nhỏ |
| (lasso) | Laplace | nhiều hệ số nên bằng đúng 0 |
| không có | tiên nghiệm phẳng | không có hiểu biết trước |
| làm trơn Laplace (Mục 7.3) | Dirichlet | mọi giá trị đều có thể xảy ra |
10.5Tóm tắt#
Hai nguyên lý của chương gói gọn trong bảng dưới: mỗi giả thiết về dữ liệu, kèm hoặc không kèm một tiên nghiệm, cho ra một thuật toán quen thuộc.
| Giả thiết về dữ liệu | Tiên nghiệm | Thuật toán thu được |
|---|---|---|
| Nhiễu Gauss | không | bình phương tối thiểu (Chương 4) |
| Nhiễu Gauss | Gauss | hồi quy ridge (Mục 9.2) |
| Nhiễu Gauss | Laplace | lasso (Mục 9.4) |
| Nhiễu Laplace | không | hồi quy trị tuyệt đối |
| Nhãn Bernoulli | không | hồi quy logistic (Mục 6.3) |
| Nhãn Bernoulli | Gauss | hồi quy logistic với regularization |
| Nhãn phân phối phân loại | không | hồi quy softmax (Mục 6.4) |
| Đặc trưng rời rạc độc lập có điều kiện | Dirichlet | Naive Bayes có làm trơn (Mục 7.3) |
Cột trái là giả thiết về dữ liệu, cột phải là thuật toán. Đọc bảng theo chiều ngược lại cũng hữu ích: khi dùng một thuật toán, ta đang ngầm chấp nhận giả thiết tương ứng, và khi giả thiết đó sai rõ ràng, như nhiễu có nhiều điểm ngoại lai hay nhãn không phải nhị phân, đó là tín hiệu nên đổi hàm mất mát. Các ví dụ nhỏ của giáo trình nằm đúng trên bảng này: tần suất 3/4 của từ "miễn phí" là MLE của một biến Bernoulli, đường thẳng qua bốn căn hộ là MLE dưới nhiễu Gauss, nghiệm của sáu sinh viên là MLE dưới nhãn Bernoulli, và xác suất 1/6 của từ "cuộc họp" sau làm trơn là MAP dưới tiên nghiệm Beta. Cùng với bảng, chương cho thấy mọi mô hình tuyến tính tổng quát với hàm liên kết chính tắc có gradient dạng , và ridge trùng với MAP dưới tiên nghiệm Gauss khi , khớp với nghiệm tối ưu bằng số tới .
Ước lượng MAP vẫn chưa phải suy luận Bayes đầy đủ. Suy luận Bayes giữ toàn bộ phân phối hậu nghiệm và lấy trung bình dự đoán trên phân phối đó; MAP chỉ lấy một điểm là đỉnh của hậu nghiệm. Vì vậy MAP không cho biết mức độ không chắc chắn của tham số, và khi hậu nghiệm lệch hoặc có nhiều đỉnh, điểm đỉnh có thể không đại diện cho phân phối. Một số thuật toán cũng nằm ngoài bảng trên: mất mát hinge của SVM (Chương 13) không phải là âm log hợp lý của một mô hình xác suất chuẩn hoá được, nên SVM không cho xác suất một cách trực tiếp.
Các hàm mất mát trong bảng còn một điểm chung chưa được nói ra: chúng đều lồi, nên gradient descent tìm được nghiệm tốt nhất từ bất kỳ điểm khởi tạo nào. Chương 11 xét chính xác tính lồi là gì và vì sao nó quan trọng tới vậy.
11Tập lồi và hàm lồi#
Tính lồi là ranh giới giữa những bài toán tối ưu có bảo đảm và những bài toán không có. Ở các chương trước, ta đã nhiều lần dựa vào nó mà chưa nói rõ. Ở Chương 5, gradient descent cho bốn căn hộ xuất phát từ , và ta coi điểm nó dừng là nghiệm tốt nhất mà không thử điểm xuất phát nào khác. Ở Chương 6, nghiệm của sáu sinh viên cũng được tìm bằng một lần chạy tối ưu duy nhất. Cả hai lần, điều cho phép làm vậy là tính lồi. Ở đây ta định nghĩa tập lồi và hàm lồi cho chặt chẽ, học cách nhận ra một hàm lồi mà không phải chứng minh từ đầu, và thấy bằng thí nghiệm điều gì xảy ra với gradient descent khi tính lồi mất đi. Các khái niệm này cũng là nền cho lý thuyết đối ngẫu ở Chương 12 và SVM ở Chương 13.
11.1Vai trò của tính lồi trong tối ưu#
Với bài toán tối ưu lồi, mọi cực tiểu địa phương đều là cực tiểu toàn cục. Vì vậy điểm khởi tạo không ảnh hưởng tới chất lượng nghiệm, không cần chạy lại nhiều lần với các khởi tạo khác nhau, và khi thuật toán dừng ở một điểm có gradient bằng 0, ta biết chắc đó là nghiệm tốt nhất.
Hồi quy tuyến tính, hồi quy logistic, ridge, lasso và SVM đều là bài toán lồi. Hàm mất mát của mạng nơ-ron có từ hai lớp trở lên thì không lồi, nên không có bảo đảm nào như trên: kết quả phụ thuộc vào khởi tạo, và không có cách nào biết chắc còn nghiệm tốt hơn hay không. Phần lớn kỹ thuật huấn luyện mạng sâu, như khởi tạo cẩn thận, chuẩn hoá và kết nối tắt, tồn tại để xử lý hậu quả của việc mất tính lồi.
Chương này và Chương 12 còn là nền cho SVM. Không có lý thuyết đối ngẫu thì không suy ra được bài toán đối ngẫu của SVM, và không có bài toán đối ngẫu thì không thấy được kernel.
11.2Tập lồi#
Định nghĩa 11.1 (Tập lồi)
Tập là tập lồi nếu đoạn thẳng nối hai điểm bất kỳ của nằm trọn trong :
Bảng dưới cho vài ví dụ ở cả hai phía.
| Tập lồi | Tập không lồi |
|---|---|
| Hình cầu, hình hộp, nửa không gian | Hình vành khuyên, hình chữ U |
| Siêu phẳng, giao của nhiều nửa không gian (khối đa diện) | Hợp của hai hình tròn rời nhau |
| Bao lồi của một tập điểm bất kỳ | Mặt cầu (chỉ phần vỏ) |
Hình cầu lồi vì với trong hình cầu, bất đẳng thức tam giác cho . Lập luận tương tự áp dụng cho quả cầu của mọi chuẩn, trong đó có hình thoi ở Mục 2.3.
Chương 13 dùng hai tính chất của tập lồi. Giao của các tập lồi là tập lồi, vì nếu hai điểm cùng thuộc mọi tập thì đoạn nối chúng cũng thuộc mọi tập; do đó miền thoả mãn một hệ ràng buộc tuyến tính, là giao của các nửa không gian, luôn là tập lồi. Ngược lại, hợp của các tập lồi thường không lồi, như hai hình tròn rời nhau.
11.3Hàm lồi#
Định nghĩa 11.2 (Hàm lồi)
Hàm xác định trên một tập lồi là hàm lồi nếu với mọi và mọi :
là lồi chặt nếu bất đẳng thức là chặt với mọi và .
Nói bằng lời, đoạn thẳng nối hai điểm trên đồ thị, tức dây cung, luôn nằm phía trên đồ thị. Lấy , , và : đồ thị ở điểm giữa có độ cao , còn trung điểm của dây cung ở độ cao , nên dây cung nằm trên. Với , lấy và : , nên dây cung là đoạn nằm ngang ở độ cao , trong khi cao hơn nó 2 đơn vị. Một bộ ba như vậy đủ để kết luận hàm không lồi.
Với hàm khả vi, có hai điều kiện tương đương dễ dùng hơn định nghĩa.
Định lý 11.1 (Điều kiện bậc nhất và bậc hai)
Cho khả vi trên tập lồi mở.
- lồi khi và chỉ khi với mọi : .
- Nếu khả vi hai lần, lồi khi và chỉ khi ma trận Hessian nửa xác định dương tại mọi . Với hàm một biến: .
Điều kiện bậc hai cho lại kết luận về mà không cần tìm bộ ba vi phạm: đạo hàm cấp hai âm khi , đúng vùng quanh điểm 0 nơi dây cung nằm dưới đồ thị. Điều kiện bậc nhất nói rằng tiếp tuyến, hay siêu phẳng tiếp xúc, tại mọi điểm luôn nằm dưới đồ thị. Từ đó suy ra ngay tính chất quan trọng nhất của hàm lồi.
Định lý 11.2 (Cực tiểu của hàm lồi)
Nếu lồi và khả vi thì mọi điểm có là cực tiểu toàn cục. Nếu lồi chặt thì cực tiểu toàn cục, nếu tồn tại, là duy nhất.
Chứng minh
Thay vào điều kiện bậc nhất: với mọi . Nếu có hai cực tiểu của hàm lồi chặt, điểm giữa của chúng có giá trị nhỏ hơn giá trị cực tiểu theo định nghĩa lồi chặt, mâu thuẫn.
Ví dụ 11.1
Hàm mất mát của hồi quy tuyến tính, , có Hessian , nửa xác định dương (Mục 2.5), nên lồi. Nếu đủ hạng cột thì Hessian xác định dương, lồi chặt và nghiệm duy nhất, đúng như Định lý 4.1. Với bốn căn hộ, hàm mất mát ở Mục 5.2 có Hessian , xác định dương, nên là cực tiểu toàn cục duy nhất, và gradient descent xuất phát từ đâu cũng về đó. Hàm có nên lồi chặt, nhưng không có cực tiểu: nó giảm dần về 0 khi . Ví dụ này cho thấy Định lý 11.2 chỉ nói về tính duy nhất, không bảo đảm cực tiểu tồn tại, và đây đúng là tình huống của hồi quy logistic trên dữ liệu tách được ở Mục 6.5.
11.4Kiểm tra tính lồi bằng thực nghiệm#
Định nghĩa 11.2 gợi ý một phép thử bằng số: chọn ngẫu nhiên nhiều cặp điểm và hệ số , rồi kiểm tra bất đẳng thức. Thí nghiệm thực hiện phép thử này trên 20 000 bộ ba cho mỗi hàm, với cột "vi phạm lớn nhất" là giá trị lớn nhất của .
| Hàm | Vi phạm lớn nhất | Tỉ lệ vi phạm | Kết luận |
|---|---|---|---|
| 0,0000 | lồi | ||
| 0,0000 | lồi | ||
| 0,0000 | lồi | ||
| (mất mát logistic) | 0,0000 | lồi | |
| 0,2075 | không lồi | ||
| 0,5051 | không lồi | ||
| 0,4985 | không lồi |
Với bốn hàm đầu, giá trị vi phạm lớn nhất không dương: các số âm rất nhỏ chỉ là sai số làm tròn ở những bộ ba có hai điểm gần nhau. Với ba hàm sau, có hàng nghìn bộ ba vi phạm, và độ vi phạm lớn. Với , vi phạm lớn nhất tìm được là 2,237, cùng cỡ với vi phạm 2 của bộ ba , , tính tay ở Mục 11.3.
Lưu ý
Phép thử này có thể bác bỏ tính lồi nhưng không chứng minh được nó. Không tìm thấy vi phạm trong 20 000 lần thử không loại trừ một vùng lõm hẹp ở đâu đó chưa được lấy mẫu. Ngược lại, chỉ một phản ví dụ là đủ để kết luận hàm không lồi. Với một hàm mất mát tự viết, đây là cách rẻ để phát hiện lỗi trước khi đi vào chứng minh.
Dòng thứ tư xác nhận bằng số điều mà Mục 11.5 sẽ chứng minh: mất mát logistic là hàm lồi, nên bài toán hồi quy logistic có regularization có nghiệm toàn cục duy nhất. Nhờ vậy hồi quy logistic không cần chạy nhiều lần với nhiều khởi tạo khác nhau như mạng nơ-ron.
11.5Các phép toán bảo toàn tính lồi#
Trên thực tế, người ta hiếm khi kiểm tra tính lồi bằng định nghĩa. Thay vào đó, hàm lồi được dựng từ những hàm đã biết là lồi bằng các phép toán bảo toàn tính lồi, liệt kê trong bảng dưới.
| Phép toán | Bảo toàn tính lồi |
|---|---|
| có | |
| với | có |
| có | |
| không | |
| , hợp với hàm affine | có |
| với lồi, lồi và không giảm | có |
| không, nói chung |
Các phép toán này giải thích tính lồi của mọi hàm mất mát trong giáo trình. Mất mát hinge là max của hai hàm affine theo , mà là hàm affine theo , nên hinge lồi theo tham số. Hàm là hàm lồi hợp với ánh xạ affine . Mất mát logistic là một hàm lồi một biến, vì đạo hàm cấp hai của nó bằng , hợp với hàm affine của . Và tổng của một mất mát lồi với một thành phần regularization lồi như hay là hàm lồi. Vì vậy ridge, lasso, hồi quy logistic có regularization và SVM đều là bài toán tối ưu lồi.
Cross-entropy của sáu sinh viên ở Chương 6 là một trường hợp cụ thể. Khi nhãn được mã hoá là , nó là trung bình của sáu hàm , với lề affine theo . Mỗi số hạng lồi theo , nên tổng lồi, và nghiệm , hệ số chặn ở Mục 6.3 là cực tiểu toàn cục.
11.6Tính lồi và kết quả của gradient descent#
Điều gì xảy ra khi tính lồi mất đi? Thí nghiệm sau chạy cùng một thuật toán gradient descent từ 21 điểm xuất phát trên một hàm lồi và một hàm không lồi.
ham LOI      x^2             : so diem dung khac nhau = 1
ham KHONG LOI x^4-3x^2+x/2   : so diem dung khac nhau = 2, tai x = -1.2645 va 1.1807
gia tri ham tai hai diem do  : -2.8725 va -1.6484
Với hàm không lồi , gradient descent dừng ở hai điểm khác nhau tuỳ điểm xuất phát, và hai điểm này có giá trị hàm khác nhau: và . Có thể biết trước điểm nào về đâu. Đạo hàm bằng 0 tại ba điểm: hai cực tiểu và , và một cực đại địa phương ngăn cách hai lòng chảo. Với bước học nhỏ, điểm xuất phát bên trái 0,084 trượt về cực tiểu bên trái, điểm bên phải trượt về cực tiểu bên phải: trong 21 điểm xuất phát cách đều từ tới , 11 điểm từ 0 trở xuống về , 10 điểm còn lại về . Những lần chạy xuất phát ở phía dương đều dừng tại cực tiểu địa phương , không phải cực tiểu toàn cục, và thuật toán không có cách nào nhận ra điều đó, vì gradient tại đó cũng bằng 0.
Hàm mất mát của mạng nơ-ron không lồi, nên hiện tượng trên xảy ra ở quy mô lớn hơn nhiều. Tuy vậy, kinh nghiệm thực tế cho thấy với mạng đủ lớn, phần lớn cực tiểu địa phương có giá trị mất mát gần nhau, và trở ngại chính lại là tín hiệu co lại hoặc phình ra qua nhiều lớp. Chương 6 của Học sâu trình bày khởi tạo, chuẩn hoá và kết nối tắt, ba kỹ thuật xử lý trở ngại đó.
11.7Tóm tắt#
Tập lồi chứa trọn đoạn thẳng nối hai điểm bất kỳ của nó, và giao của các tập lồi vẫn lồi. Hàm lồi có dây cung nằm trên đồ thị, tương đương với tiếp tuyến nằm dưới đồ thị hoặc Hessian nửa xác định dương; một bộ ba điểm như , với đủ để bác bỏ tính lồi. Với hàm lồi khả vi, mọi điểm có gradient bằng 0 là cực tiểu toàn cục; tính lồi chặt cho thêm tính duy nhất nhưng không bảo đảm cực tiểu tồn tại. Hàm mất mát của bốn căn hộ có Hessian nên lồi chặt, còn cross-entropy của sáu sinh viên lồi vì là tổng các hàm lồi của lề affine, nên nghiệm tìm được ở Chương 5 và Chương 6 là nghiệm tốt nhất. Phép thử bằng số bác bỏ được tính lồi nhưng không chứng minh được nó; trong thực tế, tính lồi được suy ra từ các phép toán bảo toàn như cộng, lấy max và hợp với hàm affine, và nhờ vậy mọi hàm mất mát của giáo trình tới đây đều lồi. Trên hàm không lồi , điểm dừng của gradient descent phụ thuộc vào việc điểm xuất phát nằm bên nào của cực đại địa phương ở .
Tính lồi bảo đảm tối ưu tốt khi không có ràng buộc. SVM lại là một bài toán tối ưu có ràng buộc, và Chương 12 trình bày công cụ để xử lý ràng buộc trong bài toán lồi: hàm Lagrange và bài toán đối ngẫu.
12Tối ưu lồi và đối ngẫu Lagrange#
SVM ở Chương 13 là một bài toán tối ưu có ràng buộc: tìm siêu phẳng có lề lớn nhất, với điều kiện mọi điểm nằm đúng phía. Gradient descent không xử lý trực tiếp được ràng buộc, nên ta cần một công cụ khác. Công cụ đó là phương pháp Lagrange, với ý tưởng thay việc cấm vi phạm ràng buộc bằng việc tính giá cho mỗi đơn vị vi phạm. Từ ý tưởng này sẽ ra bài toán đối ngẫu và điều kiện KKT, và từ điều kiện KKT sẽ ra khái niệm vector hỗ trợ. Một ví dụ một biến được dùng xuyên suốt chương để mọi khái niệm đều có thể tính tay.
12.1Bài toán tối ưu có ràng buộc#
Định nghĩa 12.1 (Dạng chuẩn)
Bài toán tối ưu có ràng buộc ở dạng chuẩn là
Điểm thoả mọi ràng buộc gọi là điểm chấp nhận được. Giá trị tối ưu ký hiệu là . Bài toán gọi là bài toán lồi nếu là hàm lồi và mọi là hàm affine.
Ràng buộc đẳng thức phải là affine, không chỉ lồi, vì tập với lồi nhưng không affine thường không lồi. Chẳng hạn lồi, nhưng là mặt cầu, không phải tập lồi.
Ví dụ 12.1 (Ví dụ xuyên suốt chương)
Tìm với ràng buộc . Viết ở dạng chuẩn: , . Nghiệm hiển nhiên là với : không có ràng buộc thì cực tiểu ở , nhưng điểm này không chấp nhận được, nên nghiệm nằm ở biên của miền ràng buộc.
12.2Hàm Lagrange và hàm đối ngẫu#
Ý tưởng của phương pháp Lagrange là thay việc cấm vi phạm ràng buộc bằng việc tính giá cho mỗi đơn vị vi phạm. Ta gắn cho mỗi ràng buộc bất đẳng thức một giá và cho mỗi ràng buộc đẳng thức một giá .
Định nghĩa 12.2 (Hàm Lagrange, hàm đối ngẫu)
Hàm Lagrange của bài toán ở Định nghĩa 12.1 là
với các nhân tử Lagrange và . Hàm đối ngẫu là cực tiểu của hàm Lagrange theo :
Điều kiện là bắt buộc: khi ràng buộc bị vi phạm, tức , số hạng phải làm tăng giá trị hàm, nghĩa là một khoản phạt.
Hàm đối ngẫu luôn là hàm lõm theo , kể cả khi bài toán gốc không lồi. Lý do là với mỗi cố định, là hàm affine theo , và cận dưới đúng (infimum) của một họ hàm affine luôn là hàm lõm. Nhờ vậy bài toán cực đại luôn là một bài toán tối ưu lồi, dù bài toán gốc khó tới đâu.
Ví dụ 12.2
Với Ví dụ 12.1, . Cực tiểu theo : đạo hàm cho . Thay vào:
Đây là một parabol úp xuống, đúng là hàm lõm.
12.3Đối ngẫu yếu và đối ngẫu mạnh#
Định lý 12.1 (Đối ngẫu yếu)
Với mọi và mọi : .
Chứng minh
Lấy bất kỳ chấp nhận được. Vì , và , ta có . Do đó . Lấy cận dưới đúng theo mọi chấp nhận được, vế phải trở thành .
Mỗi giá trị của hàm đối ngẫu là một chặn dưới của giá trị tối ưu. Với ví dụ xuyên suốt, , , và , đều không vượt quá . Bài toán đối ngẫu là tìm chặn dưới tốt nhất:
Hiệu gọi là khe đối ngẫu. Khi khe bằng 0 ta có đối ngẫu mạnh, và giải bài toán đối ngẫu cho đúng giá trị tối ưu của bài toán gốc.
Định lý 12.2 (Điều kiện Slater)
Nếu bài toán là lồi và tồn tại một điểm chấp nhận được thoả mọi ràng buộc bất đẳng thức một cách chặt, với mọi , thì đối ngẫu mạnh xảy ra.
Điều kiện Slater yêu cầu miền chấp nhận được có "phần trong", và hầu hết các bài toán lồi trong học máy thoả điều kiện này. Chẳng hạn, với SVM lề cứng trên dữ liệu tách được, nhân một siêu phẳng tách đúng với một hệ số đủ lớn cho một điểm thoả mọi ràng buộc một cách chặt.
Ví dụ 12.3
Tiếp tục Ví dụ 12.2: đạt cực đại tại , với . Vậy và khe đối ngẫu bằng 0. Điều kiện Slater thoả vì điểm có .
Có thể hiểu vì sao giá tốt nhất là 2. Với giá , cực tiểu của hàm Lagrange theo là . Giá quá thấp thì vi phạm ràng buộc vẫn có lời: với , cực tiểu là , nằm ngoài miền . Giá quá cao thì ràng buộc bị thoả thừa: với , cực tiểu là . Ở , cực tiểu rơi đúng vào , điểm biên của ràng buộc, và chặn dưới chạm giá trị tối ưu.
12.4Điều kiện KKT#
Định lý 12.3 (Điều kiện Karush–Kuhn–Tucker)
Xét bài toán lồi có các hàm khả vi và thoả điều kiện Slater. Điểm là nghiệm tối ưu khi và chỉ khi tồn tại sao cho bốn nhóm điều kiện sau thoả:
| Điều kiện | Công thức | Ý nghĩa |
|---|---|---|
| Chấp nhận được của bài toán gốc | , | nghiệm thoả mọi ràng buộc |
| Chấp nhận được của bài toán đối ngẫu | giá không âm | |
| Bù (complementary slackness) | ràng buộc không chặt thì giá bằng 0 | |
| Dừng | là điểm dừng của hàm Lagrange |
Điều kiện bù là điều kiện quan trọng nhất cho Chương 13. Nó nói rằng với mỗi ràng buộc, một trong hai điều phải xảy ra: hoặc ràng buộc chặt tại nghiệm, , tức nghiệm nằm đúng trên biên của ràng buộc đó, hoặc giá của nó bằng 0, . Một ràng buộc không chặt thì không ảnh hưởng tới nghiệm: bỏ nó đi, nghiệm không đổi.
Ví dụ 12.4
Với Ví dụ 12.1: điều kiện dừng , điều kiện bù . Nếu thì , vi phạm ràng buộc . Vậy , kéo theo và , khớp với Ví dụ 12.3. Nếu đổi ràng buộc thành , nghiệm là , ràng buộc không chặt (), và điều kiện bù cho : ràng buộc này không có vai trò gì.
Nhân tử Lagrange còn có ý nghĩa giá bóng (shadow price): nó đo giá trị tối ưu thay đổi bao nhiêu khi ràng buộc được nới lỏng. Nếu ràng buộc được nới thành , thì . Trong ví dụ, nới cho và , có đạo hàm tại bằng . Ràng buộc có giá lớn là ràng buộc đang "cản" nghiệm nhiều nhất.
Áp dụng vào SVM ở chương sau, điều kiện bù có nghĩa là chỉ những điểm dữ liệu nằm đúng trên lề mới có nhân tử và mới ảnh hưởng tới nghiệm. Đó là định nghĩa của vector hỗ trợ, và nó là hệ quả của điều kiện KKT chứ không phải một lựa chọn thiết kế.
12.5Ý nghĩa của bài toán đối ngẫu#
Có ba lý do để giải bài toán đối ngẫu thay vì bài toán gốc. Lý do đầu tiên là kích thước: bài toán gốc của SVM có biến là các trọng số, còn bài toán đối ngẫu có biến, mỗi điểm dữ liệu một nhân tử, nên khi lớn hơn nhiều thì bài toán đối ngẫu nhỏ hơn. Lý do thứ hai là chặn dưới: với bất kỳ nào, là chặn dưới của , nên hiệu giữa một điểm chấp nhận được và một điểm đối ngẫu cho biết nghiệm hiện tại cách tối ưu tối đa bao xa, và nhiều thuật toán dùng khe này làm tiêu chí dừng. Với ví dụ xuyên suốt, điểm chấp nhận được có và , nên cách tối ưu không quá 0,69 mà không cần biết ; thực tế nó cách 0,44. Lý do thứ ba, quan trọng nhất, là cấu trúc: bài toán đối ngẫu của SVM chỉ phụ thuộc vào dữ liệu qua các tích vô hướng . Nhận xét này dẫn thẳng tới kernel, vì thay tích vô hướng bằng một hàm kernel là SVM làm việc được trong không gian đặc trưng phi tuyến. Ở dạng bài toán gốc, cấu trúc này không lộ ra.
12.6Tóm tắt#
Phương pháp Lagrange thay ràng buộc bằng khoản phạt có giá , và hàm đối ngẫu, cực tiểu của hàm Lagrange theo , luôn lõm. Mỗi giá trị của hàm đối ngẫu là một chặn dưới của giá trị tối ưu, và với bài toán lồi thoả điều kiện Slater, chặn dưới tốt nhất đúng bằng giá trị tối ưu. Điều kiện KKT đặc trưng cho nghiệm tối ưu, trong đó điều kiện bù nói rằng ràng buộc nào không chặt thì có giá bằng 0 và không ảnh hưởng tới nghiệm. Nhân tử Lagrange là giá bóng, đo giá trị tối ưu thay đổi bao nhiêu khi nới ràng buộc. Ví dụ với cho , và khe đối ngẫu bằng 0; là giá làm cực tiểu không ràng buộc của hàm Lagrange rơi đúng vào biên của ràng buộc.
Chương 13 áp dụng toàn bộ bộ công cụ này cho SVM: bài toán gốc tìm siêu phẳng có lề lớn nhất, điều kiện bù chỉ ra vector hỗ trợ, và bài toán đối ngẫu dẫn tới kernel.
13Máy vector hỗ trợ#
Quay lại perceptron ở Mục 6.2: trên dữ liệu tách được, nó dừng ở siêu phẳng tách đúng đầu tiên mà nó tìm được, trong khi có vô số siêu phẳng như vậy. Với phiên bản tách được của sáu sinh viên ở Mục 6.5, ba người ôn 1, 2, 3 giờ trượt và ba người ôn 4, 5, 6 giờ đỗ, nên mọi ngưỡng nằm giữa 3 và 4 giờ đều tách đúng. Perceptron xuất phát từ , duyệt lần lượt sáu người theo thứ tự, và dừng ở , hệ số chặn , tức ngưỡng giờ, cách sinh viên 3 chỉ một phần ba giờ. Máy vector hỗ trợ (support vector machine, SVM) đặt ra một tiêu chí để chọn giữa chúng: lấy siêu phẳng cách xa dữ liệu nhất. Tiêu chí đơn giản này dẫn tới một bài toán tối ưu có ràng buộc, và toàn bộ công cụ của Chương 11 và 12 giờ được dùng tới: bài toán là lồi, điều kiện bù chỉ ra những điểm quyết định nghiệm, và bài toán đối ngẫu mở đường cho kernel, cách để SVM vẽ được biên quyết định phi tuyến.
13.1Ý tưởng lề cực đại#
Khi dữ liệu tách được tuyến tính, có vô số siêu phẳng tách đúng hai lớp. Perceptron dừng ở siêu phẳng đầu tiên nó tìm được, và siêu phẳng đó có thể nằm sát một điểm dữ liệu. Một điểm mới ở gần điểm đó, chỉ lệch đi một chút vì nhiễu, có thể bị phân loại sai.
SVM chọn siêu phẳng có lề lớn nhất, tức khoảng cách từ siêu phẳng tới điểm dữ liệu gần nhất là lớn nhất. Siêu phẳng như vậy nằm "chính giữa" khoảng trống giữa hai lớp. Với sáu sinh viên tách được, đó là ngưỡng 3,5 giờ, cách đều sinh viên 3 và sinh viên 4 nửa giờ. Trực giác là biên càng xa dữ liệu thì càng chịu được nhiễu. Lý thuyết học thống kê (Vapnik, 1995) chính xác hoá trực giác này: với dữ liệu nằm trong hình cầu bán kính , chiều VC của lớp các siêu phẳng có lề ít nhất không vượt quá . Khi lề đủ rộng, độ phức tạp của mô hình được kiểm soát bởi tỉ số chứ không bởi số chiều. Tỉ số này cũng là đại lượng xuất hiện trong định lý Novikoff ở Mục 6.2.
13.2Bài toán tối ưu của SVM lề cứng#
Theo Định lý 2.1, khoảng cách từ tới siêu phẳng là . Siêu phẳng không đổi nếu nhân và với cùng một số dương, nên ta có thể chọn thang đo sao cho điểm gần nhất thoả . Khi đó mọi điểm thoả , và khoảng cách giữa hai siêu phẳng và , tức độ rộng của lề, bằng .
Cực đại tương đương cực tiểu , và tương đương cực tiểu , dạng thuận tiện hơn vì khả vi.
Định nghĩa 13.1 (SVM lề cứng)
Với dữ liệu tách được tuyến tính, SVM lề cứng giải bài toán
Hàm mục tiêu là hàm bậc hai lồi với Hessian bằng ma trận đơn vị, còn các ràng buộc là affine. Đây là một bài toán quy hoạch toàn phương lồi ở đúng dạng chuẩn của Mục 12.1, nên có nghiệm duy nhất và mọi công cụ của Chương 12 đều áp dụng được.
Với sáu sinh viên tách được, mỗi người có một ràng buộc , với cho người trượt và cho người đỗ. Hai ràng buộc chặt nhất thuộc về hai người gần ngưỡng nhất: sinh viên 4 cần , sinh viên 3 cần . Trừ hai bất đẳng thức cho nhau được . Muốn nhỏ nhất thì lấy , kéo theo . Biên nằm ở 3,5 giờ, và lề rộng giờ, đúng khoảng trống từ 3 tới 4 giờ. Bốn người còn lại thoả ràng buộc với dư: sinh viên 2 và 5 có , sinh viên 1 và 6 có 5.
13.3Bài toán đối ngẫu và vector hỗ trợ#
Viết ràng buộc ở dạng chuẩn, , và lập hàm Lagrange:
Cho đạo hàm theo và bằng 0, ta được
Thay trở lại hàm Lagrange, số hạng chứa biến mất nhờ , và ta được bài toán đối ngẫu.
Định lý 13.1 (Bài toán đối ngẫu của SVM lề cứng)
Từ nghiệm , trọng số là , và bộ phân loại là .
Từ định lý rút ra ngay hai điều. Điều thứ nhất là là tổ hợp tuyến tính của các điểm dữ liệu, với trọng số . Điều thứ hai đến từ điều kiện bù (Mục 12.4): , nên chỉ có thể xảy ra với những điểm có , tức nằm đúng trên lề. Các điểm đó gọi là vector hỗ trợ. Mọi điểm khác có và không đóng góp gì vào .
Hệ số chặn tính được từ một vector hỗ trợ bất kỳ: vì và , ta có . Trên thực tế người ta lấy trung bình trên mọi vector hỗ trợ để giảm sai số số học.
Với sáu sinh viên tách được, chỉ sinh viên 3 và 4 nằm trên lề, nên chỉ và có thể khác 0. Điều kiện cho , và . Vì , ta được . Giá trị bài toán đối ngẫu là , bằng giá trị của bài toán gốc, và hệ số chặn tính từ sinh viên 4 là . Bốn sinh viên còn lại có : bỏ họ khỏi dữ liệu, nghiệm không đổi.
Thí nghiệm giải SVM bằng thư viện libsvm (qua scikit-learn) trên 120 điểm tách được, rồi kiểm tra các khẳng định trên từ nghiệm đối ngẫu:
Dung lai w tu nghiem doi ngau: lech so voi coef_ cua sklearn = 0.000e+00
Vector ho tro co thoa y_i(w.x_i + b) = 1 khong? lech lon nhat = 2.523e-08
So vector ho tro: 3 tren 120 diem (2.5%)

Doi ngau manh:
  gia tri bai toan goc  0.5*||w||^2  = 1.1037868651
  gia tri bai toan doi ngau          = 1.1037868254
  khe doi ngau                       = 3.961e-08
Le = 2/||w|| = 1.346085; khoang cach nho nhat tu diem toi sieu phang x 2 = 1.346085
Kết quả khớp với lý thuyết ở cả bốn điểm: công thức cho đúng vector trọng số của thư viện; các vector hỗ trợ nằm trên lề với sai lệch ; khe đối ngẫu bằng , tức bằng 0 trong phạm vi dung sai của bộ giải; và độ rộng lề đúng bằng hai lần khoảng cách từ điểm gần nhất tới siêu phẳng.
Chỉ 3 trong 120 điểm là vector hỗ trợ. Bỏ 117 điểm còn lại khỏi tập huấn luyện và huấn luyện lại thì nghiệm không đổi. Tính thưa này của SVM là hệ quả trực tiếp của điều kiện bù.
13.4SVM lề mềm#
Bài toán ở Định nghĩa 13.1 vô nghiệm khi dữ liệu không tách được tuyến tính, và ngay cả khi tách được, một điểm nhiễu nằm lẫn sang lớp kia có thể ép lề hẹp lại rất nhiều. SVM lề mềm (Cortes và Vapnik, 1995) cho phép vi phạm lề nhưng tính giá cho mỗi vi phạm.
Định nghĩa 13.2 (SVM lề mềm)
Với các biến bù và tham số :
Biến bù đo mức vi phạm của điểm thứ : nếu điểm nằm ngoài lề và đúng phía, nếu điểm nằm trong lề nhưng vẫn đúng phía, nếu điểm bị phân loại sai. Tại nghiệm tối ưu, , đúng bằng mất mát hinge ở Mục 6.1. Do đó bài toán tương đương với
tức mất mát hinge cộng regularization . Cách viết này cho thấy SVM lề mềm nằm trong cùng khung với hồi quy logistic có regularization: cùng mô hình tuyến tính, cùng thành phần phạt , khác nhau ở hàm mất mát. Tham số đóng vai trò nghịch đảo của hệ số regularization: lớn nghĩa là phạt vi phạm nặng, tức regularization yếu.
Bài toán đối ngẫu của SVM lề mềm giống hệt Định lý 13.1, chỉ thêm chặn trên . Điều kiện KKT chia các điểm dữ liệu thành ba nhóm, như bảng dưới.
| Nhân tử | Vị trí của điểm | Ảnh hưởng tới nghiệm |
|---|---|---|
| ngoài lề, đúng phía () | không | |
| đúng trên lề () | có | |
| vi phạm lề: trong lề hoặc sai phía () | có |
Sáu sinh viên ban đầu, với sinh viên 3 đỗ và sinh viên 4 trượt, có đủ cả ba nhóm. Dữ liệu này không tách được nên SVM lề cứng vô nghiệm. Với lề mềm và mọi , nghiệm là , : biên vẫn ở 3,5 giờ, hai mép lề ở 2 giờ và 5 giờ, lề rộng 3 giờ. Sinh viên 1 và 6 nằm ngoài lề, , nên . Sinh viên 2 và 5 nằm đúng trên mép lề, , với ; ở thì . Sinh viên 3 và 4 nằm sai phía, , nên . Tăng thêm nữa không đổi nghiệm, vì tăng chỉ làm lề hẹp lại mà không cứu được sinh viên 3 và 4: không ngưỡng nào phân loại đúng cả hai người. Ngược lại, khi nhỏ thì vi phạm rẻ và lề rộng ra: ở , , hai mép lề ở 1 giờ và 6 giờ, và cả sáu sinh viên đều là vector hỗ trợ.
Thí nghiệm trên hai lớp chồng lấn nhau, với năm giá trị , đếm số điểm trong từng nhóm.
| Lề | Số vector hỗ trợ | Đúng trên lề | Vi phạm lề | Sai số huấn luyện | Sai số kiểm tra | |
|---|---|---|---|---|---|---|
| 0,003 | 5,6121 | 114 | 0 | 114 | 0,1500 | 0,1795 |
| 0,030 | 2,6409 | 66 | 3 | 63 | 0,1750 | 0,1727 |
| 0,300 | 1,8286 | 48 | 3 | 45 | 0,1583 | 0,1790 |
| 3,000 | 1,7312 | 45 | 3 | 42 | 0,1667 | 0,1795 |
| 300,000 | 1,7311 | 45 | 3 | 42 | 0,1667 | 0,1795 |
Với nhỏ, vi phạm rẻ nên lề rộng (5,61) và rất nhiều điểm vi phạm lề: ở , cả 114 vector hỗ trợ đều là điểm vi phạm, không điểm nào nằm đúng trên lề. Với lớn, vi phạm đắt nên lề hẹp lại (1,73) và số vector hỗ trợ giảm còn 45. Từ trở lên nghiệm gần như không đổi, vì các điểm vi phạm còn lại là những điểm nằm sâu trong vùng chồng lấn, không siêu phẳng nào tránh được, giống sinh viên 3 và 4 ở trên.
Sai số kiểm tra chỉ dao động trong khoảng 0,173 tới 0,180, tức ảnh hưởng ít tới chất lượng trong thí nghiệm này. Điều đó phản ánh bản chất của dữ liệu: biên tối ưu ở đây vốn là tuyến tính, và SVM tuyến tính không đủ linh hoạt để overfitting đáng kể. Với kernel phi tuyến, mô hình linh hoạt hơn nhiều, và trở thành siêu tham số quan trọng cần chọn bằng cross-validation.
13.5Kernel#
Bài toán đối ngẫu ở Định lý 13.1 và bộ phân loại chỉ dùng dữ liệu qua các tích vô hướng. Giả sử ta muốn biến đổi dữ liệu sang một không gian đặc trưng mới bằng ánh xạ , chẳng hạn thêm các đặc trưng bậc hai, rồi chạy SVM tuyến tính trong không gian mới. Khi đó ta chỉ cần tính được tích vô hướng trong không gian mới:
Hàm gọi là kernel. Nếu tính được trực tiếp từ và mà không cần tính , ta làm việc được trong không gian đặc trưng mà không bao giờ phải dựng nó. Kỹ thuật này gọi là thủ thuật kernel (kernel trick).
Ví dụ 13.1
Với , xét . Khai triển:
Tính trực tiếp tốn một tích vô hướng hai chiều và một phép bình phương. Chẳng hạn với và : nên ; còn và cho . Với và kernel đa thức bậc , không gian đặc trưng có số chiều cỡ , trong khi vẫn chỉ tốn .
Không phải hàm hai biến nào cũng là một kernel. Điều kiện cần và đủ, theo định lý Mercer, là với mọi tập điểm , ma trận kernel đối xứng và nửa xác định dương. Điều kiện này bảo đảm bài toán đối ngẫu vẫn lồi. Bảng dưới liệt kê ba kernel thông dụng.
| Kernel | Công thức | Không gian đặc trưng |
|---|---|---|
| Tuyến tính | chính | |
| Đa thức bậc | mọi đơn thức bậc không quá | |
| RBF (Gauss) | vô hạn chiều |
Kernel RBF cho giá trị gần 1 khi hai điểm gần nhau và gần 0 khi chúng xa nhau, nên có thể hiểu nó như một thước đo độ giống nhau. Tham số quyết định "gần" là bao xa: lớn làm mỗi điểm chỉ ảnh hưởng một vùng rất nhỏ quanh nó, biên quyết định uốn lượn theo từng điểm và dễ overfitting; nhỏ làm biên trơn. Không gian đặc trưng của kernel RBF có vô hạn chiều, nhưng mỗi lần tính kernel chỉ tốn .
Thí nghiệm trên dữ liệu hai đường tròn đồng tâm, loại dữ liệu không tách được bằng bất kỳ đường thẳng nào, cho kết quả sau.
| Kernel | Độ chính xác |
|---|---|
| Tuyến tính | 0,6150 |
| Đa thức bậc 2 | 1,0000 |
| RBF | 1,0000 |
Kernel đa thức bậc 2 đạt độ chính xác tuyệt đối vì không gian đặc trưng của nó chứa và , nên chứa , bình phương khoảng cách tới tâm, đúng là đại lượng phân biệt hai đường tròn. Ví dụ này minh hoạ một nguyên tắc chung: chọn kernel là đưa vào mô hình một giả thiết về dạng của biên quyết định.
13.6SVM nhiều lớp và chi phí tính toán#
SVM được thiết kế cho hai lớp. Có ba cách mở rộng sang lớp, tóm tắt trong bảng dưới.
| Cách | Số mô hình | Ghi chú |
|---|---|---|
| Một chọi phần còn lại (one-vs-rest) | đơn giản; điểm số của các mô hình không cùng thang đo | |
| Một chọi một (one-vs-one) | mỗi mô hình chỉ học trên dữ liệu hai lớp; cách mặc định của libsvm | |
| Crammer–Singer | 1 | một bài toán tối ưu chung cho mọi lớp; ít dùng hơn |
Điểm yếu thật sự của SVM với kernel là chi phí tính toán. Huấn luyện cần làm việc với ma trận kernel , và các thuật toán thực tế như SMO có chi phí trong khoảng tới tuỳ dữ liệu. Khi dự đoán, phải tính kernel giữa điểm mới và mọi vector hỗ trợ, mà số vector hỗ trợ thường tăng tuyến tính theo khi dữ liệu chồng lấn. Với cỡ hàng triệu, cả hai chi phí đều quá lớn, trong khi mỗi epoch của SGD trên mạng nơ-ron chỉ tốn chi phí tuyến tính theo . Vì vậy SVM với kernel ít được dùng cho dữ liệu rất lớn, và lý do không nằm ở độ chính xác.
SVM vẫn là lựa chọn tốt khi số điểm dữ liệu vừa phải, tới vài chục nghìn, số đặc trưng lớn so với số điểm, và cần một mô hình mạnh với ít siêu tham số. Với dữ liệu văn bản biểu diễn bằng vector TF-IDF, SVM tuyến tính đến nay vẫn là một mô hình cơ sở rất khó vượt qua.
13.7Tóm tắt#
SVM chọn siêu phẳng có lề lớn nhất, và với thang đo chọn sao cho điểm gần nhất có , bài toán trở thành cực tiểu dưới các ràng buộc affine, một bài toán lồi. Với sáu sinh viên tách được, SVM đặt ngưỡng ở 3,5 giờ với , , trong khi perceptron dừng ở giờ. Bài toán đối ngẫu cho , và điều kiện bù làm bằng 0 với mọi điểm không nằm trên lề, nên chỉ vài vector hỗ trợ quyết định nghiệm: sinh viên 3 và 4 với trong ví dụ, 3 trên 120 điểm trong thí nghiệm, với khe đối ngẫu cỡ . SVM lề mềm thêm biến bù và tương đương với mất mát hinge cộng regularization , với là nghịch đảo của cường độ regularization; trên sáu sinh viên ban đầu, nó chia các điểm thành ba nhóm của điều kiện KKT, với sinh viên 3 và 4 vi phạm lề ở mọi . Vì bài toán đối ngẫu chỉ dùng tích vô hướng, thay tích vô hướng bằng kernel cho biên phi tuyến mà không phải dựng không gian đặc trưng. Điểm yếu của SVM với kernel là chi phí tăng nhanh theo số điểm dữ liệu.
Mười ba chương đầu đều làm việc với dữ liệu có nhãn. Ba chương còn lại chuyển sang dữ liệu không có nhãn, bắt đầu bằng câu hỏi: trong hàng trăm đặc trưng, những hướng nào thật sự mang thông tin? Chương 14 trả lời bằng PCA.
14Giảm chiều dữ liệu#
Dữ liệu thật thường có hàng trăm đặc trưng, nhưng chỉ vài hướng trong số đó thật sự mang thông tin, phần còn lại là nhiễu hoặc lặp lại những gì đã có. Nếu tìm được các hướng đó, ta nén được dữ liệu, khử được nhiễu, và vẽ được dữ liệu lên mặt phẳng để nhìn. Phương pháp tuyến tính phổ biến nhất cho việc này là PCA, và nó hoá ra chỉ là phân tích trị riêng của ma trận hiệp phương sai ở Chương 3. Ta cũng sẽ thấy giới hạn của PCA khi dữ liệu có nhãn, và phương pháp thay thế có dùng nhãn là LDA. Một ví dụ hai chiều đủ nhỏ để tính tay mọi bước, điểm hai bài kiểm tra của bốn sinh viên, đi suốt chương.
14.1Mục đích của giảm chiều#
Giảm chiều là biến đổi dữ liệu từ chiều xuống chiều mà giữ lại càng nhiều thông tin hữu ích càng tốt. Lý do đầu tiên để làm việc này là tính toán: thuật toán chạy nhanh hơn và tốn ít bộ nhớ hơn trên dữ liệu ít chiều. Lý do thứ hai là thống kê: ít chiều hơn nghĩa là ít tham số hơn cho mô hình phía sau, nên phương sai của ước lượng nhỏ hơn, và theo nghĩa này giảm chiều là một dạng regularization. Lý do thứ ba là trực quan hoá: con người không nhìn được dữ liệu 100 chiều, nhưng nhìn được hình chiếu của nó lên mặt phẳng hai chiều. Ngoài ra, lời nguyền số chiều ở Mục 7.2 khiến khoảng cách mất dần ý nghĩa khi số chiều tăng, nên các phương pháp dựa trên khoảng cách như k-NN và K-means thường cần giảm chiều trước.
14.2Phân tích thành phần chính (PCA)#
PCA (Pearson, 1901) tìm các hướng mà dữ liệu trải rộng nhất. Hình dung một đám mây điểm có dạng hình elip dẹt trong mặt phẳng: trục dài của elip là hướng giữ được nhiều thông tin nhất về vị trí các điểm, và chiếu mọi điểm lên trục đó mất ít thông tin nhất.
Ví dụ của chương là điểm hai bài kiểm tra của bốn sinh viên A, B, C, D, đã trừ điểm trung bình của lớp ở mỗi bài:
| Sinh viên | A | B | C | D |
|---|---|---|---|---|
| Bài 1, | 2 | 1 | −1 | −2 |
| Bài 2, | 1 | 2 | −2 | −1 |
Bốn điểm nằm dọc theo đường chéo : người làm tốt bài này thường cũng làm tốt bài kia. Đám mây điểm là một elip dẹt với trục dài nằm trên đường chéo đó.
Gọi là ma trận dữ liệu đã trừ trung bình của từng cột, và là ma trận hiệp phương sai mẫu (Mục 3.3). Chiếu dữ liệu lên hướng đơn vị cho các toạ độ , có phương sai . PCA tìm hướng làm phương sai này lớn nhất:
Ràng buộc là cần thiết, vì không có nó thì nhân với số lớn làm phương sai lớn tuỳ ý. Lập hàm Lagrange và cho gradient theo bằng 0, ta được
Vậy hướng tối ưu là một vector riêng của , và phương sai đạt được đúng bằng trị riêng tương ứng. Để phương sai lớn nhất, ta chọn vector riêng ứng với trị riêng lớn nhất.
Với bốn sinh viên, dữ liệu đã có trung bình bằng 0. Ma trận có các phần tử , và , nên
Hai vector riêng là với trị riêng và với ; có thể kiểm tra trực tiếp, chẳng hạn . Thành phần chính thứ nhất là hướng "làm tốt cả hai bài", thành phần thứ hai là hướng "làm bài 1 tốt hơn bài 2".
Định nghĩa 14.1 (Thành phần chính)
Gọi là các trị riêng của ma trận hiệp phương sai và là các vector riêng trực chuẩn tương ứng. Vector gọi là thành phần chính (principal component) thứ . PCA với thành phần biểu diễn mỗi điểm bằng toạ độ , .
Thành phần thứ hai là hướng có phương sai lớn nhất trong các hướng vuông góc với thành phần thứ nhất, và cứ tiếp tục như vậy. Theo định lý phổ, các vector riêng của ma trận đối xứng trực giao với nhau, nên các thành phần chính tự động vuông góc, và các toạ độ không tương quan với nhau. Tỉ lệ gọi là tỉ lệ phương sai được giải thích bởi thành phần thứ . Với bốn sinh viên, toạ độ theo thành phần thứ nhất là , bằng cho A và B, cho C và D. Phương sai của bốn toạ độ này là , đúng bằng , và thành phần thứ nhất giải thích phương sai.
PCA tính được theo hai cách: bằng phân tích trị riêng của , hoặc bằng SVD của , vì theo Mục 2.6 các vector riêng của là các cột của và trị riêng của là . Thí nghiệm tính theo cả hai cách trên dữ liệu 8 chiều và in ra bốn trị riêng đầu:
tri rieng cua ma tran hiep phuong sai : [11.52671  4.855133  2.064187  0.142466]
d_i^2/(n-1) tu SVD                    : [11.52671  4.855133  2.064187  0.142466]
lech lon nhat tren ca 8 tri: 7.105e-15
goc giua cac truc chinh: [1. 1. 1. 1.]
Hai cách cho cùng trị riêng tới , và các trục chính trùng nhau: trị tuyệt đối cosine giữa các cặp trục tương ứng bằng 1, vì vector riêng chỉ xác định tới dấu. Trên thực tế nên dùng SVD của , vì cách này không cần lập , phép toán làm bình phương số điều kiện (Mục 2.6).
Lưu ý (Chuẩn hoá trước PCA)
PCA tìm hướng có phương sai lớn, nên kết quả phụ thuộc vào đơn vị đo. Nếu một đặc trưng đo bằng milimét và các đặc trưng khác đo bằng mét, phương sai của đặc trưng đó lớn hơn một triệu lần và thành phần chính thứ nhất gần như trùng với nó. Khi các đặc trưng có đơn vị khác nhau, cần chuẩn hoá mỗi đặc trưng về phương sai bằng 1 trước khi áp dụng PCA.
14.3Định lý Eckart–Young và sai số tái tạo#
Từ toạ độ có thể dựng lại gần đúng điểm ban đầu: . Câu hỏi tự nhiên là dựng lại được chính xác tới đâu.
Định lý 14.1 (Eckart–Young, 1936)
Gọi là ma trận tái tạo từ thành phần chính đầu tiên. Khi đó
và là ma trận hạng gần nhất theo chuẩn Frobenius: không có ma trận hạng nào cho sai số nhỏ hơn.
Vế phải của đẳng thức là tổng các trị riêng bị bỏ đi, nhân với . Vậy sai số tái tạo bằng đúng phần phương sai không được giữ lại, và đây là đẳng thức chính xác chứ không phải xấp xỉ. Với bốn sinh viên và , mỗi điểm được dựng lại bằng hình chiếu của nó lên : A và B thành , C và D thành . Mỗi điểm lệch khỏi bản dựng lại một vector có bình phương độ dài 0,5, nên , đúng bằng . Thí nghiệm dùng 300 điểm 8 chiều sinh từ 3 thành phần thật cộng nhiễu để kiểm tra đẳng thức trên dữ liệu lớn hơn.
| Chênh lệch | Phương sai giữ lại | |||
|---|---|---|---|---|
| 1 | 2242,010603 | 2242,010603 | 60,59% | |
| 2 | 790,325815 | 790,325815 | 86,11% | |
| 3 | 173,133807 | 173,133807 | 96,96% | |
| 4 | 130,536554 | 130,536554 | 97,71% | |
| 8 | 0,000000 | 0,000000 | 100,00% |
Hai cột giữa trùng nhau tới ở mọi . Cột cuối cho thấy cách chọn : phương sai giữ lại tăng nhanh tới (96,96%) rồi gần như dừng lại (97,71% ở ). Chỗ đồ thị phương sai tích luỹ gãy gập là dấu hiệu của số chiều thật của dữ liệu, và ở đây nó khớp với 3 thành phần đã dùng để sinh dữ liệu. Một quy tắc thường dùng khác là chọn nhỏ nhất giữ được một tỉ lệ phương sai cho trước, như 90% hoặc 95%.
14.4Hạn chế của PCA và phân tích biệt thức tuyến tính (LDA)#
PCA không dùng nhãn. Nó tìm hướng có phương sai lớn, nhưng phương sai lớn không có nghĩa là hữu ích cho bài toán phân loại. Bốn sinh viên cho thấy điều này. Gắn cho mỗi người nhãn "sa sút" nếu điểm bài 2 thấp hơn bài 1 và "tiến bộ" nếu ngược lại: A và C sa sút, B và D tiến bộ. Theo thành phần chính thứ nhất, A và B có cùng toạ độ , C và D cùng toạ độ , nên hướng giữ 90% phương sai không phân biệt được hai nhóm chút nào. Toàn bộ thông tin về nhãn nằm ở thành phần thứ hai, chiếm 10% phương sai và bị PCA với bỏ đi: theo , hai người sa sút có toạ độ , hai người tiến bộ có .
Thí nghiệm dựng dữ liệu hai lớp có một hướng nhiễu biên độ lớn, theo đó hai lớp trộn lẫn, và một hướng tín hiệu biên độ nhỏ, theo đó hai lớp tách nhau:
truc chinh thu nhat cua PCA: [-1.  0.0067]   (giu 96.1% phuong sai)
huong cua LDA              : [0.0025  1.]
AUC khi chieu len truc PCA : 0.5020
AUC khi chieu len huong LDA: 0.9987
Thành phần chính thứ nhất giữ 96,1% phương sai, nhưng chiếu dữ liệu lên nó cho ROC-AUC 0,502, không tốt hơn đoán ngẫu nhiên. Hướng do LDA chọn gần như vuông góc với trục đó và cho AUC 0,9987, giống thành phần thứ hai của bốn sinh viên.
Phương pháp dùng nhãn để giải quyết vấn đề này là phân tích biệt thức tuyến tính (linear discriminant analysis, LDA; Fisher, 1936), tìm hướng tách các lớp tốt nhất. Với hai lớp, gọi là trung bình của mỗi lớp, là ma trận tán xạ trong lớp, tức tổng các ma trận hiệp phương sai của hai lớp, và là ma trận tán xạ giữa các lớp. Chiếu dữ liệu lên hướng , LDA muốn khoảng cách giữa trung bình hai lớp lớn trong khi độ phân tán bên trong mỗi lớp nhỏ:
Công thức nghiệm có cách hiểu trực quan: hướng nối hai trung bình là lựa chọn tự nhiên, nhưng cần "chỉnh" lại bằng để giảm trọng số của những hướng có phân tán trong lớp lớn. Trong thí nghiệm, hướng nhiễu có phân tán trong lớp lớn nên bị giảm trọng số gần như hoàn toàn. Bảng dưới so sánh hai phương pháp.
| PCA | LDA | |
|---|---|---|
| Dùng nhãn | không | có |
| Tối đa hoá | phương sai toàn phần | tỉ số tán xạ giữa lớp / tán xạ trong lớp |
| Số chiều ra tối đa | ||
| Dùng khi | nén, khử nhiễu, trực quan hoá | tiền xử lý cho phân loại |
Giới hạn chiều của LDA đến từ hạng của : với lớp, được dựng từ vector trung bình lệch khỏi trung bình chung, và các vector này có tổng có trọng số bằng 0, nên có hạng không quá . Với hai lớp, LDA cho đúng một chiều.
LDA ở đây và bộ phân loại LDA ở Mục 7.4 là cùng một phương pháp nhìn từ hai phía: hướng chính là vector trọng số trong hàm phân biệt tuyến tính của bộ phân loại Gauss dùng chung ma trận hiệp phương sai.
Khi chọn phương pháp giảm chiều, câu hỏi đầu tiên là có nhãn hay không và mục đích là gì. Không có nhãn, hoặc mục đích là nén và khử nhiễu, thì dùng PCA. Có nhãn và mục đích cuối là phân loại thì nên thử LDA. Khi cần giữ cấu trúc phi tuyến, có PCA với kernel, dùng cùng thủ thuật kernel ở Mục 13.5, và t-SNE hoặc UMAP để trực quan hoá. t-SNE không cung cấp ánh xạ cho điểm dữ liệu mới và làm biến dạng khoảng cách toàn cục, nên chỉ dùng để quan sát, không dùng làm bước tiền xử lý cho mô hình.
14.5Tóm tắt#
PCA tìm các hướng có phương sai lớn nhất, và lời giải của bài toán tối ưu có ràng buộc đó là các vector riêng của ma trận hiệp phương sai, với phương sai bằng trị riêng tương ứng. Với điểm hai bài kiểm tra của bốn sinh viên, thành phần chính thứ nhất là , hướng "làm tốt cả hai bài", và giữ 90% phương sai. Nên tính PCA bằng SVD của dữ liệu đã trừ trung bình, và chuẩn hoá đặc trưng trước khi áp dụng nếu đơn vị đo khác nhau. Theo định lý Eckart–Young, sai số tái tạo bằng đúng tổng các trị riêng bị bỏ đi nhân với : bằng 2 với bốn sinh viên và , và thí nghiệm xác nhận đẳng thức tới ; chỗ đồ thị phương sai tích luỹ gãy gập cho biết số chiều thật của dữ liệu. PCA không dùng nhãn nên có thể giữ đúng hướng vô dụng cho phân loại: với nhãn tiến bộ hay sa sút, toàn bộ thông tin của bốn sinh viên nằm ở 10% phương sai bị bỏ đi, và trong thí nghiệm, hướng giữ 96,1% phương sai chỉ cho AUC 0,502. LDA dùng nhãn và chọn hướng .
Giảm chiều tìm cấu trúc theo các hướng trong không gian đặc trưng. Một câu hỏi khác về dữ liệu không nhãn là các điểm có tự gom thành nhóm hay không. Chương 15 xét thuật toán phân cụm phổ biến nhất, K-means.
15Phân cụm K-means#
Phân cụm là bài toán học không giám sát điển hình: chia dữ liệu không có nhãn thành các nhóm sao cho điểm trong cùng nhóm giống nhau hơn điểm khác nhóm. Thuật toán phổ biến nhất cho việc này, K-means, đơn giản tới mức có thể mô tả trong hai câu. Nhưng khi dùng thật, nó đặt ra ba câu hỏi mà người mới hay bỏ qua: kết quả có phụ thuộc vào cách khởi tạo không, thuật toán ngầm giả định cụm có hình dạng gì, và chọn số cụm thế nào khi không có nhãn để đối chiếu. Ta xét thuật toán trước, rồi lần lượt trả lời ba câu hỏi đó, mỗi câu trước hết trên một ví dụ tính tay được rồi mới bằng thí nghiệm. Ví dụ đó là bốn cửa hàng trên bản đồ, hai cửa hàng phía tây ở và , hai cửa hàng phía đông ở và , toạ độ tính bằng km. Cần đặt hai kho hàng sao cho tổng bình phương khoảng cách từ mỗi cửa hàng tới kho gần nó nhất là nhỏ nhất, và đó đúng là bài toán K-means với .
15.1Bài toán phân cụm và thuật toán Lloyd#
Định nghĩa 15.1 (Bài toán K-means)
Cho điểm và số cụm . Tìm cách chia các điểm thành cụm cùng các tâm cụm để cực tiểu tổng bình phương khoảng cách từ mỗi điểm tới tâm cụm của nó:
Giá trị của hàm mục tiêu tại một nghiệm gọi là inertia (tổng bình phương trong cụm).
Tìm nghiệm tối ưu toàn cục của bài toán này là NP-khó, kể cả khi với số chiều tuỳ ý, hoặc khi dữ liệu nằm trong mặt phẳng với tuỳ ý. Thuật toán thông dụng là thuật toán Lloyd (1957, công bố 1982), tìm nghiệm xấp xỉ bằng cách lặp lại hai bước. Ở bước gán, mỗi điểm được gán vào cụm có tâm gần nó nhất. Ở bước cập nhật, mỗi tâm được thay bằng trung bình của các điểm thuộc cụm đó. Hai bước lặp lại cho tới khi các phép gán không thay đổi.
Với bốn cửa hàng, đặt hai tâm ban đầu tại và . Bước gán đưa về tâm thứ nhất và về tâm thứ hai. Bước cập nhật dời hai tâm tới trung điểm của mỗi cặp, và . Bước gán tiếp theo không đổi gì, và thuật toán dừng với mỗi kho nằm giữa hai cửa hàng cùng phía, inertia .
Mỗi bước tối ưu một phần của bài toán khi giữ phần kia cố định: bước gán chọn cụm tốt nhất cho từng điểm khi biết tâm, còn bước cập nhật chọn tâm tốt nhất cho từng cụm khi biết các điểm, vì trung bình là điểm làm tổng bình phương khoảng cách nhỏ nhất. Vì vậy hàm mục tiêu không bao giờ tăng. Số cách chia điểm thành cụm là hữu hạn, nên thuật toán chắc chắn dừng sau hữu hạn bước, và mỗi vòng lặp tốn phép tính.
Tuy nhiên, thuật toán chỉ dừng ở một cực tiểu địa phương: một trạng thái mà không bước nào cải thiện được, nhưng chưa chắc tốt nhất. Hàm mục tiêu không lồi theo , nên theo Chương 11 không có bảo đảm nào về chất lượng của điểm dừng. Với bốn cửa hàng, đặt hai tâm ban đầu tại và , tức cả hai ở phía tây. Bước gán đưa về tâm thứ nhất và về tâm thứ hai, vì mỗi cửa hàng phía đông gần tâm cùng hàng với nó hơn. Bước cập nhật dời hai tâm tới và , và từ đó không gì thay đổi nữa: mỗi cửa hàng cách kho của nó 2 km, inertia bằng 16, gấp 16 lần nghiệm tốt nhất.
15.2Khởi tạo và k-means++#
Điểm dừng của thuật toán Lloyd phụ thuộc vào các tâm ban đầu, và mức độ phụ thuộc lớn hơn nhiều so với hình dung. Thí nghiệm chạy K-means 200 lần trên dữ liệu 720 điểm gồm 8 cụm, trong đó một số cụm nằm gần nhau, mỗi lần với một hạt giống ngẫu nhiên khác. Một lần chạy được tính là "kẹt ở nghiệm tồi" nếu inertia lớn hơn giá trị nhỏ nhất tìm được trong mọi lần chạy quá 2%.
| Cách khởi tạo | Inertia nhỏ nhất | Inertia trung bình | Tỉ lệ kẹt ở nghiệm tồi |
|---|---|---|---|
| Ngẫu nhiên | 407,992 | 517,838 | 71,5% |
| k-means++ | 407,992 | 476,529 | 46,5% |
Chọn ngẫu nhiên điểm dữ liệu làm tâm ban đầu dẫn tới nghiệm tồi trong 71,5% số lần chạy. Ngay với bốn cửa hàng, tỉ lệ này đã là 1/3: trong 6 cặp điểm có thể chọn làm tâm ban đầu, 2 cặp nằm cùng phía và dẫn tới nghiệm có inertia 16. Nghiệm tồi điển hình là hai tâm rơi vào cùng một cụm thật trong khi hai cụm thật khác bị gộp chung một tâm; thuật toán Lloyd không sửa được tình huống này, vì mỗi bước chỉ dịch chuyển tâm một cách cục bộ.
Cách khởi tạo k-means++ (Arthur và Vassilvitskii, 2007) chọn tâm ban đầu tuần tự: tâm đầu tiên chọn ngẫu nhiên đều từ dữ liệu, mỗi tâm tiếp theo được chọn với xác suất tỉ lệ với bình phương khoảng cách từ điểm đó tới tâm gần nhất đã chọn. Các điểm xa những tâm hiện có được ưu tiên, nên các tâm ban đầu có xu hướng trải đều ra các cụm. Với bốn cửa hàng, giả sử tâm đầu tiên là . Bình phương khoảng cách từ ba cửa hàng còn lại tới nó là 1, 16 và 17, nên xác suất tâm thứ hai rơi vào , cùng phía với tâm đầu, chỉ là . Do tính đối xứng, tâm đầu là cửa hàng nào cũng vậy, nên k-means++ kẹt với xác suất khoảng 3% thay vì 33%. Arthur và Vassilvitskii chứng minh rằng riêng bước khởi tạo này đã cho kỳ vọng inertia không quá lần giá trị tối ưu. Trong thí nghiệm, k-means++ giảm tỉ lệ kẹt từ 71,5% xuống 46,5%: cải thiện rõ, nhưng vẫn gần một nửa số lần chạy cho nghiệm tồi, vì với 8 cụm trong đó có những cụm nằm gần nhau, bình phương khoảng cách không chênh lệch rõ như ở bốn cửa hàng.
Lưu ý
Luôn chạy K-means nhiều lần với các khởi tạo khác nhau và giữ kết quả có inertia nhỏ nhất. Trong scikit-learn từ phiên bản 1.4, tham số
n_initcủaKMeansmặc định là'auto', nghĩa là chỉ chạy một lần khi dùng khởi tạo k-means++. Với dữ liệu như thí nghiệm trên, cần đặtn_inittường minh, chẳng hạnn_init=10.
15.3Các giả định của K-means#
Câu hỏi thứ hai là K-means ngầm giả định gì về dữ liệu. Thí nghiệm chạy cùng thuật toán trên ba dạng dữ liệu.
| Dạng cụm | Độ chính xác phân cụm |
|---|---|
| Ba cụm tròn, tách rời | 1,0000 |
| Hai hình lưỡi liềm lồng nhau | 0,7517 |
| Hai dải dẹt nằm ngang song song | 0,5317 |
Độ chính xác phân cụm ở đây được tính sau khi thử mọi cách ghép nhãn cụm với nhãn thật và lấy cách tốt nhất, vì tên cụm do K-means đặt là tuỳ ý. Với hai dải dẹt, độ chính xác 0,5317 gần như bằng đoán ngẫu nhiên (0,5).
Nguyên nhân nằm ở bước gán. Mỗi điểm thuộc về tâm gần nhất theo khoảng cách Euclid, nên biên giới giữa hai cụm luôn là mặt phẳng trung trực của đoạn nối hai tâm, và toàn bộ không gian bị chia thành các ô lồi gọi là sơ đồ Voronoi. Từ đó suy ra ba giả định ngầm của K-means: các cụm có dạng lồi và gần tròn, các cụm có kích thước tương đương nhau, và mọi chiều có cùng thang đo để khoảng cách Euclid có ý nghĩa.
Hai dải dẹt vi phạm giả định thứ nhất. Mỗi dải dài theo phương ngang và hẹp theo phương dọc, và hai dải cách nhau theo phương dọc một khoảng nhỏ hơn chiều dài của chúng. Cách chia có inertia nhỏ nhất vì vậy là cắt đôi theo phương thẳng đứng, mỗi cụm lấy nửa trái hoặc nửa phải của cả hai dải, thay vì tách hai dải ra. Bốn cửa hàng là phiên bản nhỏ nhất của tình huống này. Nếu hai nhóm cần tìm là hai hàng ngang và , chẳng hạn hai tuyến đường giao hàng, thì cách chia theo hàng có inertia 16, còn cách chia trái phải có inertia 1, nên K-means luôn chọn trái phải.
Khi các giả định trên không thoả, có các phương pháp khác. Mô hình hỗn hợp Gauss (Gaussian mixture model) cho phép mỗi cụm có dạng elip với ma trận hiệp phương sai riêng, và K-means là trường hợp giới hạn của nó khi mọi cụm có hiệp phương sai với . DBSCAN gom các điểm theo mật độ, cho phép cụm có hình dạng tuỳ ý và tự xác định số cụm. Phân cụm phổ (spectral clustering) biến đổi dữ liệu dựa trên đồ thị láng giềng rồi mới áp dụng K-means, và xử lý tốt dữ liệu hình lưỡi liềm.
15.4Chọn số cụm#
Câu hỏi thứ ba là chọn . Inertia luôn giảm khi tăng, và bằng 0 khi , tức mỗi điểm là một cụm, nên không thể chọn bằng cách cực tiểu inertia. Với bốn cửa hàng, inertia tốt nhất là 17, 1, 0,5 và 0 với : giảm 16 khi tăng từ một lên hai kho, rồi chỉ giảm 0,5 mỗi bước sau đó. Thêm kho thứ ba gần như không rút ngắn được quãng đường nào. Bảng sau cho inertia tốt nhất trong 8 lần chạy k-means++ ở mỗi , trên dữ liệu 8 cụm của Mục 15.2.
| Inertia | Giảm so với | |
|---|---|---|
| 5 | 902,24 | 21,6% |
| 6 | 727,79 | 19,3% |
| 7 | 563,93 | 22,5% |
| 8 | 407,99 | 27,7% |
| 9 | 385,82 | 5,4% |
| 10 | 364,76 | 5,5% |
Mức giảm là 27,7% khi tăng lên và chỉ 5,4% khi tăng lên . Điểm mà inertia ngừng giảm nhanh gọi là khuỷu tay (elbow) của đồ thị inertia theo , và ở đây nó rơi đúng vào số cụm thật. Cách chọn tại khuỷu tay gọi là phương pháp elbow.
Lưu ý
Khuỷu tay không có định nghĩa toán học; nó là một quy tắc quan sát bằng mắt, và trên dữ liệu thật đồ thị thường giảm đều, không có khuỷu rõ ràng. Hai tiêu chí khác có định nghĩa chặt hơn. Hệ số silhouette của một điểm là , với là khoảng cách trung bình tới các điểm cùng cụm và là khoảng cách trung bình tới các điểm của cụm gần nhất khác; ta chọn có silhouette trung bình lớn nhất. Gap statistic (Tibshirani, Walther và Hastie, 2001) so sánh inertia với inertia trên dữ liệu ngẫu nhiên không có cấu trúc cụm. Trong nhiều ứng dụng, còn được quyết định bởi yêu cầu nghiệp vụ, chẳng hạn số nhóm khách hàng mà bộ phận marketing có thể xử lý.
15.5Tóm tắt#
K-means chia dữ liệu thành cụm để cực tiểu tổng bình phương khoảng cách tới tâm, và thuật toán Lloyd lặp giữa bước gán và bước cập nhật, không bao giờ làm tăng hàm mục tiêu nhưng chỉ dừng ở cực tiểu địa phương: với bốn cửa hàng, hai tâm ban đầu cùng phía cho inertia 16 thay vì 1. Kết quả phụ thuộc mạnh vào khởi tạo. Với bốn cửa hàng, khởi tạo ngẫu nhiên kẹt với xác suất 1/3 và k-means++ chỉ 1/34; trong thí nghiệm 8 cụm, khởi tạo ngẫu nhiên kẹt ở nghiệm tồi 71,5% số lần, k-means++ vẫn 46,5%, nên cần chạy nhiều lần. Vì bước gán chia không gian thành các ô lồi, K-means giả định cụm lồi, gần tròn, cỡ tương đương và các chiều cùng thang đo; với hai dải dẹt song song, nó chỉ đạt 0,5317. Số cụm được chọn bằng khuỷu tay của đồ thị inertia, hệ số silhouette, gap statistic hoặc yêu cầu nghiệp vụ.
PCA và K-means tìm cấu trúc trong một ma trận dữ liệu đầy đủ. Chương cuối xét một bài toán mà phần lớn ma trận bị trống, và cấu trúc hạng thấp của nó là thứ duy nhất cho phép điền vào các ô trống: hệ thống gợi ý.
16Hệ thống gợi ý#
Chương cuối của giáo trình là một ứng dụng dùng lại gần như mọi công cụ đã học. Hệ thống gợi ý dự đoán mức độ một người dùng thích một sản phẩm, bộ phim hay bài hát mà họ chưa đánh giá. Phương pháp chính, phân rã ma trận, cần tới hạng của ma trận và SVD ở Chương 2, hồi quy ridge ở Chương 9, và đánh đổi độ chệch – phương sai xuyên suốt giáo trình. Các thí nghiệm của chương tập trung vào một câu hỏi thực tế mà sách thường bỏ qua: cần bao nhiêu dữ liệu thì phương pháp mới bắt đầu có ích, và điều gì xảy ra với người dùng chưa có dữ liệu nào. Trước các thí nghiệm, một ma trận ba người dùng, ba bộ phim đủ nhỏ để tính tay sẽ cho thấy cơ chế của từng bước.
16.1Bài toán gợi ý#
Dữ liệu được tổ chức thành ma trận đánh giá , với người dùng và sản phẩm; ô là đánh giá của người dùng cho sản phẩm . Phần lớn các ô bị trống, vì mỗi người chỉ đánh giá một phần rất nhỏ trong số sản phẩm. Bài toán là dự đoán giá trị của các ô trống.
Có hai hướng tiếp cận chính. Lọc dựa trên nội dung (content-based filtering) mô tả mỗi sản phẩm bằng các đặc trưng như thể loại, đạo diễn, từ khoá, rồi học sở thích của từng người theo các đặc trưng đó; về bản chất, đây là một bài hồi quy riêng cho mỗi người dùng. Lọc cộng tác (collaborative filtering) không cần đặc trưng của sản phẩm mà chỉ dùng mẫu hình đánh giá của mọi người dùng, với ý tưởng rằng những người đánh giá giống nhau trong quá khứ sẽ tiếp tục đánh giá giống nhau.
Dữ liệu đánh giá cũng có hai dạng. Phản hồi tường minh (explicit feedback) là điểm số người dùng chủ động cho, như số sao. Phản hồi ngầm (implicit feedback) là hành vi như lượt xem, lượt nhấp, thời gian nghe; dạng này nhiều hơn hẳn nhưng khó diễn giải, vì không xem một sản phẩm không có nghĩa là không thích nó. Chương này dùng phản hồi tường minh.
16.2Phân rã ma trận#
Định nghĩa 16.1 (Phân rã ma trận)
Phương pháp phân rã ma trận (matrix factorization) giả định ma trận đánh giá xấp xỉ được bằng một ma trận hạng thấp:
Mỗi người dùng được biểu diễn bằng vector (hàng thứ của ), mỗi sản phẩm bằng vector , và đánh giá dự đoán là .
Các toạ độ của và gọi là nhân tố ẩn (latent factors). Không ai định nghĩa chúng trước; chúng hình thành từ dữ liệu. Với phim ảnh, một nhân tố có thể tương ứng với mức độ "hành động" của phim và mức độ người dùng thích phim hành động, và tích vô hướng lớn khi sở thích của người dùng khớp với đặc điểm của phim. Cách hiểu này chỉ mang tính minh hoạ: các nhân tố học được thường không có nghĩa rõ ràng như vậy.
Ví dụ nhỏ nhất là hạng 1. Ba người dùng Lan, Minh, Hùng chấm ba phim A, B, C trên thang 1 tới 5. Trừ đi 3, mức giữa thang, để điểm dương là thích và điểm âm là không thích:
| Phim A | Phim B | Phim C | |
|---|---|---|---|
| Lan | 2 | 2 | −2 |
| Minh | 1 | ? | −1 |
| Hùng | −1 | −1 | 1 |
Các ô đã biết khớp đúng với tích , với cho ba người và cho ba phim. Có thể đọc là mức "hành động" của phim, A và B là phim hành động còn C thì không, và là mức thích phim hành động: Lan thích nhiều, Minh thích vừa, Hùng không thích. Mô hình hạng 1 điền ô trống bằng , tức dự đoán Minh chấm phim B 4 sao.
Chỉ các ô đã quan sát, ký hiệu là tập , được dùng để học. Hàm mất mát là bình phương sai số trên các ô đó cộng regularization:
Hàm này không lồi theo đồng thời, vì có tích . Nhưng khi cố định , nó tách thành bài toán độc lập theo từng , và mỗi bài toán là một hồi quy ridge (Mục 9.2):
trong đó gồm các hàng của ứng với sản phẩm người dùng đã đánh giá, và là các đánh giá tương ứng. Tương tự khi cố định để giải . Thuật toán luân phiên hai bước này gọi là bình phương tối thiểu luân phiên (alternating least squares, ALS), và mỗi bước không làm tăng hàm mất mát. Với ví dụ ở trên và đã biết, Minh đánh giá phim A và C, nên và . Công thức cho , bằng 0,952 với , và dự đoán cho phim B là điểm trên mức giữa, tức khoảng 3,95 sao: regularization kéo dự đoán về phía mức giữa thang một chút. Một lựa chọn khác là SGD trên từng ô quan sát. Các hệ thống thực tế thường thêm hệ số chặn riêng cho người dùng và cho sản phẩm, , để mô tả việc có người chấm điểm rộng tay hơn và có sản phẩm được ưa chuộng hơn mặt bằng chung (Koren, Bell và Volinsky, 2009).
Giả thiết hạng thấp là điều làm bài toán có nghĩa. Thí nghiệm của chương dùng 300 người dùng và 200 sản phẩm: ma trận có 60 000 ô, còn mô hình hạng 4 chỉ có tham số, bằng 3,3% số ô. Không có giả thiết như vậy, giá trị của một ô chưa quan sát không liên quan gì tới các ô đã quan sát, và không thể dự đoán.
16.3Lượng dữ liệu cần thiết#
Thí nghiệm sinh một ma trận đánh giá hạng 4 thật, cộng nhiễu có độ lệch chuẩn 0,4, rồi che đi phần lớn các ô và giữ lại một tỉ lệ ngẫu nhiên. Mô hình được huấn luyện bằng ALS với và đánh giá bằng RMSE trên các ô bị che.
| Tỉ lệ ô quan sát | Đánh giá mỗi người | RMSE trên ô chưa quan sát | Tỉ số với mức đoán bằng 0 |
|---|---|---|---|
| 2% | 4,1 | 2,4759 | 1,19 |
| 3% | 5,9 | 3,0167 | 1,45 |
| 5% | 10,1 | 3,5444 | 1,71 |
| 10% | 19,8 | 0,3048 | 0,15 |
| 20% | 39,6 | 0,1834 | 0,09 |
| 40% | 80,5 | 0,1237 | 0,06 |
Cột cuối là tỉ số giữa RMSE của mô hình và độ lệch chuẩn của ma trận thật (2,0772), tức sai số của cách đoán mọi ô bằng 0. Tỉ số lớn hơn 1 nghĩa là mô hình còn tệ hơn cách đoán đơn giản đó.
Ba dòng đầu có tỉ số lớn hơn 1: với khoảng 10 đánh giá mỗi người trở xuống, phân rã ma trận cho sai số lớn hơn cả cách đoán mọi ô bằng 0. Giữa 10,1 và 19,8 đánh giá mỗi người, RMSE giảm từ 3,54 xuống 0,30, hơn 11 lần. Sau ngưỡng đó, thêm dữ liệu chỉ cải thiện từ từ.
Có thể hiểu ngưỡng này bằng cách đếm ẩn số. Mỗi người dùng có ẩn số trong , nên cần ít nhất 4 đánh giá để xác định chúng, kể cả khi đã biết chính xác. Nhưng các đánh giá có nhiễu, và cũng đang được ước lượng từ chính dữ liệu thưa đó, nên số đánh giá cần thiết lớn hơn nhiều lần mức tối thiểu. Ví dụ hạng 1 cho thấy vì sao. Nếu Minh chỉ chấm phim A, một đánh giá là đủ cho một ẩn số: , vẫn đúng chiều. Nhưng nếu đánh giá duy nhất đó lệch đi 1 điểm vì nhiễu, Minh chấm A đúng 3 sao, thì và mô hình mất hết thông tin về Minh. Có thêm đánh giá phim C, cùng đánh giá lệch đó chỉ kéo xuống , vẫn đúng chiều. Trong thí nghiệm, ngưỡng nằm giữa 10 và 20 đánh giá mỗi người, tức khoảng 2,5 tới 5 lần hạng . Lý thuyết hoàn thiện ma trận (matrix completion) cho kết luận cùng chiều: dưới giả thiết vị trí các ô quan sát ngẫu nhiên, số quan sát cần thiết tăng tuyến tính theo hạng, nhân với một thừa số logarit của kích thước ma trận (Candès và Recht, 2009).
Con số cụ thể của thí nghiệm này phụ thuộc vào mức nhiễu, và cách chọn ô quan sát, nhưng kết luận định tính là chung: cần số đánh giá mỗi người dùng lớn hơn hạng nhiều lần thì phân rã ma trận mới có ích. Vì vậy các hệ thống thực tế dùng tương đối nhỏ, cỡ vài chục tới vài trăm, dù có hàng triệu người dùng: hạng càng lớn thì càng cần nhiều dữ liệu cho mỗi người.
16.4Chọn hạng #
Khi đã đủ dữ liệu, câu hỏi tiếp theo là chọn hạng . Bảng dưới đo ở mật độ quan sát 30%, nơi mô hình có đủ dữ liệu.
| Hạng | RMSE trên ô chưa quan sát | RMSE trên ô đã quan sát |
|---|---|---|
| 1 | 1,8073 | 1,7769 |
| 2 | 1,4764 | 1,4206 |
| 3 | 1,0569 | 1,0128 |
| 4 | 0,1448 | 0,3762 |
| 6 | 0,2217 | 0,3535 |
| 10 | 0,3501 | 0,3076 |
| 20 | 0,6291 | 0,1903 |
Hai cột có xu hướng ngược nhau. RMSE trên ô đã quan sát giảm đều khi tăng: mô hình nhiều tham số hơn khớp dữ liệu huấn luyện sát hơn, và ở nó đạt 0,1903, thấp hơn cả độ lệch chuẩn của nhiễu (0,4), tức mô hình đã bắt đầu khớp cả nhiễu. RMSE trên ô chưa quan sát đạt nhỏ nhất ở , đúng hạng thật, rồi tăng lại: ở nó bằng 0,6291, gấp 4,3 lần giá trị tại .
Đây là đánh đổi độ chệch – phương sai (Mục 3.6) dưới dạng chọn hạng: nhỏ hơn hạng thật gây underfitting, lớn hơn gây overfitting. Trên dữ liệu thật, hạng thật không biết trước, và được chọn bằng cách đo sai số trên một tập các ô được giữ lại để xác thực, giống cross-validation ở Mục 9.5.
16.5Vấn đề khởi đầu lạnh#
Một người dùng mới chưa đánh giá sản phẩm nào thì mô hình dự đoán gì cho họ? Thí nghiệm thêm 10 người dùng như vậy vào dữ liệu ở mật độ 30%:
RMSE cho nguoi dung cu   : 0.1459
RMSE cho nguoi dung moi  : 2.2364
RMSE neu doan bua bang 0 : 2.0772
||P|| trung binh, nguoi cu : 2.0841
||P|| trung binh, nguoi moi: 1.54e-01
Với người dùng mới, RMSE là 2,2364, còn tệ hơn đoán mọi đánh giá bằng 0 (2,0772). Hai dòng cuối giải thích cơ chế: vector của người dùng mới có chuẩn trung bình 0,154, so với 2,084 của người dùng cũ. Với người dùng không có ô quan sát nào, tổng bình phương sai số trong hàm mất mát ở Mục 16.2 không chứa số hạng nào liên quan tới , chỉ còn thành phần regularization , và giá trị cực tiểu của nó là . Chuẩn đo được khác 0 một chút vì trong thí nghiệm, các vector này chỉ nhận giá trị khởi tạo ngẫu nhiên nhỏ và không được cập nhật. Mô hình vì vậy dự đoán gần 0 cho mọi sản phẩm với người dùng mới. Trong ví dụ ba người dùng, một người thứ tư chưa chấm phim nào nhận và được đoán chấm mọi phim đúng 3 sao, mức giữa thang, dù người đó mê phim hành động như Lan hay ghét như Hùng.
Vấn đề này gọi là khởi đầu lạnh (cold start), và có ba dạng, mỗi dạng một cách xử lý thường dùng.
| Dạng khởi đầu lạnh | Cách xử lý thường dùng |
|---|---|
| Người dùng mới | hỏi vài sở thích khi đăng ký; dùng thông tin nhân khẩu học; gợi ý các sản phẩm phổ biến |
| Sản phẩm mới | dùng đặc trưng nội dung của sản phẩm (thể loại, mô tả, embedding của văn bản hoặc hình ảnh) |
| Hệ thống mới | bắt đầu bằng lọc dựa trên nội dung, chuyển dần sang lọc cộng tác khi đã có dữ liệu |
Vì vậy các hệ thống gợi ý thực tế hầu như luôn là hệ lai (hybrid): lọc cộng tác cho kết quả tốt hơn khi có đủ dữ liệu, còn lọc dựa trên nội dung bảo đảm luôn có câu trả lời khi chưa có dữ liệu.
Ngoài khởi đầu lạnh còn một vấn đề mà thí nghiệm tĩnh của chương không đo được: vòng phản hồi (feedback loop). Hệ thống chỉ gợi ý những sản phẩm nó dự đoán là tốt, nên chỉ thu được phản hồi về những sản phẩm đó, và dữ liệu huấn luyện của lần sau càng lệch về các sản phẩm đã được gợi ý. Mục 12.3 của MLOps mô phỏng hiện tượng này và cho thấy một hệ không có cơ chế thăm dò ngẫu nhiên chỉ quan sát được 9,5% danh mục sản phẩm.
16.6Tóm tắt#
Phân rã ma trận giả định ma trận đánh giá xấp xỉ được bằng tích hai ma trận hạng thấp, mỗi người dùng và mỗi sản phẩm là một vector nhân tố ẩn, và được huấn luyện bằng ALS, trong đó mỗi bước là một hồi quy ridge. Với ba người dùng và ba phim, giả thiết hạng 1 điền được ô trống, và bước ridge cho Minh , tức khoảng 3,95 sao cho phim B. Giả thiết hạng thấp là điều làm bài toán có nghĩa, nhưng nó chỉ có ích khi đủ dữ liệu: một đánh giá có nhiễu đủ làm mất hết thông tin về một người dùng hạng 1, và trong thí nghiệm, với khoảng 10 đánh giá mỗi người trở xuống, mô hình còn tệ hơn đoán mọi ô bằng 0; RMSE chỉ giảm mạnh khi số đánh giá vượt khoảng 2,5 tới 5 lần hạng. Hạng được chọn theo đánh đổi độ chệch – phương sai, và sai số trên ô chưa quan sát nhỏ nhất đúng ở hạng thật. Người dùng chưa có đánh giá nào nhận vector bằng 0 do regularization và được đoán ở mức giữa cho mọi sản phẩm, nên hệ thống thực tế luôn kết hợp lọc cộng tác với lọc dựa trên nội dung.
Nhìn lại cả giáo trình, mỗi thuật toán đã gặp đều quay về ba thành phần ở Chương 1: một họ hàm, một hàm mất mát và một cách tối ưu. Đại số tuyến tính cho biết bài toán có nghiệm hay không, xác suất cho biết hàm mất mát đến từ đâu, tính lồi cho biết tối ưu có tìm được nghiệm tốt nhất không, và đánh đổi độ chệch – phương sai cho biết mô hình có tổng quát hoá được không. Giáo trình Học sâu đi tiếp từ đây: chồng nhiều lớp hồi quy logistic thành mạng nơ-ron, và xét điều gì xảy ra khi bài toán không còn lồi. Chương 17 gồm các bài tập để luyện các phép tính của giáo trình, và Chương 18 gom các câu hỏi phỏng vấn thường gặp.
17Bài tập#
Các bài tập đi theo các chương của giáo trình: phần lớn là phép tính tay với những con số nhỏ đủ làm bằng giấy bút, vài bài là chứng minh ngắn, một bài chẩn đoán các tình huống của K-means và một bài thiết kế hệ thống gợi ý. Lời giải chi tiết, kèm nhãn chương và độ khó của từng bài, nằm ở trang Lời giải.
Bài 1 (tính tay). Cho bốn điểm và mô hình . (a) Lập ma trận có cột hằng số, rồi tính và . (b) Giải phương trình chuẩn để tìm , . (c) Tính phần dư của từng điểm. Tổng các phần dư bằng bao nhiêu, và vì sao kết quả đó không phải ngẫu nhiên? (d) Lặp lại với hồi quy ridge, . Các hệ số thay đổi theo chiều nào?
Bài 2 (suy luận). Giả sử với độc lập, và tiên nghiệm . (a) Viết , bỏ các hằng số không phụ thuộc . (b) Chứng minh rằng điểm cực tiểu của biểu thức đó trùng với nghiệm hồi quy ridge, và chỉ ra . (c) Khi tiên nghiệm chặt hơn ( nhỏ hơn), thay đổi theo chiều nào? Giải thích vì sao chiều đó hợp lý. (d) Nếu thay tiên nghiệm Gauss bằng tiên nghiệm Laplace thì được thuật toán nào, và tiên nghiệm đó diễn đạt niềm tin gì về ?
Bài 3 (tính tay). Mục 5.3 đo được: với , gradient descent cần 92 104 vòng lặp, còn có momentum chỉ cần 1 297 vòng lặp. (a) Ước lượng số vòng lặp của cả hai phương pháp khi , dựa vào bậc lý thuyết và . (b) Một người nói: "Bài toán của tôi có một triệu chiều nên gradient descent sẽ rất chậm." Nhận định này đúng hay sai, và vì sao? (c) Nêu một bước tiền xử lý đơn giản làm giảm , và giải thích cơ chế.
Bài 4 (suy luận). Sai số của sai phân trung tâm gồm hai phần: sai số cắt cụt cỡ và sai số làm tròn cỡ , với . (a) Cực tiểu tổng hai phần theo và chứng minh . (b) Làm tương tự với sai phân tiến (sai số cắt cụt cỡ ) và chứng minh . (c) So sánh với hai giá trị đo được ở Mục 5.5. (d) Vì sao sai phân trung tâm tốn gấp đôi số lần tính hàm mà vẫn được ưa dùng hơn?
Bài 5 (tính tay). Một tập dữ liệu tách được tuyến tính có mọi điểm nằm trong hình cầu bán kính và có lề . (a) Chặn của định lý Novikoff cho số lần cập nhật của perceptron bằng bao nhiêu? (b) Nếu thêm 10 000 điểm nữa (vẫn tách được, vẫn cùng và ), chặn thay đổi thế nào? Điều đó cho biết gì? (c) Nếu nhân mọi với 10, thì , và chặn thay đổi thế nào? (d) Vì sao perceptron không có bảo đảm hội tụ khi dữ liệu không tách được? Trả lời dựa vào hình dạng của hàm mất mát ở Hình 5.
Bài 6 (tính tay). Một mô hình phát hiện gian lận cho ma trận nhầm lẫn sau trên 20 000 giao dịch:
| Dự đoán gian lận | Dự đoán bình thường | |
|---|---|---|
| Thật sự gian lận | 102 | 94 |
| Thật sự bình thường | 105 | 19 699 |
(a) Tính độ chính xác, precision, recall và . (b) Tính độ chính xác của bộ phân loại luôn đoán "bình thường". So sánh với kết quả ở (a). (c) Kết quả (b) nói gì về việc dùng độ chính xác để chọn mô hình trong bài toán này? (d) Bộ phận quản lý rủi ro cho biết bỏ sót một ca gian lận tốn gấp 20 lần một lần báo động nhầm. Nên dịch ngưỡng theo chiều nào, và nên dùng thước đo nào để chọn ngưỡng?
Bài 7 (tính tay). Xét SVM lề cứng trên đúng hai điểm: có nhãn và có nhãn . (a) Dùng tính đối xứng để lập luận rằng , rồi giải bài toán gốc để tìm . (b) Tính độ rộng lề và so sánh với khoảng cách giữa hai điểm. Giải thích kết quả. (c) Tìm , từ và ràng buộc . (d) Tính giá trị bài toán gốc và giá trị bài toán đối ngẫu. Khe đối ngẫu bằng bao nhiêu? (e) Thêm điểm có nhãn . Nghiệm có thay đổi không? Trả lời bằng điều kiện bù.
Bài 8 (tính tay). Một ma trận hiệp phương sai có các trị riêng . (a) Cần giữ bao nhiêu thành phần chính để giữ được ít nhất 85% phương sai? (b) Với và điểm dữ liệu, sai số tái tạo bằng bao nhiêu? (c) Một người nói: "Giữ 90% phương sai nên mô hình phân loại chỉ kém đi một chút." Dùng kết quả ở Mục 14.4 để phản bác. (d) Nếu đổi đơn vị của một đặc trưng từ mét sang milimét, các trị riêng thay đổi thế nào? Từ đó rút ra điều gì về việc chuẩn hoá trước PCA?
Bài 9 (chẩn đoán). Với mỗi tình huống sau, nêu nguyên nhân có thể và hai việc nên làm: (a) Chạy K-means 5 lần trên cùng dữ liệu, được 5 kết quả khác hẳn nhau. (b) K-means chia đôi một cụm dài và dẹt, trong khi gộp hai cụm tròn nhỏ nằm gần nhau. (c) Inertia giảm đều theo , không thấy khuỷu tay. (d) Một cụm chứa 98% số điểm, bốn cụm còn lại mỗi cụm chỉ có vài điểm.
Bài 10 (thiết kế). Một hệ thống gợi ý có 1 triệu người dùng và 100 nghìn sản phẩm, dự định dùng phân rã ma trận hạng . (a) Mô hình có bao nhiêu tham số? Con số đó bằng bao nhiêu phần trăm số ô của ma trận đầy đủ? (b) Theo kết quả ở Mục 16.3, lấy mức an toàn là khoảng 5 lần hạng đánh giá mỗi người, thì mỗi người cần khoảng bao nhiêu đánh giá? Tổng cộng cần bao nhiêu đánh giá, bằng bao nhiêu phần trăm số ô? (c) Thực tế trung bình mỗi người chỉ có 30 đánh giá. Dự đoán điều gì sẽ xảy ra, và nêu hai cách xử lý. (d) Yêu cầu sản phẩm là mọi người dùng mới đều nhận được gợi ý ngay từ phiên đầu tiên. Thiết kế phương án dự phòng, và nêu rõ khi nào chuyển sang dùng phân rã ma trận.
18Câu hỏi phỏng vấn#
18.1Cách trình bày câu trả lời#
Phần lớn câu hỏi phỏng vấn về học máy cơ bản có dạng "vì sao X" hoặc "X khác Y thế nào". Một câu trả lời tốt thường đi qua ba bước. Đầu tiên là vấn đề mà X giải quyết: X ra đời để xử lý tình huống nào. Tiếp theo là cơ chế: X hoạt động thế nào, tốt nhất bằng một công thức ngắn hoặc một con số cụ thể. Cuối cùng là giới hạn: X tốn kém ở đâu, và khi nào nó không còn đúng.
Với các chủ đề nền tảng, có thêm một bước giúp câu trả lời nổi bật: nêu mối liên hệ giữa X với một khái niệm khác. Chẳng hạn, trả lời về ridge mà chỉ ra được nó là ước lượng MAP với tiên nghiệm Gauss cho thấy người trả lời hiểu nguồn gốc của phương pháp chứ không chỉ nhớ công thức.
Các câu trả lời mẫu dưới đây dẫn số liệu từ các thí nghiệm của giáo trình. Khi phỏng vấn không cần nhớ chính xác từng con số; điều quan trọng là nắm được độ lớn và chiều của hiệu ứng.
18.2Hồi quy và tối ưu#
Câu hỏi: Vì sao hồi quy tuyến tính dùng bình phương sai số?
Trả lời
Vì bình phương sai số là âm log hợp lý khi nhiễu có phân phối Gauss (Mục 10.2), nên nghiệm bình phương tối thiểu chính là ước lượng hợp lý cực đại dưới giả thiết đó. Nếu nhiễu có đuôi dày hơn Gauss, ví dụ có nhiều điểm ngoại lai, thì giả thiết nhiễu Laplace hợp lý hơn và cho ra hồi quy trị tuyệt đối, phương pháp ít nhạy với điểm ngoại lai. Đổi giả thiết về nhiễu là đổi hàm mất mát.
Câu hỏi: Khi nào phương trình chuẩn không có nghiệm duy nhất, và xử lý thế nào?
Trả lời
Khi không đủ hạng cột: số đặc trưng lớn hơn số điểm dữ liệu, hoặc có đặc trưng là tổ hợp tuyến tính của các đặc trưng khác. Ví dụ điển hình là mã hoá one-hot đủ giá trị trong khi vẫn giữ cột hằng số. Khi đó có vô số nghiệm cho cùng một dự đoán. Giả nghịch đảo chọn nghiệm có chuẩn nhỏ nhất, trùng với giới hạn của ridge khi . Trên thực tế thường bỏ cột thừa hoặc dùng ridge.
Câu hỏi: Đa cộng tuyến gây hại thế nào?
Trả lời
Nó làm hệ số dao động mạnh nhưng hầu như không ảnh hưởng tới dự đoán. Trong thí nghiệm ở Mục 4.4, khi tương quan giữa hai đặc trưng tăng từ 0 lên 0,999, độ lệch chuẩn của hệ số tăng khoảng 25 lần, trong khi độ lệch chuẩn của dự đoán gần như không đổi. Mức tăng khớp với lý thuyết . Vì vậy đa cộng tuyến là vấn đề của việc diễn giải hệ số, không phải của dự đoán.
Câu hỏi: Tốc độ hội tụ của gradient descent phụ thuộc vào gì?
Trả lời
Vào số điều kiện của hàm mất mát, không phụ thuộc vào số chiều. Với hàm bậc hai, số vòng lặp tỉ lệ với . Mục 5.3 đo được khi tăng từ 1 lên 10 000, số vòng lặp tăng từ 1 lên 92 104; thêm momentum giảm bậc xuống , chỉ còn 1 297 vòng. Hệ quả thực tế: chuẩn hoá đặc trưng về cùng thang đo là cách rẻ nhất để giảm và tăng tốc huấn luyện.
Câu hỏi: Kiểm tra gradient bằng cách nào?
Trả lời
So sánh với sai phân trung tâm, dùng khoảng tới và đánh giá bằng sai số tương đối. Điểm hay bị hiểu sai là không phải càng nhỏ càng tốt: sai số cắt cụt tỉ lệ nhưng sai số làm tròn tỉ lệ , nên điểm tối ưu là . Thí nghiệm ở Mục 5.5 đo được , và cho sai số lớn hơn khoảng lần.
18.3Phân loại#
Câu hỏi: Perceptron, hồi quy logistic và SVM khác nhau ở đâu?
Trả lời
Chúng giống nhau ở mô hình (hàm tuyến tính ) và thường tối ưu bằng các biến thể của gradient descent. Chúng khác nhau ở hàm mất mát, viết theo lề :
Hàm mất mát Hệ quả Perceptron bằng 0 khi : dừng ngay khi vừa phân loại đúng, không hội tụ khi dữ liệu không tách được SVM bằng 0 khi : sinh ra khái niệm lề Hồi quy logistic trơn và luôn dương: cho ra xác suất Mất mát 0–1 không dùng trực tiếp được vì đạo hàm của nó bằng 0 hầu khắp nơi. Hinge và logistic (theo logarit cơ số 2) là chặn trên lồi của mất mát 0–1; mất mát perceptron chỉ là hàm thay thế lồi, không phải chặn trên.
Câu hỏi: Hồi quy logistic và hồi quy softmax liên hệ thế nào?
Trả lời
Hồi quy softmax với hai lớp chính là hồi quy logistic, với . Softmax có vector trọng số nhưng chỉ hiệu giữa chúng được dữ liệu xác định, vì cộng cùng một vector vào tất cả không đổi xác suất. Thí nghiệm ở Mục 6.4 khớp cả hai mô hình trên cùng dữ liệu và cho trọng số lệch nhau , tức trùng nhau tới sai số làm tròn.
Câu hỏi: Vì sao hồi quy logistic thường cần regularization?
Trả lời
Khi dữ liệu tách được hoàn toàn, hàm mất mát giảm mãi khi nhân với số ngày càng lớn, nên không có nghiệm hữu hạn và . Mục 6.5 đo được: không có regularization, tăng từ 10,2 lên 34,8 khi số vòng lặp tăng từ 500 lên 50 000 mà không dừng; với , đứng yên ở 3,993. Vì vậy
LogisticRegressioncủa scikit-learn mặc định có regularization . Hệ số lớn bất thường cũng là dấu hiệu nên kiểm tra rò rỉ dữ liệu.
Câu hỏi: Naive Bayes, LDA và QDA khác nhau thế nào?
Trả lời
Với đặc trưng liên tục và mô hình Gauss cho mỗi lớp, cả ba là cùng một bộ phân loại sinh, chỉ khác ràng buộc trên ma trận hiệp phương sai: Naive Bayes Gauss dùng ma trận đường chéo riêng cho từng lớp, LDA dùng một ma trận đầy đủ chung cho mọi lớp, QDA dùng ma trận đầy đủ riêng cho từng lớp. LDA có biên tuyến tính vì khi hai lớp dùng chung , số hạng bậc hai triệt tiêu khi lấy hiệu hai hàm phân biệt; thí nghiệm ở Mục 7.4 khớp hàm quyết định của LDA bằng hàm tuyến tính với sai số . QDA linh hoạt hơn nhưng phải ước lượng ma trận hiệp phương sai, nên cần nhiều dữ liệu hơn.
Câu hỏi: Vì sao Naive Bayes vẫn phân loại tốt dù giả thiết độc lập gần như luôn sai?
Trả lời
Vì để chọn đúng nhãn chỉ cần thứ tự của các xác suất hậu nghiệm đúng, không cần giá trị của chúng đúng. Các xác suất do Naive Bayes đưa ra thường bị đẩy về gần 0 hoặc 1 quá mức, vì các bằng chứng tương quan bị đếm lặp lại, nên không nên dùng chúng như xác suất đã hiệu chuẩn.
18.4Đánh giá mô hình#
Câu hỏi: Vì sao không nên dùng độ chính xác trên dữ liệu mất cân bằng?
Trả lời
Vì một bộ phân loại vô dụng có thể đạt độ chính xác rất cao. Trong thí nghiệm ở Mục 8.1 với 0,98% lớp dương, bộ phân loại luôn đoán lớp âm đạt độ chính xác 0,9902, cao hơn một bộ phân loại phát hiện được hơn nửa số ca dương (, độ chính xác 0,9900). Nên dùng precision, recall, hoặc PR-AUC.
Câu hỏi: Khi nào dùng ROC-AUC, khi nào dùng PR-AUC?
Trả lời
Trên cùng mô hình và dữ liệu mất cân bằng ở Mục 8.3, ROC-AUC bằng 0,9715 nhưng PR-AUC chỉ bằng 0,4931. Lý do nằm ở mẫu số: FPR chia cho toàn bộ lớp âm, lớp chiếm 99% dữ liệu, nên hàng trăm dương giả hầu như không làm FPR thay đổi; precision chia cho số điểm được báo dương, nên nhạy với dương giả. Mốc so sánh cũng khác: ROC-AUC của bộ đoán ngẫu nhiên luôn là 0,5, còn PR-AUC của nó bằng tỉ lệ lớp dương, ở đây 0,01. Khi lớp dương hiếm và chất lượng của các cảnh báo là điều quan trọng, dùng PR-AUC.
Câu hỏi: Precision và recall đánh đổi nhau thế nào?
Trả lời
Qua ngưỡng quyết định. Ở Mục 8.1, hạ ngưỡng từ 2,6 xuống −1,0 làm recall tăng từ 0,52 lên 1,00 và precision giảm từ 0,49 xuống 0,012. Chọn ngưỡng là quyết định dựa trên chi phí của từng loại lỗi, không có ngưỡng đúng về mặt kỹ thuật. Khi một loại lỗi đắt hơn, có thể dùng để phản ánh điều đó.
18.5Regularization và xác suất#
Câu hỏi: Ridge và lasso khác nhau thế nào?
Trả lời
Ridge phạt , lasso phạt . Lasso cho nhiều hệ số bằng đúng 0, ridge thì không. Trong trường hợp các cột trực chuẩn, ridge nhân mỗi hệ số với , còn lasso trừ mỗi hệ số một lượng và cắt về 0 những hệ số nhỏ hơn (ngưỡng mềm). Nguyên nhân là không khả vi tại 0 và dưới vi phân tại đó là cả đoạn . Mục 9.4 đo được: ở , lasso đưa đúng 9 trong 12 hệ số về 0, trùng với 9 hệ số bằng 0 của mô hình thật, còn ridge không đưa hệ số nào về 0.
Câu hỏi: Ridge có co mọi hệ số như nhau không?
Trả lời
Không. Viết qua SVD, ridge nhân thành phần theo hướng riêng thứ với . Ở Mục 9.3 với , hướng có giá trị suy biến 12,27 giữ lại 0,938, hướng có giá trị suy biến 6,17 chỉ giữ lại 0,792. Ridge co mạnh nhất những hướng dữ liệu cung cấp ít thông tin, cũng là những hướng mà ước lượng bình phương tối thiểu có phương sai lớn nhất. Nhờ vậy ridge xử lý được đa cộng tuyến.
Câu hỏi: Regularization có nguồn gốc từ đâu?
Trả lời
Từ phân phối tiên nghiệm. Ước lượng MAP cực tiểu : số hạng thứ nhất là hàm mất mát, số hạng thứ hai là regularization. Tiên nghiệm Gauss cho ridge với , tiên nghiệm Laplace cho lasso, tiên nghiệm Dirichlet cho làm trơn Laplace. Mục 10.4 kiểm chứng: nghiệm ridge dạng đóng và nghiệm MAP tìm bằng BFGS lệch nhau . Cần nói thêm rằng MAP chỉ lấy đỉnh của hậu nghiệm, không cho biết mức độ không chắc chắn như suy luận Bayes đầy đủ.
18.6Tối ưu lồi và SVM#
Câu hỏi: Vì sao tính lồi quan trọng?
Trả lời
Với hàm lồi, mọi điểm có gradient bằng 0 là cực tiểu toàn cục, nên kết quả không phụ thuộc điểm khởi tạo. Ở Mục 11.6, gradient descent chạy từ 21 điểm xuất phát cho một điểm dừng duy nhất với hàm lồi, nhưng cho hai điểm dừng với giá trị và với hàm không lồi . Hàm mất mát của mạng nơ-ron không lồi, nên khởi tạo, chuẩn hoá và kết nối tắt trở nên quan trọng khi huấn luyện mạng sâu.
Câu hỏi: Vì sao SVM được giải qua bài toán đối ngẫu?
Trả lời
Lý do quan trọng nhất là bài toán đối ngẫu chỉ phụ thuộc vào dữ liệu qua tích vô hướng , nên thay tích vô hướng bằng một kernel là SVM làm việc được trong không gian đặc trưng phi tuyến mà không cần dựng không gian đó. Ngoài ra bài toán đối ngẫu có biến thay vì biến, có lợi khi lớn hơn , và giá trị đối ngẫu cho chặn dưới để biết nghiệm hiện tại còn cách tối ưu bao xa.
Câu hỏi: Vector hỗ trợ là gì, và vì sao chỉ chúng ảnh hưởng tới nghiệm?
Trả lời
Là những điểm có nhân tử Lagrange . Theo điều kiện bù của KKT, chỉ xảy ra khi ràng buộc của điểm đó chặt, tức điểm nằm đúng trên lề (với SVM lề cứng). Mọi điểm nằm ngoài lề có và không đóng góp vào . Đây là hệ quả của KKT, không phải lựa chọn thiết kế. Thí nghiệm ở Mục 13.3 có 3 vector hỗ trợ trên 120 điểm; bỏ 117 điểm còn lại, nghiệm không đổi.
Câu hỏi: Tham số trong SVM lề mềm có vai trò gì?
Trả lời
cân bằng giữa lề rộng và mức phạt cho các điểm vi phạm lề; nó đóng vai trò nghịch đảo của hệ số regularization, vì SVM lề mềm tương đương với mất mát hinge cộng . KKT chia các điểm thành ba nhóm: (ngoài lề), (trên lề), (vi phạm lề). Ở Mục 13.4, cho lề rộng 5,61 và cả 114 vector hỗ trợ đều vi phạm lề; cho lề 1,73 với 45 vector hỗ trợ. Với kernel tuyến tính trên dữ liệu có biên tối ưu tuyến tính, ảnh hưởng ít tới sai số kiểm tra; với kernel phi tuyến, quan trọng hơn nhiều.
Câu hỏi: Thủ thuật kernel là gì?
Trả lời
Là tính tích vô hướng trong không gian đặc trưng, , mà không cần tính . Kernel RBF tương ứng với một không gian đặc trưng vô hạn chiều, nhưng mỗi lần tính chỉ tốn . Trên dữ liệu hai đường tròn đồng tâm (Mục 13.5), kernel tuyến tính đạt độ chính xác 0,615, còn kernel đa thức bậc 2 và RBF đều đạt 1,000; kernel bậc 2 đạt tuyệt đối vì không gian đặc trưng của nó chứa .
Câu hỏi: Vì sao SVM với kernel ít được dùng cho dữ liệu rất lớn?
Trả lời
Vì chi phí, không phải vì độ chính xác. Huấn luyện cần làm việc với ma trận kernel , chi phí khoảng tới ; khi dự đoán phải tính kernel với mọi vector hỗ trợ, mà số vector hỗ trợ thường tăng theo . Mỗi epoch của SGD trên mạng nơ-ron chỉ tốn chi phí tuyến tính theo .
18.7Học không giám sát#
Câu hỏi: PCA làm gì, và khi nào nó không phù hợp?
Trả lời
PCA tìm các hướng trực giao có phương sai lớn nhất, là các vector riêng của ma trận hiệp phương sai. Sai số tái tạo khi giữ thành phần bằng đúng tổng các trị riêng bị bỏ nhân (định lý Eckart–Young; Mục 14.3 kiểm chứng tới ). PCA không dùng nhãn, nên hướng có phương sai lớn có thể vô dụng cho phân loại: ở Mục 14.4, thành phần chính thứ nhất giữ 96,1% phương sai nhưng cho AUC 0,502, trong khi hướng của LDA cho AUC 0,9987.
Câu hỏi: PCA và LDA khác nhau thế nào?
Trả lời
PCA cực đại phương sai toàn phần và không dùng nhãn. LDA cực đại tỉ số giữa tán xạ giữa các lớp và tán xạ trong lớp, và có dùng nhãn. LDA cho tối đa chiều vì ma trận tán xạ giữa các lớp có hạng không quá . Hướng của LDA, , trùng với vector trọng số của bộ phân loại Gauss dùng chung ma trận hiệp phương sai ở Mục 7.4.
Câu hỏi: K-means bảo đảm được điều gì?
Trả lời
Chỉ bảo đảm dừng ở một cực tiểu địa phương, vì bài toán tìm nghiệm tối ưu là NP-khó và hàm mục tiêu không lồi. Ở Mục 15.2, trên dữ liệu 8 cụm, khởi tạo ngẫu nhiên cho nghiệm tồi trong 71,5% số lần chạy, k-means++ giảm xuống 46,5%. Vì vậy cần chạy nhiều lần; lưu ý scikit-learn từ phiên bản 1.4 mặc định chỉ chạy một lần với k-means++. K-means còn giả định cụm lồi, gần tròn, kích thước tương đương và các chiều cùng thang đo: trên hai dải dẹt song song nó chỉ đạt độ chính xác 0,53.
Câu hỏi: Chọn số cụm thế nào?
Trả lời
Không chọn bằng cách cực tiểu inertia, vì inertia luôn giảm theo và bằng 0 khi . Phương pháp elbow tìm chỗ inertia ngừng giảm nhanh: ở Mục 15.4, mức giảm là 27,7% khi lên rồi chỉ còn 5,4% khi lên . Elbow không có định nghĩa chặt và thường không rõ trên dữ liệu thật; có thể dùng hệ số silhouette hoặc gap statistic, và trong nhiều trường hợp do yêu cầu nghiệp vụ quyết định.
Câu hỏi: Phân rã ma trận cần bao nhiêu dữ liệu?
Trả lời
Cần số đánh giá mỗi người dùng lớn hơn hạng nhiều lần. Trong thí nghiệm ở Mục 16.3 với hạng thật , ở 10,1 đánh giá mỗi người RMSE là 3,54, tệ hơn cả đoán mọi ô bằng 0 (2,08); ở 19,8 đánh giá mỗi người RMSE giảm xuống 0,30. Mỗi người dùng có ẩn số, và vì đánh giá có nhiễu còn các vector sản phẩm cũng đang được ước lượng, số đánh giá cần thiết lớn hơn nhiều lần.
Câu hỏi: Vì sao khởi đầu lạnh là vấn đề nghiêm trọng?
Trả lời
Với người dùng chưa có đánh giá nào, hàm mất mát chỉ còn thành phần regularization , có cực tiểu tại , nên mô hình dự đoán gần 0 cho mọi sản phẩm. Ở Mục 16.5, RMSE cho người dùng mới là 2,24, tệ hơn đoán bằng 0 (2,08). Vì vậy hệ thống thực tế cần kết hợp lọc dựa trên nội dung với lọc cộng tác.
18.8Các câu trả lời chưa đạt#
| Câu trả lời | Vì sao chưa đạt |
|---|---|
| "Bình phương sai số vì nó phạt sai số lớn nặng hơn." | Đúng nhưng chưa đủ: chưa nêu được bình phương sai số là MLE dưới giả thiết nhiễu Gauss. |
| "Đa cộng tuyến làm mô hình dự đoán kém." | Sai: nó làm hệ số dao động, còn dự đoán gần như không đổi. |
| "Gradient descent chậm vì bài toán có nhiều chiều." | Sai: tốc độ phụ thuộc số điều kiện, không phụ thuộc số chiều. |
| "Kiểm tra gradient thì càng nhỏ càng tốt." | Sai: quá nhỏ làm sai số làm tròn lớn lên; điểm tối ưu cỡ . |
| "Mô hình đạt độ chính xác 99% nên rất tốt." | Trên dữ liệu có 1% lớp dương, bộ phân loại luôn đoán lớp âm cũng đạt 99%. |
| "ROC-AUC 0,97 nghĩa là mô hình rất tốt." | Trên dữ liệu mất cân bằng, cùng mô hình đó có thể có PR-AUC chỉ 0,49. |
| "Ridge và lasso về cơ bản giống nhau." | Lasso cho hệ số bằng đúng 0, ridge thì không; đây là khác biệt về bản chất. |
| "Regularization chỉ là một mẹo để chống overfitting." | Chưa đủ: regularization tương ứng với một phân phối tiên nghiệm (ridge là MAP với tiên nghiệm Gauss). |
| "SVM tốt vì tìm được biên tối ưu." | Chưa rõ tối ưu theo nghĩa nào: cần nói là lề lớn nhất, và vì sao lề lớn giúp tổng quát hoá. |
| "Kernel RBF ánh xạ dữ liệu lên không gian nhiều chiều rồi phân loại ở đó." | Thiếu ý chính: phép ánh xạ đó không bao giờ được tính tường minh. |
| "PCA giữ 95% phương sai nên gần như không mất thông tin." | Phương sai lớn không có nghĩa là hữu ích: có trường hợp giữ 96,1% phương sai mà AUC chỉ 0,502. |
| "K-means tìm được cụm tối ưu." | Bài toán NP-khó; thuật toán chỉ cho cực tiểu địa phương, kể cả khi dùng k-means++. |
| "Naive Bayes giả định các đặc trưng độc lập." | Thiếu điều kiện quan trọng: độc lập có điều kiện khi đã biết lớp. |
| "Chọn cho K-means bằng cách cực tiểu inertia." | Inertia luôn giảm theo và bằng 0 khi . |
19Tài liệu tham khảo#
Sách
- T. Hastie, R. Tibshirani, J. Friedman. The Elements of Statistical Learning, 2nd ed. Springer, 2009. Nguồn cho ridge, lasso, LDA và QDA, công thức co và số bậc tự do hiệu dụng ở Mục 9.3.
- C. M. Bishop. Pattern Recognition and Machine Learning. Springer, 2006. Nguồn cho cách hiểu regularization như ước lượng MAP và cho các bộ phân loại Gauss.
- K. P. Murphy. Machine Learning: A Probabilistic Perspective. MIT Press, 2012. Trình bày học máy thống nhất theo góc nhìn xác suất như Chương 10.
- S. Boyd, L. Vandenberghe. Convex Optimization. Cambridge University Press, 2004. Nguồn cho Chương 11 và 12: tập lồi, hàm lồi, đối ngẫu Lagrange, điều kiện Slater và KKT. Sách được phát hành miễn phí trên trang của tác giả.
- G. Strang. Introduction to Linear Algebra, 5th ed. Wellesley–Cambridge Press, 2016. Nền cho Chương 2.
- T. Hastie, R. Tibshirani, M. Wainwright. Statistical Learning with Sparsity: The Lasso and Generalizations. CRC Press, 2015. Chuyên sâu về lasso và nghiệm thưa.
- T. M. Mitchell. Machine Learning. McGraw-Hill, 1997. Nguồn của định nghĩa học máy ở Mục 1.1.
- V. N. Vapnik. The Nature of Statistical Learning Theory. Springer, 1995. Nguồn cho lý thuyết lề và chiều VC ở Mục 13.1.
Bài báo gốc
- A. E. Hoerl, R. W. Kennard. Ridge Regression: Biased Estimation for Nonorthogonal Problems. Technometrics, 1970.
- R. Tibshirani. Regression Shrinkage and Selection via the Lasso. Journal of the Royal Statistical Society, Series B, 1996.
- H. Zou, T. Hastie. Regularization and Variable Selection via the Elastic Net. Journal of the Royal Statistical Society, Series B, 2005.
- F. Rosenblatt. The Perceptron: A Probabilistic Model for Information Storage and Organization in the Brain. Psychological Review, 1958.
- A. B. J. Novikoff. On Convergence Proofs on Perceptrons. Symposium on the Mathematical Theory of Automata, 1962. Nguồn của Định lý 6.1.
- T. Cover, P. Hart. Nearest Neighbor Pattern Classification. IEEE Transactions on Information Theory, 1967. Nguồn của Định lý 7.1.
- A. Y. Ng, M. I. Jordan. On Discriminative vs. Generative Classifiers: A Comparison of Logistic Regression and Naive Bayes. NIPS, 2002. Nguồn cho so sánh ở Mục 7.1.
- D. Soudry, E. Hoffer, M. S. Nacson, S. Gunasekar, N. Srebro. The Implicit Bias of Gradient Descent on Separable Data. Journal of Machine Learning Research, 2018. Nguồn cho nhận xét về tốc độ tăng của ở Mục 6.5.
- B. E. Boser, I. M. Guyon, V. N. Vapnik. A Training Algorithm for Optimal Margin Classifiers. COLT, 1992. Nguồn của thủ thuật kernel cho SVM.
- C. Cortes, V. Vapnik. Support-Vector Networks. Machine Learning, 1995. Nguồn của SVM lề mềm và tham số .
- J. Platt. Sequential Minimal Optimization: A Fast Algorithm for Training Support Vector Machines. Microsoft Research Technical Report, 1998. Thuật toán nền của libsvm.
- R. A. Fisher. The Use of Multiple Measurements in Taxonomic Problems. Annals of Eugenics, 1936. Nguồn của LDA.
- K. Pearson. On Lines and Planes of Closest Fit to Systems of Points in Space. Philosophical Magazine, 1901. Nguồn của PCA.
- C. Eckart, G. Young. The Approximation of One Matrix by Another of Lower Rank. Psychometrika, 1936. Định lý ở Mục 14.3.
- S. P. Lloyd. Least Squares Quantization in PCM. IEEE Transactions on Information Theory, 1982 (báo cáo nội bộ năm 1957). Thuật toán K-means.
- D. Arthur, S. Vassilvitskii. k-means++: The Advantages of Careful Seeding. SODA, 2007. Nguồn của cách khởi tạo ở Mục 15.2.
- R. Tibshirani, G. Walther, T. Hastie. Estimating the Number of Clusters in a Data Set via the Gap Statistic. Journal of the Royal Statistical Society, Series B, 2001.
- Y. Koren, R. Bell, C. Volinsky. Matrix Factorization Techniques for Recommender Systems. IEEE Computer, 2009. Nguồn chính cho Chương 16.
- Y. Hu, Y. Koren, C. Volinsky. Collaborative Filtering for Implicit Feedback Datasets. ICDM, 2008. ALS cho phản hồi ngầm.
- E. J. Candès, B. Recht. Exact Matrix Completion via Convex Optimization. Foundations of Computational Mathematics, 2009. Nguồn cho nhận xét lý thuyết ở Mục 16.3.
Tối ưu hoá
- H. Robbins, S. Monro. A Stochastic Approximation Method. Annals of Mathematical Statistics, 1951. Điều kiện về tốc độ học ở Mục 5.6.
- B. T. Polyak. Some Methods of Speeding up the Convergence of Iteration Methods. USSR Computational Mathematics and Mathematical Physics, 1964. Phương pháp heavy ball (momentum) ở Mục 5.3.
- Y. Nesterov. A Method of Solving a Convex Programming Problem with Convergence Rate . Soviet Mathematics Doklady, 1983.
- L. Bottou, F. E. Curtis, J. Nocedal. Optimization Methods for Large-Scale Machine Learning. SIAM Review, 2018. Tổng quan về SGD và các biến thể.
Đánh giá mô hình
- T. Fawcett. An Introduction to ROC Analysis. Pattern Recognition Letters, 2006.
- J. Davis, M. Goadrich. The Relationship Between Precision-Recall and ROC Curves. ICML, 2006. Nguồn cho lập luận ở Mục 8.3.
- T. Saito, M. Rehmsmeier. The Precision-Recall Plot Is More Informative than the ROC Plot When Evaluating Binary Classifiers on Imbalanced Datasets. PLOS ONE, 2015.
Tính toán số
- N. J. Higham. Accuracy and Stability of Numerical Algorithms, 2nd ed. SIAM, 2002. Nguồn cho phân tích ở Mục 5.5 và cho nhận xét .
Tài liệu tiếng Việt
- A. Amidi, S. Amidi. Cheatsheet CS229 và CS230 (bản dịch tiếng Việt). Stanford University, stanford.edu/~shervine/l/vi. Nguồn tham khảo cho quy ước thuật ngữ ở Mục 0.2.
- Vũ Hữu Tiệp. Machine Learning cơ bản. machinelearningcoban.com. Bộ bài giảng tiếng Việt đầy đủ về học máy cổ điển, có mã Python cho từng thuật toán.
- Phạm Đình Khánh. Deep AI KhanhBlog. phamdinhkhanh.github.io. Các bài viết về học máy, thị giác máy tính và xử lý ngôn ngữ tự nhiên.
Nhận xét (Về các tài liệu tiếng Việt)
Hai trang 38 và 39 được giới thiệu như tài liệu đọc thêm. Giáo trình này không sao chép nội dung hay hình ảnh của chúng: phần chữ được viết riêng và mọi số liệu, hình vẽ đều sinh từ mã trong
code/nentang/. Trang Machine Learning cơ bản ghi rõ mọi hình thức sao chép cần được tác giả đồng ý.
Phụ lục: chạy lại toàn bộ thí nghiệm#
code/nentang/
├── experiments.py            # Hình 2, 3, 4, 6, 7, 8, 9, 10, 11, 12 và mọi số liệu đo được
├── experiments_output.txt    # kết quả in ra của script trên
└── fig_diagrams.py           # Hình 1, 5, 13 (các sơ đồ khái niệm)
pip install numpy scipy matplotlib scikit-learn
python code/nentang/experiments.py      # vài phút
python code/nentang/fig_diagrams.py
Hai script đặt hạt giống cố định nên mọi con số trong giáo trình lặp lại được trên cùng phiên bản thư viện. Môi trường đã dùng: Python 3.13, NumPy 2.3, SciPy 1.16, scikit-learn 1.7, matplotlib 3.10.
Giáo trình không dùng con số nào trích từ bài báo; mọi số liệu đều sinh tại chỗ, và chia làm hai loại.
Loại thứ nhất là kiểm chứng đẳng thức. Những kết quả này phải khớp tới sai số của máy tính; nếu không khớp thì mã có lỗi.
| Đẳng thức | Sai số đo được |
|---|---|
| Hồi quy logistic trùng hồi quy softmax với | |
| Ba cách giải bình phương tối thiểu cho cùng nghiệm | |
| PCA qua ma trận hiệp phương sai trùng PCA qua SVD | |
| Eckart–Young: sai số tái tạo bằng | cỡ |
| Ridge qua SVD trùng ridge dạng đóng | |
| Hàm quyết định của LDA là tuyến tính | |
| SVM: | |
| SVM: khe đối ngẫu bằng 0 | |
| Tích các Gauss một chiều trùng Gauss nhiều chiều với đường chéo | |
| Ridge dạng đóng trùng MAP tìm bằng BFGS |
Bốn dòng cuối không đạt tới sai số làm tròn vì bị giới hạn bởi dung sai dừng của bộ giải (libsvm, BFGS) hoặc bởi lượng nhỏ cộng thêm vào đường chéo để nghịch đảo ma trận ổn định. Giáo trình in ra đúng con số đo được.
Loại thứ hai là mô phỏng trên dữ liệu sinh ngẫu nhiên, gồm các bảng về số vòng lặp, độ chính xác, RMSE và tỉ lệ kẹt ở nghiệm tồi. Chúng cho thấy một cơ chế tồn tại và có độ lớn đáng kể, nhưng không dùng để suy ra con số cho một tập dữ liệu thật cụ thể. Ở những chỗ kết quả yếu hơn kỳ vọng, như ảnh hưởng nhỏ của với SVM tuyến tính ở Mục 13.4, giáo trình ghi nhận đúng như vậy.