14Giảm chiều dữ liệu#
Dữ liệu thật thường có hàng trăm đặc trưng, nhưng chỉ vài hướng trong số đó thật sự mang thông tin, phần còn lại là nhiễu hoặc lặp lại những gì đã có. Nếu tìm được các hướng đó, ta nén được dữ liệu, khử được nhiễu, và vẽ được dữ liệu lên mặt phẳng để nhìn. Phương pháp tuyến tính phổ biến nhất cho việc này là PCA, và nó hoá ra chỉ là phân tích trị riêng của ma trận hiệp phương sai ở Chương 3. Ta cũng sẽ thấy giới hạn của PCA khi dữ liệu có nhãn, và phương pháp thay thế có dùng nhãn là LDA. Một ví dụ hai chiều đủ nhỏ để tính tay mọi bước, điểm hai bài kiểm tra của bốn sinh viên, đi suốt chương.
14.1Mục đích của giảm chiều#
Giảm chiều là biến đổi dữ liệu từ chiều xuống chiều mà giữ lại càng nhiều thông tin hữu ích càng tốt. Lý do đầu tiên để làm việc này là tính toán: thuật toán chạy nhanh hơn và tốn ít bộ nhớ hơn trên dữ liệu ít chiều. Lý do thứ hai là thống kê: ít chiều hơn nghĩa là ít tham số hơn cho mô hình phía sau, nên phương sai của ước lượng nhỏ hơn, và theo nghĩa này giảm chiều là một dạng regularization. Lý do thứ ba là trực quan hoá: con người không nhìn được dữ liệu 100 chiều, nhưng nhìn được hình chiếu của nó lên mặt phẳng hai chiều. Ngoài ra, lời nguyền số chiều ở Mục 7.2 khiến khoảng cách mất dần ý nghĩa khi số chiều tăng, nên các phương pháp dựa trên khoảng cách như k-NN và K-means thường cần giảm chiều trước.
14.2Phân tích thành phần chính (PCA)#
PCA (Pearson, 1901) tìm các hướng mà dữ liệu trải rộng nhất. Hình dung một đám mây điểm có dạng hình elip dẹt trong mặt phẳng: trục dài của elip là hướng giữ được nhiều thông tin nhất về vị trí các điểm, và chiếu mọi điểm lên trục đó mất ít thông tin nhất.
Ví dụ của chương là điểm hai bài kiểm tra của bốn sinh viên A, B, C, D, đã trừ điểm trung bình của lớp ở mỗi bài:
| Sinh viên | A | B | C | D |
|---|---|---|---|---|
| Bài 1, | 2 | 1 | −1 | −2 |
| Bài 2, | 1 | 2 | −2 | −1 |
Bốn điểm nằm dọc theo đường chéo : người làm tốt bài này thường cũng làm tốt bài kia. Đám mây điểm là một elip dẹt với trục dài nằm trên đường chéo đó.
Gọi là ma trận dữ liệu đã trừ trung bình của từng cột, và là ma trận hiệp phương sai mẫu (Mục 3.3). Chiếu dữ liệu lên hướng đơn vị cho các toạ độ , có phương sai . PCA tìm hướng làm phương sai này lớn nhất:
Ràng buộc là cần thiết, vì không có nó thì nhân với số lớn làm phương sai lớn tuỳ ý. Lập hàm Lagrange và cho gradient theo bằng 0, ta được
Vậy hướng tối ưu là một vector riêng của , và phương sai đạt được đúng bằng trị riêng tương ứng. Để phương sai lớn nhất, ta chọn vector riêng ứng với trị riêng lớn nhất.
Với bốn sinh viên, dữ liệu đã có trung bình bằng 0. Ma trận có các phần tử , và , nên
Hai vector riêng là với trị riêng và với ; có thể kiểm tra trực tiếp, chẳng hạn . Thành phần chính thứ nhất là hướng "làm tốt cả hai bài", thành phần thứ hai là hướng "làm bài 1 tốt hơn bài 2".
Định nghĩa 14.1 (Thành phần chính)
Gọi là các trị riêng của ma trận hiệp phương sai và là các vector riêng trực chuẩn tương ứng. Vector gọi là thành phần chính (principal component) thứ . PCA với thành phần biểu diễn mỗi điểm bằng toạ độ , .
Thành phần thứ hai là hướng có phương sai lớn nhất trong các hướng vuông góc với thành phần thứ nhất, và cứ tiếp tục như vậy. Theo định lý phổ, các vector riêng của ma trận đối xứng trực giao với nhau, nên các thành phần chính tự động vuông góc, và các toạ độ không tương quan với nhau. Tỉ lệ gọi là tỉ lệ phương sai được giải thích bởi thành phần thứ . Với bốn sinh viên, toạ độ theo thành phần thứ nhất là , bằng cho A và B, cho C và D. Phương sai của bốn toạ độ này là , đúng bằng , và thành phần thứ nhất giải thích phương sai.
PCA tính được theo hai cách: bằng phân tích trị riêng của , hoặc bằng SVD của , vì theo Mục 2.6 các vector riêng của là các cột của và trị riêng của là . Thí nghiệm tính theo cả hai cách trên dữ liệu 8 chiều và in ra bốn trị riêng đầu:
tri rieng cua ma tran hiep phuong sai : [11.52671  4.855133  2.064187  0.142466]
d_i^2/(n-1) tu SVD                    : [11.52671  4.855133  2.064187  0.142466]
lech lon nhat tren ca 8 tri: 7.105e-15
goc giua cac truc chinh: [1. 1. 1. 1.]
Hai cách cho cùng trị riêng tới , và các trục chính trùng nhau: trị tuyệt đối cosine giữa các cặp trục tương ứng bằng 1, vì vector riêng chỉ xác định tới dấu. Trên thực tế nên dùng SVD của , vì cách này không cần lập , phép toán làm bình phương số điều kiện (Mục 2.6).
Lưu ý (Chuẩn hoá trước PCA)
PCA tìm hướng có phương sai lớn, nên kết quả phụ thuộc vào đơn vị đo. Nếu một đặc trưng đo bằng milimét và các đặc trưng khác đo bằng mét, phương sai của đặc trưng đó lớn hơn một triệu lần và thành phần chính thứ nhất gần như trùng với nó. Khi các đặc trưng có đơn vị khác nhau, cần chuẩn hoá mỗi đặc trưng về phương sai bằng 1 trước khi áp dụng PCA.
14.3Định lý Eckart–Young và sai số tái tạo#
Từ toạ độ có thể dựng lại gần đúng điểm ban đầu: . Câu hỏi tự nhiên là dựng lại được chính xác tới đâu.
Định lý 14.1 (Eckart–Young, 1936)
Gọi là ma trận tái tạo từ thành phần chính đầu tiên. Khi đó
và là ma trận hạng gần nhất theo chuẩn Frobenius: không có ma trận hạng nào cho sai số nhỏ hơn.
Vế phải của đẳng thức là tổng các trị riêng bị bỏ đi, nhân với . Vậy sai số tái tạo bằng đúng phần phương sai không được giữ lại, và đây là đẳng thức chính xác chứ không phải xấp xỉ. Với bốn sinh viên và , mỗi điểm được dựng lại bằng hình chiếu của nó lên : A và B thành , C và D thành . Mỗi điểm lệch khỏi bản dựng lại một vector có bình phương độ dài 0,5, nên , đúng bằng . Thí nghiệm dùng 300 điểm 8 chiều sinh từ 3 thành phần thật cộng nhiễu để kiểm tra đẳng thức trên dữ liệu lớn hơn.
| Chênh lệch | Phương sai giữ lại | |||
|---|---|---|---|---|
| 1 | 2242,010603 | 2242,010603 | 60,59% | |
| 2 | 790,325815 | 790,325815 | 86,11% | |
| 3 | 173,133807 | 173,133807 | 96,96% | |
| 4 | 130,536554 | 130,536554 | 97,71% | |
| 8 | 0,000000 | 0,000000 | 100,00% |
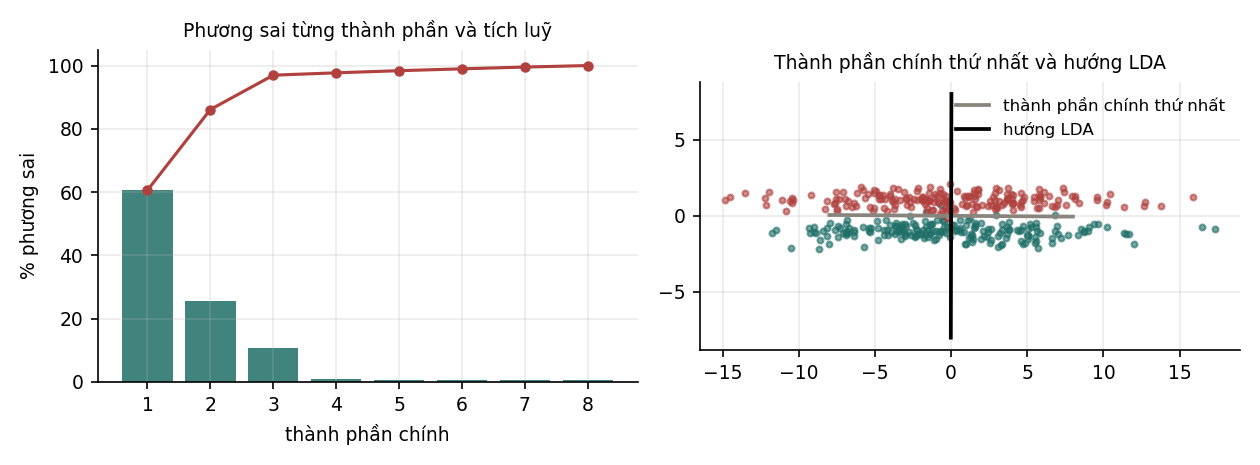
Hai cột giữa trùng nhau tới ở mọi . Cột cuối cho thấy cách chọn : phương sai giữ lại tăng nhanh tới (96,96%) rồi gần như dừng lại (97,71% ở ). Chỗ đồ thị phương sai tích luỹ gãy gập là dấu hiệu của số chiều thật của dữ liệu, và ở đây nó khớp với 3 thành phần đã dùng để sinh dữ liệu. Một quy tắc thường dùng khác là chọn nhỏ nhất giữ được một tỉ lệ phương sai cho trước, như 90% hoặc 95%.
14.4Hạn chế của PCA và phân tích biệt thức tuyến tính (LDA)#
PCA không dùng nhãn. Nó tìm hướng có phương sai lớn, nhưng phương sai lớn không có nghĩa là hữu ích cho bài toán phân loại. Bốn sinh viên cho thấy điều này. Gắn cho mỗi người nhãn "sa sút" nếu điểm bài 2 thấp hơn bài 1 và "tiến bộ" nếu ngược lại: A và C sa sút, B và D tiến bộ. Theo thành phần chính thứ nhất, A và B có cùng toạ độ , C và D cùng toạ độ , nên hướng giữ 90% phương sai không phân biệt được hai nhóm chút nào. Toàn bộ thông tin về nhãn nằm ở thành phần thứ hai, chiếm 10% phương sai và bị PCA với bỏ đi: theo , hai người sa sút có toạ độ , hai người tiến bộ có .
Thí nghiệm dựng dữ liệu hai lớp có một hướng nhiễu biên độ lớn, theo đó hai lớp trộn lẫn, và một hướng tín hiệu biên độ nhỏ, theo đó hai lớp tách nhau:
truc chinh thu nhat cua PCA: [-1.  0.0067]   (giu 96.1% phuong sai)
huong cua LDA              : [0.0025  1.]
AUC khi chieu len truc PCA : 0.5020
AUC khi chieu len huong LDA: 0.9987
Thành phần chính thứ nhất giữ 96,1% phương sai, nhưng chiếu dữ liệu lên nó cho ROC-AUC 0,502, không tốt hơn đoán ngẫu nhiên. Hướng do LDA chọn gần như vuông góc với trục đó và cho AUC 0,9987, giống thành phần thứ hai của bốn sinh viên.
Phương pháp dùng nhãn để giải quyết vấn đề này là phân tích biệt thức tuyến tính (linear discriminant analysis, LDA; Fisher, 1936), tìm hướng tách các lớp tốt nhất. Với hai lớp, gọi là trung bình của mỗi lớp, là ma trận tán xạ trong lớp, tức tổng các ma trận hiệp phương sai của hai lớp, và là ma trận tán xạ giữa các lớp. Chiếu dữ liệu lên hướng , LDA muốn khoảng cách giữa trung bình hai lớp lớn trong khi độ phân tán bên trong mỗi lớp nhỏ:
Công thức nghiệm có cách hiểu trực quan: hướng nối hai trung bình là lựa chọn tự nhiên, nhưng cần "chỉnh" lại bằng để giảm trọng số của những hướng có phân tán trong lớp lớn. Trong thí nghiệm, hướng nhiễu có phân tán trong lớp lớn nên bị giảm trọng số gần như hoàn toàn. Bảng dưới so sánh hai phương pháp.
| PCA | LDA | |
|---|---|---|
| Dùng nhãn | không | có |
| Tối đa hoá | phương sai toàn phần | tỉ số tán xạ giữa lớp / tán xạ trong lớp |
| Số chiều ra tối đa | ||
| Dùng khi | nén, khử nhiễu, trực quan hoá | tiền xử lý cho phân loại |
Giới hạn chiều của LDA đến từ hạng của : với lớp, được dựng từ vector trung bình lệch khỏi trung bình chung, và các vector này có tổng có trọng số bằng 0, nên có hạng không quá . Với hai lớp, LDA cho đúng một chiều.
LDA ở đây và bộ phân loại LDA ở Mục 7.4 là cùng một phương pháp nhìn từ hai phía: hướng chính là vector trọng số trong hàm phân biệt tuyến tính của bộ phân loại Gauss dùng chung ma trận hiệp phương sai.
Khi chọn phương pháp giảm chiều, câu hỏi đầu tiên là có nhãn hay không và mục đích là gì. Không có nhãn, hoặc mục đích là nén và khử nhiễu, thì dùng PCA. Có nhãn và mục đích cuối là phân loại thì nên thử LDA. Khi cần giữ cấu trúc phi tuyến, có PCA với kernel, dùng cùng thủ thuật kernel ở Mục 13.5, và t-SNE hoặc UMAP để trực quan hoá. t-SNE không cung cấp ánh xạ cho điểm dữ liệu mới và làm biến dạng khoảng cách toàn cục, nên chỉ dùng để quan sát, không dùng làm bước tiền xử lý cho mô hình.
14.5Tóm tắt#
PCA tìm các hướng có phương sai lớn nhất, và lời giải của bài toán tối ưu có ràng buộc đó là các vector riêng của ma trận hiệp phương sai, với phương sai bằng trị riêng tương ứng. Với điểm hai bài kiểm tra của bốn sinh viên, thành phần chính thứ nhất là , hướng "làm tốt cả hai bài", và giữ 90% phương sai. Nên tính PCA bằng SVD của dữ liệu đã trừ trung bình, và chuẩn hoá đặc trưng trước khi áp dụng nếu đơn vị đo khác nhau. Theo định lý Eckart–Young, sai số tái tạo bằng đúng tổng các trị riêng bị bỏ đi nhân với : bằng 2 với bốn sinh viên và , và thí nghiệm xác nhận đẳng thức tới ; chỗ đồ thị phương sai tích luỹ gãy gập cho biết số chiều thật của dữ liệu. PCA không dùng nhãn nên có thể giữ đúng hướng vô dụng cho phân loại: với nhãn tiến bộ hay sa sút, toàn bộ thông tin của bốn sinh viên nằm ở 10% phương sai bị bỏ đi, và trong thí nghiệm, hướng giữ 96,1% phương sai chỉ cho AUC 0,502. LDA dùng nhãn và chọn hướng .
Giảm chiều tìm cấu trúc theo các hướng trong không gian đặc trưng. Một câu hỏi khác về dữ liệu không nhãn là các điểm có tự gom thành nhóm hay không. Chương 15 xét thuật toán phân cụm phổ biến nhất, K-means.
Tự kiểm tra
4 câu. Chọn đáp án để xem ngay lời giải thích.
1Định lý Eckart–Young phát biểu điều gì?
2Khi nào PCA không phù hợp làm bước tiền xử lý cho phân loại?
Vì sao: Ở Mục 14.4, thành phần chính thứ nhất giữ 96,1% phương sai nhưng cho AUC 0,502, trong khi hướng của LDA cho AUC 0,9987.3LDA cho tối đa bao nhiêu chiều?
Vì sao: Với hai lớp, LDA cho đúng một chiều, theo hướng .4Vì sao thường phải chuẩn hoá đặc trưng trước PCA?
Vì sao: Chuẩn hoá mỗi đặc trưng về phương sai 1 tương đương với làm PCA trên ma trận tương quan. Ngoại lệ là khi mọi đặc trưng đã cùng đơn vị, như cường độ điểm ảnh.
Đã trả lời 0/4