11Tập lồi và hàm lồi#
Tính lồi là ranh giới giữa những bài toán tối ưu có bảo đảm và những bài toán không có. Ở các chương trước, ta đã nhiều lần dựa vào nó mà chưa nói rõ. Ở Chương 5, gradient descent cho bốn căn hộ xuất phát từ , và ta coi điểm nó dừng là nghiệm tốt nhất mà không thử điểm xuất phát nào khác. Ở Chương 6, nghiệm của sáu sinh viên cũng được tìm bằng một lần chạy tối ưu duy nhất. Cả hai lần, điều cho phép làm vậy là tính lồi. Ở đây ta định nghĩa tập lồi và hàm lồi cho chặt chẽ, học cách nhận ra một hàm lồi mà không phải chứng minh từ đầu, và thấy bằng thí nghiệm điều gì xảy ra với gradient descent khi tính lồi mất đi. Các khái niệm này cũng là nền cho lý thuyết đối ngẫu ở Chương 12 và SVM ở Chương 13.
11.1Vai trò của tính lồi trong tối ưu#
Với bài toán tối ưu lồi, mọi cực tiểu địa phương đều là cực tiểu toàn cục. Vì vậy điểm khởi tạo không ảnh hưởng tới chất lượng nghiệm, không cần chạy lại nhiều lần với các khởi tạo khác nhau, và khi thuật toán dừng ở một điểm có gradient bằng 0, ta biết chắc đó là nghiệm tốt nhất.
Hồi quy tuyến tính, hồi quy logistic, ridge, lasso và SVM đều là bài toán lồi. Hàm mất mát của mạng nơ-ron có từ hai lớp trở lên thì không lồi, nên không có bảo đảm nào như trên: kết quả phụ thuộc vào khởi tạo, và không có cách nào biết chắc còn nghiệm tốt hơn hay không. Phần lớn kỹ thuật huấn luyện mạng sâu, như khởi tạo cẩn thận, chuẩn hoá và kết nối tắt, tồn tại để xử lý hậu quả của việc mất tính lồi.
Chương này và Chương 12 còn là nền cho SVM. Không có lý thuyết đối ngẫu thì không suy ra được bài toán đối ngẫu của SVM, và không có bài toán đối ngẫu thì không thấy được kernel.
11.2Tập lồi#
Định nghĩa 11.1 (Tập lồi)
Tập là tập lồi nếu đoạn thẳng nối hai điểm bất kỳ của nằm trọn trong :
Bảng dưới cho vài ví dụ ở cả hai phía.
| Tập lồi | Tập không lồi |
|---|---|
| Hình cầu, hình hộp, nửa không gian | Hình vành khuyên, hình chữ U |
| Siêu phẳng, giao của nhiều nửa không gian (khối đa diện) | Hợp của hai hình tròn rời nhau |
| Bao lồi của một tập điểm bất kỳ | Mặt cầu (chỉ phần vỏ) |
Hình cầu lồi vì với trong hình cầu, bất đẳng thức tam giác cho . Lập luận tương tự áp dụng cho quả cầu của mọi chuẩn, trong đó có hình thoi ở Mục 2.3.
Chương 13 dùng hai tính chất của tập lồi. Giao của các tập lồi là tập lồi, vì nếu hai điểm cùng thuộc mọi tập thì đoạn nối chúng cũng thuộc mọi tập; do đó miền thoả mãn một hệ ràng buộc tuyến tính, là giao của các nửa không gian, luôn là tập lồi. Ngược lại, hợp của các tập lồi thường không lồi, như hai hình tròn rời nhau.
11.3Hàm lồi#
Định nghĩa 11.2 (Hàm lồi)
Hàm xác định trên một tập lồi là hàm lồi nếu với mọi và mọi :
là lồi chặt nếu bất đẳng thức là chặt với mọi và .
Nói bằng lời, đoạn thẳng nối hai điểm trên đồ thị, tức dây cung, luôn nằm phía trên đồ thị. Lấy , , và : đồ thị ở điểm giữa có độ cao , còn trung điểm của dây cung ở độ cao , nên dây cung nằm trên. Với , lấy và : , nên dây cung là đoạn nằm ngang ở độ cao , trong khi cao hơn nó 2 đơn vị. Một bộ ba như vậy đủ để kết luận hàm không lồi.
Với hàm khả vi, có hai điều kiện tương đương dễ dùng hơn định nghĩa.
Định lý 11.1 (Điều kiện bậc nhất và bậc hai)
Cho khả vi trên tập lồi mở.
- lồi khi và chỉ khi với mọi : .
- Nếu khả vi hai lần, lồi khi và chỉ khi ma trận Hessian nửa xác định dương tại mọi . Với hàm một biến: .
Điều kiện bậc hai cho lại kết luận về mà không cần tìm bộ ba vi phạm: đạo hàm cấp hai âm khi , đúng vùng quanh điểm 0 nơi dây cung nằm dưới đồ thị. Điều kiện bậc nhất nói rằng tiếp tuyến, hay siêu phẳng tiếp xúc, tại mọi điểm luôn nằm dưới đồ thị. Từ đó suy ra ngay tính chất quan trọng nhất của hàm lồi.
Định lý 11.2 (Cực tiểu của hàm lồi)
Nếu lồi và khả vi thì mọi điểm có là cực tiểu toàn cục. Nếu lồi chặt thì cực tiểu toàn cục, nếu tồn tại, là duy nhất.
Chứng minh
Thay vào điều kiện bậc nhất: với mọi . Nếu có hai cực tiểu của hàm lồi chặt, điểm giữa của chúng có giá trị nhỏ hơn giá trị cực tiểu theo định nghĩa lồi chặt, mâu thuẫn.
Ví dụ 11.1
Hàm mất mát của hồi quy tuyến tính, , có Hessian , nửa xác định dương (Mục 2.5), nên lồi. Nếu đủ hạng cột thì Hessian xác định dương, lồi chặt và nghiệm duy nhất, đúng như Định lý 4.1. Với bốn căn hộ, hàm mất mát ở Mục 5.2 có Hessian , xác định dương, nên là cực tiểu toàn cục duy nhất, và gradient descent xuất phát từ đâu cũng về đó. Hàm có nên lồi chặt, nhưng không có cực tiểu: nó giảm dần về 0 khi . Ví dụ này cho thấy Định lý 11.2 chỉ nói về tính duy nhất, không bảo đảm cực tiểu tồn tại, và đây đúng là tình huống của hồi quy logistic trên dữ liệu tách được ở Mục 6.5.
11.4Kiểm tra tính lồi bằng thực nghiệm#
Định nghĩa 11.2 gợi ý một phép thử bằng số: chọn ngẫu nhiên nhiều cặp điểm và hệ số , rồi kiểm tra bất đẳng thức. Thí nghiệm thực hiện phép thử này trên 20 000 bộ ba cho mỗi hàm, với cột "vi phạm lớn nhất" là giá trị lớn nhất của .
| Hàm | Vi phạm lớn nhất | Tỉ lệ vi phạm | Kết luận |
|---|---|---|---|
| 0,0000 | lồi | ||
| 0,0000 | lồi | ||
| 0,0000 | lồi | ||
| (mất mát logistic) | 0,0000 | lồi | |
| 0,2075 | không lồi | ||
| 0,5051 | không lồi | ||
| 0,4985 | không lồi |
Với bốn hàm đầu, giá trị vi phạm lớn nhất không dương: các số âm rất nhỏ chỉ là sai số làm tròn ở những bộ ba có hai điểm gần nhau. Với ba hàm sau, có hàng nghìn bộ ba vi phạm, và độ vi phạm lớn. Với , vi phạm lớn nhất tìm được là 2,237, cùng cỡ với vi phạm 2 của bộ ba , , tính tay ở Mục 11.3.
Lưu ý
Phép thử này có thể bác bỏ tính lồi nhưng không chứng minh được nó. Không tìm thấy vi phạm trong 20 000 lần thử không loại trừ một vùng lõm hẹp ở đâu đó chưa được lấy mẫu. Ngược lại, chỉ một phản ví dụ là đủ để kết luận hàm không lồi. Với một hàm mất mát tự viết, đây là cách rẻ để phát hiện lỗi trước khi đi vào chứng minh.
Dòng thứ tư xác nhận bằng số điều mà Mục 11.5 sẽ chứng minh: mất mát logistic là hàm lồi, nên bài toán hồi quy logistic có regularization có nghiệm toàn cục duy nhất. Nhờ vậy hồi quy logistic không cần chạy nhiều lần với nhiều khởi tạo khác nhau như mạng nơ-ron.
11.5Các phép toán bảo toàn tính lồi#
Trên thực tế, người ta hiếm khi kiểm tra tính lồi bằng định nghĩa. Thay vào đó, hàm lồi được dựng từ những hàm đã biết là lồi bằng các phép toán bảo toàn tính lồi, liệt kê trong bảng dưới.
| Phép toán | Bảo toàn tính lồi |
|---|---|
| có | |
| với | có |
| có | |
| không | |
| , hợp với hàm affine | có |
| với lồi, lồi và không giảm | có |
| không, nói chung |
Các phép toán này giải thích tính lồi của mọi hàm mất mát trong giáo trình. Mất mát hinge là max của hai hàm affine theo , mà là hàm affine theo , nên hinge lồi theo tham số. Hàm là hàm lồi hợp với ánh xạ affine . Mất mát logistic là một hàm lồi một biến, vì đạo hàm cấp hai của nó bằng , hợp với hàm affine của . Và tổng của một mất mát lồi với một thành phần regularization lồi như hay là hàm lồi. Vì vậy ridge, lasso, hồi quy logistic có regularization và SVM đều là bài toán tối ưu lồi.
Cross-entropy của sáu sinh viên ở Chương 6 là một trường hợp cụ thể. Khi nhãn được mã hoá là , nó là trung bình của sáu hàm , với lề affine theo . Mỗi số hạng lồi theo , nên tổng lồi, và nghiệm , hệ số chặn ở Mục 6.3 là cực tiểu toàn cục.
11.6Tính lồi và kết quả của gradient descent#
Điều gì xảy ra khi tính lồi mất đi? Thí nghiệm sau chạy cùng một thuật toán gradient descent từ 21 điểm xuất phát trên một hàm lồi và một hàm không lồi.
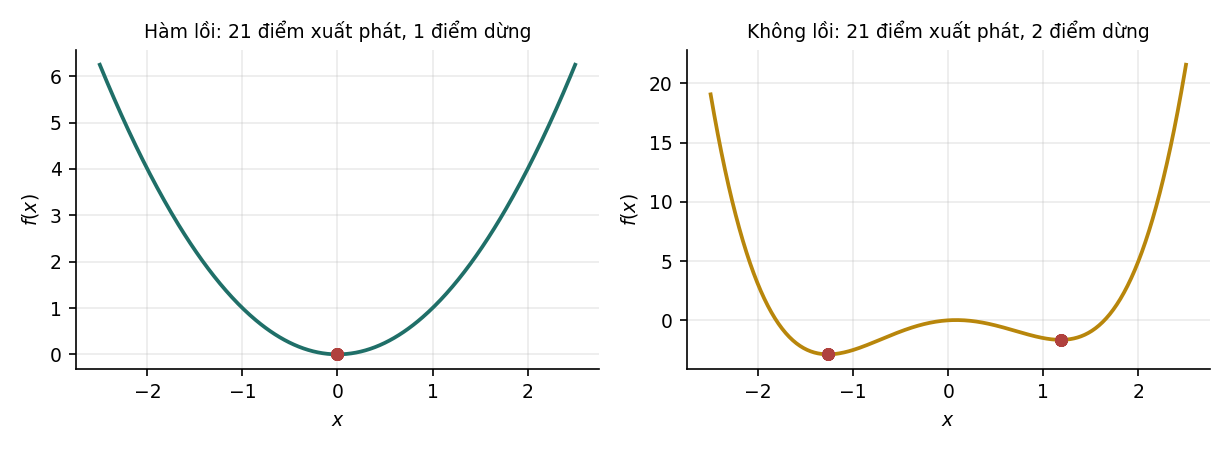
ham LOI      x^2             : so diem dung khac nhau = 1
ham KHONG LOI x^4-3x^2+x/2   : so diem dung khac nhau = 2, tai x = -1.2645 va 1.1807
gia tri ham tai hai diem do  : -2.8725 va -1.6484
Với hàm không lồi , gradient descent dừng ở hai điểm khác nhau tuỳ điểm xuất phát, và hai điểm này có giá trị hàm khác nhau: và . Có thể biết trước điểm nào về đâu. Đạo hàm bằng 0 tại ba điểm: hai cực tiểu và , và một cực đại địa phương ngăn cách hai lòng chảo. Với bước học nhỏ, điểm xuất phát bên trái 0,084 trượt về cực tiểu bên trái, điểm bên phải trượt về cực tiểu bên phải: trong 21 điểm xuất phát cách đều từ tới , 11 điểm từ 0 trở xuống về , 10 điểm còn lại về . Những lần chạy xuất phát ở phía dương đều dừng tại cực tiểu địa phương , không phải cực tiểu toàn cục, và thuật toán không có cách nào nhận ra điều đó, vì gradient tại đó cũng bằng 0.
Hàm mất mát của mạng nơ-ron không lồi, nên hiện tượng trên xảy ra ở quy mô lớn hơn nhiều. Tuy vậy, kinh nghiệm thực tế cho thấy với mạng đủ lớn, phần lớn cực tiểu địa phương có giá trị mất mát gần nhau, và trở ngại chính lại là tín hiệu co lại hoặc phình ra qua nhiều lớp. Chương 6 của Học sâu trình bày khởi tạo, chuẩn hoá và kết nối tắt, ba kỹ thuật xử lý trở ngại đó.
11.7Tóm tắt#
Tập lồi chứa trọn đoạn thẳng nối hai điểm bất kỳ của nó, và giao của các tập lồi vẫn lồi. Hàm lồi có dây cung nằm trên đồ thị, tương đương với tiếp tuyến nằm dưới đồ thị hoặc Hessian nửa xác định dương; một bộ ba điểm như , với đủ để bác bỏ tính lồi. Với hàm lồi khả vi, mọi điểm có gradient bằng 0 là cực tiểu toàn cục; tính lồi chặt cho thêm tính duy nhất nhưng không bảo đảm cực tiểu tồn tại. Hàm mất mát của bốn căn hộ có Hessian nên lồi chặt, còn cross-entropy của sáu sinh viên lồi vì là tổng các hàm lồi của lề affine, nên nghiệm tìm được ở Chương 5 và Chương 6 là nghiệm tốt nhất. Phép thử bằng số bác bỏ được tính lồi nhưng không chứng minh được nó; trong thực tế, tính lồi được suy ra từ các phép toán bảo toàn như cộng, lấy max và hợp với hàm affine, và nhờ vậy mọi hàm mất mát của giáo trình tới đây đều lồi. Trên hàm không lồi , điểm dừng của gradient descent phụ thuộc vào việc điểm xuất phát nằm bên nào của cực đại địa phương ở .
Tính lồi bảo đảm tối ưu tốt khi không có ràng buộc. SVM lại là một bài toán tối ưu có ràng buộc, và Chương 12 trình bày công cụ để xử lý ràng buộc trong bài toán lồi: hàm Lagrange và bài toán đối ngẫu.
Tự kiểm tra
3 câu. Chọn đáp án để xem ngay lời giải thích.
1Vì sao tính lồi quan trọng trong tối ưu?
Vì sao: Ở Mục 11.6, gradient descent từ 21 điểm xuất phát cho một điểm dừng với hàm lồi, nhưng cho hai điểm dừng có giá trị và với hàm . Lưu ý hàm lồi không nhất thiết có cực tiểu, ví dụ .2Phép toán nào không bảo toàn tính lồi?
Vì sao: Phép max giải thích vì sao mất mát hinge lồi. Min của hai parabol có đỉnh khác nhau có thể có hai đáy, nên không lồi.3Kiểm tra tính lồi bằng cách thử bất đẳng thức định nghĩa trên nhiều bộ điểm ngẫu nhiên cho phép kết luận gì?
Vì sao: Không có vi phạm trên 20 000 bộ không loại trừ một vùng lõm hẹp chưa được lấy mẫu. Với hàm mất mát tự viết, đây vẫn là cách rẻ để phát hiện lỗi.
Đã trả lời 0/3