3Hình học của không gian embedding#
Có embedding rồi, việc tiếp theo là đo độ giống nhau giữa hai vector, và lựa chọn mặc định là cosine. Thí nghiệm ở Mục 3.2 cho một kết quả dễ gây hiểu nhầm: 900 vector ngẫu nhiên độc lập có cosine trung bình 0,87 với nhau, một con số rất dễ bị đọc thành "giống nhau 87%". Hiện tượng này xảy ra khi đám mây embedding không nằm quanh gốc toạ độ, và hiểu vì sao nó xảy ra cũng cho thấy cách sửa.
3.1Đo độ tương đồng bằng cosine#
Độ tương đồng cosine giữa hai vector là
tức cosine của góc giữa chúng. Lý do thường được nêu để dùng cosine thay cho khoảng cách Euclid là độ dài vector phản ánh tần suất của từ nhiều hơn nghĩa, nên cần loại bỏ. Lý do đó đúng, nhưng cosine có một giả định ngầm: góc giữa hai vector chỉ có ý nghĩa khi đám mây điểm phân bố quanh gốc toạ độ.
3.2Tính bất đẳng hướng#
Nếu toàn bộ embedding lệch về một phía so với gốc toạ độ, mọi cặp vector đều tạo góc nhỏ với nhau, không phải vì chúng giống nhau mà vì chúng cùng chứa một thành phần chung lớn. Hiện tượng này gọi là tính bất đẳng hướng (anisotropy), và nó thường gặp ở embedding lấy từ các mô hình Transformer (Gao và cộng sự, 2019; Ethayarajh, 2019).
Hai chiều đủ để thấy cơ chế. Lấy và : cả hai cùng chứa thành phần chung , phần riêng của chúng là và , hai hướng ngược nhau. Cosine giữa và là . Trừ thành phần chung đi, phần còn lại có cosine . Con số 0,8 hoàn toàn đến từ thành phần chung, và nó che mất việc hai phần riêng thực ra ngược hướng.
Thí nghiệm tạo ba đám mây, mỗi đám 900 vector 64 chiều: các vector là nhiễu Gauss độc lập cộng thêm một vector hằng với độ lớn khác nhau. Độ lệch tâm đo bằng độ dài của vector trung bình chia cho độ dài trung bình của các vector.
| Phân bố | Cosine trung bình giữa hai vector | Sau khi trừ vector trung bình | Độ lệch tâm |
|---|---|---|---|
| Quanh gốc toạ độ | 0,0318 | ||
| Lệch tâm nhẹ | 0,6267 | ||
| Lệch tâm mạnh | 0,9342 |
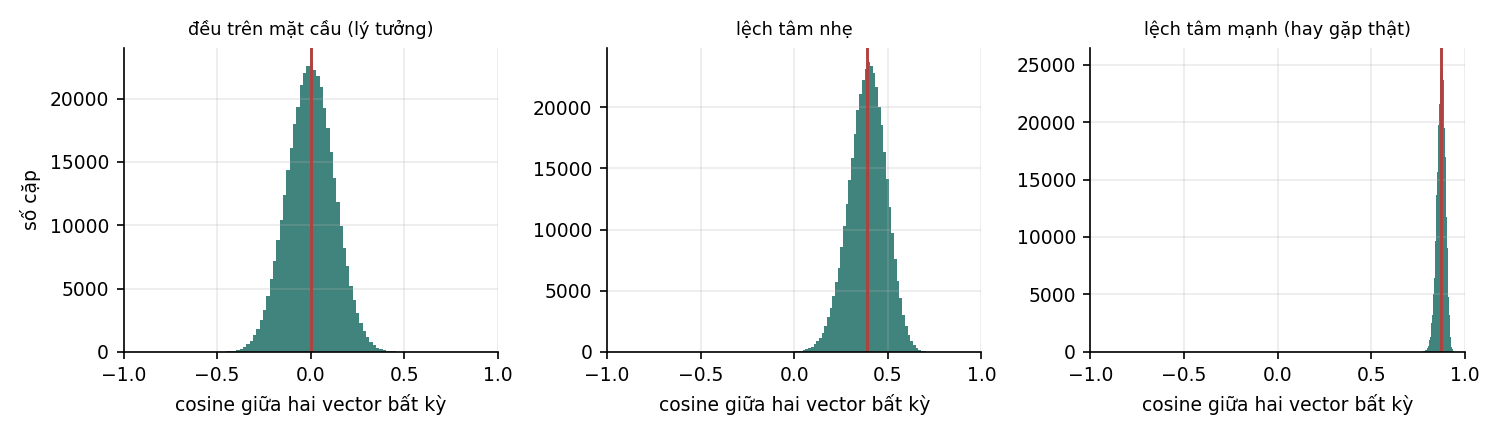
Hàng cuối cần đọc kỹ. Đây là 900 vector ngẫu nhiên độc lập, không có quan hệ ngữ nghĩa nào giữa chúng, vậy mà cosine trung bình giữa hai vector bất kỳ là 0,87. Nếu các vector này là embedding của câu, con số đó có thể bị hiểu nhầm thành "hai câu giống nhau 87%", trong khi nó chỉ phản ánh độ lệch tâm của đám mây.
Cột thứ ba cho thấy cách khắc phục đơn giản: trừ vector trung bình của cả tập khỏi mọi vector, cosine trung bình trở về khoảng 0 ở cả ba trường hợp.
3.3Cách khắc phục#
Có ba cách, xếp theo thứ tự nên thử. Cách rẻ nhất là trừ trung bình: tính vector trung bình trên một mẫu đại diện rồi trừ khỏi mọi embedding trước khi so sánh. Như bảng ở Mục 3.2 cho thấy, chỉ riêng bước này thường đã đủ để cosine có ý nghĩa trở lại.
Mạnh hơn là làm trắng (whitening): sau khi trừ trung bình, nhân thêm với để phương sai theo mọi hướng bằng nhau. Cách này cần ước lượng ma trận hiệp phương sai , việc đòi hỏi nhiều dữ liệu khi số chiều lớn (Mục 7.4 của Nền tảng).
Cách triệt để nhất là huấn luyện embedding với mục tiêu tương phản, sao cho cặp giống nhau gần nhau và cặp khác nhau xa nhau ngay từ đầu. Đây là cách các mô hình embedding câu hiện nay được huấn luyện (Mục 4.2).
Trong thực tế, tính bất đẳng hướng thường lộ ra qua một hệ thống tìm kiếm ngữ nghĩa cho mọi kết quả cosine từ 0,8 trở lên, kể cả những kết quả rõ ràng không liên quan. Nâng ngưỡng không giải quyết được vấn đề, vì thứ hạng giữa các kết quả vẫn bị thành phần chung chi phối; nên trừ trung bình rồi đo lại.
3.4Ý nghĩa của từng chiều#
Một câu hỏi thường gặp là chiều thứ 37 của embedding mang nghĩa gì. Câu trả lời thường là không mang nghĩa riêng nào, và lý do nằm ở toán học. Nếu thì với mọi ma trận trực giao ,
Xoay toàn bộ không gian embedding không làm thay đổi mọi tích vô hướng, nên bài toán chỉ xác định sai khác một phép xoay, và hệ trục toạ độ là tuỳ ý. Thứ có ý nghĩa là quan hệ giữa các vector: khoảng cách, góc, vector hiệu. Phép loại suy ở Mục 2.4 hoạt động vì nó chỉ dùng vector hiệu, mà vector hiệu biến đổi cùng phép xoay.
Ngoại lệ là khi huấn luyện có thêm ràng buộc thưa, ví dụ bằng bộ tự mã hoá thưa (sparse autoencoder): khi đó các chiều có thể trở nên diễn giải được. Đây là một hướng nghiên cứu về khả năng diễn giải của mô hình ngôn ngữ hiện nay, và hướng này cần thiết chính vì theo mặc định các chiều không có nghĩa riêng.
3.5Tóm tắt#
Cosine đo góc giữa hai vector, và góc chỉ có ý nghĩa khi đám mây điểm nằm quanh gốc toạ độ. Embedding thật thường lệch tâm, và khi lệch mạnh, hai vector ngẫu nhiên độc lập đã có cosine trung bình 0,87. Trừ vector trung bình đưa con số đó về khoảng 0; làm trắng mạnh hơn nhưng cần ước lượng ma trận hiệp phương sai; huấn luyện với mục tiêu tương phản sửa tận gốc. Từng chiều riêng lẻ của embedding thường không mang nghĩa, vì xoay cả không gian không làm đổi tích vô hướng nào; thứ mang nghĩa là quan hệ giữa các vector.
Embedding của Chương 2 còn một giới hạn mà không phép biến đổi hình học nào sửa được: mỗi từ chỉ có một vector, dù từ đó có nhiều nghĩa. Chương 4 bỏ giới hạn này bằng embedding theo ngữ cảnh, rồi xét bài toán tìm kiếm trên hàng triệu vector.
Tự kiểm tra
3 câu. Chọn đáp án để xem ngay lời giải thích.
1Vì sao hai embedding không liên quan vẫn có thể có cosine rất cao?
Vì sao: Ở Mục 3.2, 900 vector ngẫu nhiên độc lập cộng một vector hằng có cosine trung bình 0,8724, dù không có quan hệ gì với nhau.2Cách rẻ nhất để giảm tác động của tính bất đẳng hướng là gì?
Vì sao: Trừ trung bình đưa cosine trung bình về ở cả ba mức lệch tâm trong thí nghiệm. Nâng ngưỡng chỉ xử lý triệu chứng, và thứ hạng giữa các kết quả vẫn bị thành phần chung chi phối.3Chiều thứ 37 của một embedding mang nghĩa gì?
Vì sao: Nếu thì với mọi ma trận trực giao , nên hệ trục toạ độ là tuỳ ý. Thứ có nghĩa là quan hệ giữa các vector (Mục 3.4).
Đã trả lời 0/3