12Nhập môn học tăng cường#
Ở Chương 1, mô hình vừa tiền huấn luyện được hỏi thủ đô của Pháp và có thể viết tiếp thành một đề kiểm tra thay vì trả lời. Muốn sửa hành vi đó bằng tín hiệu "câu trả lời này tốt hay tệ", cần một cách học từ phần thưởng thay vì từ đáp án đúng. Đó là học tăng cường (reinforcement learning). Ta chỉ xét những khái niệm tối thiểu cần cho RLHF ở Chương 14, kèm một thí nghiệm nhỏ về khám phá cho kết quả khác với cách giải thích thường gặp.
12.1Khác biệt với học có giám sát#
Trong học có giám sát, mỗi mẫu đi kèm đáp án đúng; mô hình dự đoán, so với đáp án, rồi điều chỉnh. Trong học tăng cường, không có đáp án, chỉ có phần thưởng: một con số cho biết việc vừa làm tốt hay tệ tới mức nào. Ba khác biệt đi kèm, và cả ba đều làm bài toán khó hơn:
| Học có giám sát | Học tăng cường | |
|---|---|---|
| Tín hiệu | đáp án đúng cho mỗi mẫu | một con số, không cho biết nên làm gì thay thế |
| Thời điểm | ngay sau mỗi dự đoán | có thể đến rất muộn sau hành động gây ra nó |
| Dữ liệu | cho sẵn, cố định | do chính chính sách đang học sinh ra |
Dòng cuối có tác động lớn nhất. Trong học tăng cường, hành động của tác tử quyết định nó sẽ thấy dữ liệu gì tiếp theo. Một chính sách kém chỉ thu thập được dữ liệu kém, rồi học từ dữ liệu đó lại ra chính sách kém. Đây là một vòng phản hồi, cùng bản chất với vòng phản hồi trong các hệ thống gợi ý (Mục 12.2 của MLOps).
12.2Các khái niệm cơ bản#
Một bài toán học tăng cường gồm một tác tử tương tác với môi trường. Tại mỗi thời điểm, môi trường ở một trạng thái , tác tử chọn một hành động và nhận về một phần thưởng , là một con số. Quy tắc chọn hành động gọi là chính sách , và có thể ngẫu nhiên. Để đánh giá một lựa chọn, ta dùng hàm giá trị hành động : tổng phần thưởng chiết khấu kỳ vọng nếu làm tại rồi tiếp tục theo . Hàm giá trị trạng thái là kỳ vọng của theo .
Tổng phần thưởng chiết khấu từ thời điểm là , với hệ số chiết khấu : gần 1 nghĩa là coi trọng phần thưởng xa, gần 0 nghĩa là chỉ quan tâm phần thưởng trước mắt. Một hành động có thể cho phần thưởng tức thời thấp mà vẫn là lựa chọn đúng, vì nó dẫn tới phần thưởng lớn về sau; hàm giá trị tồn tại để nắm được điều đó.
Hàm giá trị tối ưu thoả phương trình Bellman
trong đó kỳ vọng lấy theo phần thưởng và trạng thái kế tiếp sau khi làm tại . Giá trị của một hành động bằng phần thưởng nhận ngay cộng giá trị chiết khấu của hành động tốt nhất ở trạng thái kế tiếp.
Q-learning (Watkins và Dayan, 1992) biến phương trình này thành quy tắc cập nhật sau mỗi bước chuyển :
Đại lượng trong ngoặc là sai số thời gian (temporal difference error): chênh lệch giữa ước lượng mới dựa trên quan sát vừa có và ước lượng hiện tại. Q-learning là thuật toán ngoài chính sách (off-policy): nó học giá trị của chính sách tham lam theo , bất kể dữ liệu được thu thập bằng chính sách nào, miễn là mọi cặp trạng thái–hành động được thử đủ nhiều.
12.3Khám phá và khai thác#
Nếu luôn chọn hành động có cao nhất theo ước lượng hiện tại (khai thác), tác tử không bao giờ thử những hành động khác, và không bao giờ biết có lựa chọn tốt hơn. Nếu luôn chọn ngẫu nhiên (khám phá), nó biết nhiều nhưng không tận dụng được. Cách cân bằng thông dụng nhất là -tham lam: với xác suất chọn hành động ngẫu nhiên, còn lại chọn hành động có cao nhất. Thí nghiệm ở Mục 12.4 cho thấy đây không phải cơ chế khám phá duy nhất.
12.4Thí nghiệm khám phá trên lưới 7 × 7#
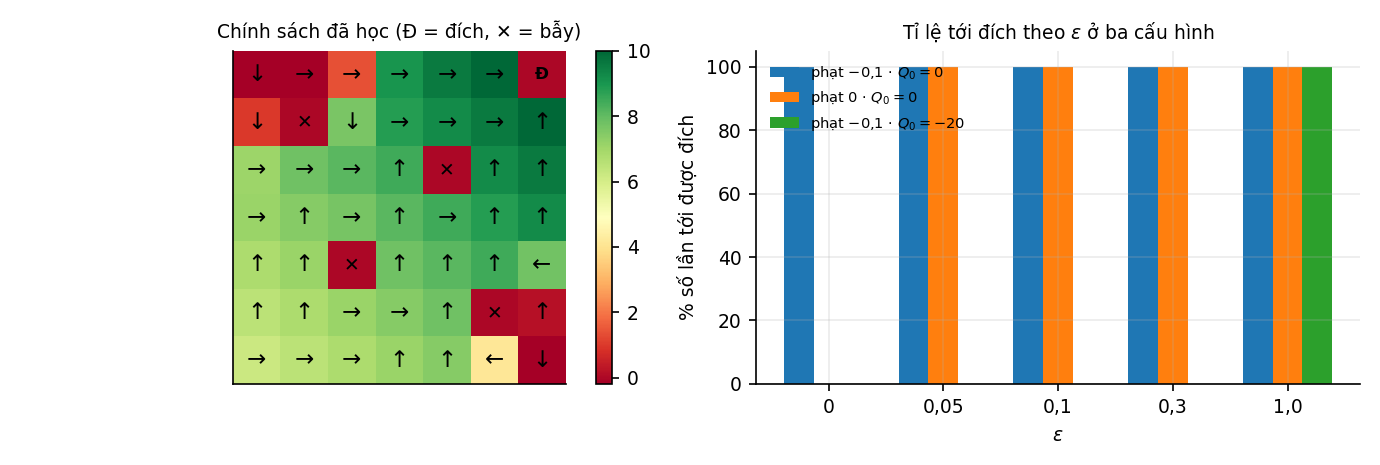
Môi trường là lưới : tác tử xuất phát ở góc dưới bên trái, đích ở góc trên bên phải (phần thưởng ), bốn ô bẫy (phần thưởng ), mỗi lượt kết thúc khi tới đích, rơi vào bẫy hoặc sau 80 bước. Q-learning chạy 6 000 lượt với , . Ba cấu hình chỉ khác nhau ở phần thưởng của mỗi bước đi thường và giá trị khởi tạo . Sau khi học, chính sách tham lam theo (không còn khám phá) được chạy để đo tỉ lệ tới đích.
| Cấu hình | |||||
|---|---|---|---|---|---|
| 1. Phạt mỗi bước, | 100% | 100% | 100% | 100% | 100% |
| 2. Không phạt, | 0% | 100% | 100% | 100% | 100% |
| 3. Phạt mỗi bước, | 0% | 0% | 0% | 0% | 100% |
Cấu hình 1 thành công ngay cả với , tức không hề chọn ngẫu nhiên. Lời giải thích "cần để khám phá" không giải thích được kết quả này.
Lời giải thích nằm ở giá trị khởi tạo. Trong cấu hình 1, mọi phần thưởng của bước đi thường đều âm, trong khi khởi tạo bằng 0. Mỗi lần thử một hành động, của nó bị kéo xuống dưới 0, còn các hành động chưa thử vẫn ở 0. Một bước cập nhật cho thấy con số cụ thể: với , , một hành động được thử lần đầu ở trạng thái mà mọi còn bằng 0 có , thấp hơn 0 của ba hành động chưa thử. Chính sách tham lam vì vậy luôn ưu tiên hành động chưa thử, tức tự khám phá mà không cần yếu tố ngẫu nhiên. Cơ chế này gọi là khởi tạo lạc quan (optimistic initialization; Sutton và Barto, 2018): giá trị khởi tạo cao hơn giá trị thật làm mọi lựa chọn chưa thử trông hấp dẫn.
Cấu hình 2 mất tính lạc quan đó. Không phạt bước đi thì mọi bằng 0 cho tới khi tác tử tình cờ tới đích hoặc rơi vào bẫy. Với , hàm argmax luôn trả về cùng một hành động khi các giá trị bằng nhau, nên tác tử đi mãi một hướng và không bao giờ tới đích. Chỉ cần là đủ để tìm ra đích.
Cấu hình 3 khởi tạo bi quan: , thấp hơn mọi giá trị thật. Hành động đầu tiên được thử có tăng lên gần giá trị thật, trong khi các hành động khác vẫn ở , nên chính sách tham lam bám lấy hành động đã thử và gần như không khám phá. Cùng bước cập nhật như trên giờ cho , cao hơn của mọi hành động chưa thử. Với ngân sách 6 000 lượt, ngay cả cũng không đủ. Chỉ với , tức hành động hoàn toàn ngẫu nhiên, Q-learning mới học được chính sách tối ưu; điều này khả thi vì Q-learning là thuật toán ngoài chính sách.
Như vậy không phải nguồn khám phá duy nhất. Cách khởi tạo hàm giá trị cũng là một cơ chế khám phá, và trong cấu hình 1 nó thay thế hoàn toàn . Ngược lại, khởi tạo bi quan có thể làm nhỏ trở nên vô tác dụng.
12.5Tóm tắt#
Học tăng cường học từ phần thưởng, một con số không cho biết nên làm gì thay thế, có thể đến muộn, và phụ thuộc vào dữ liệu do chính chính sách đang học thu thập. Hàm giá trị nắm được phần thưởng về sau của một hành động; nó thoả phương trình Bellman, và Q-learning biến phương trình đó thành quy tắc cập nhật theo sai số thời gian. Thí nghiệm trên lưới cho thấy khởi tạo lạc quan đủ để tác tử tới đích 100% với , còn khởi tạo bi quan làm cả cũng thất bại.
Q-learning cần một bảng giá trị cho mọi cặp trạng thái–hành động. Với mô hình ngôn ngữ, trạng thái là toàn bộ văn bản đã sinh và hành động là chọn một trong hàng chục nghìn token, nên cách làm này không khả thi. Chương 13 chuyển sang tối ưu trực tiếp chính sách, mà với mô hình ngôn ngữ thì chính sách chính là mô hình đã có.
Tự kiểm tra
3 câu. Chọn đáp án để xem ngay lời giải thích.
1Khác biệt có hệ quả lớn nhất giữa học tăng cường và học có giám sát là gì?
Vì sao: Chính sách kém chỉ thu thập được dữ liệu kém, rồi học từ dữ liệu đó lại ra chính sách kém. Ngoài ra, phần thưởng không cho biết hành động đúng là gì và có thể đến rất muộn.2Thí nghiệm ở Mục 12.4 cho thấy điều gì mà câu "cần để khám phá" bỏ sót?
Vì sao: Khi mọi phần thưởng của bước đi đều âm mà khởi tạo bằng 0, hành động chưa thử luôn có vẻ tốt hơn hành động đã thử, nên chính sách tham lam tự khám phá.3Khởi tạo bi quan gây ra điều gì trong thí nghiệm?
Vì sao: Hành động đã thử có tăng lên gần giá trị thật, còn các hành động khác vẫn ở , nên chính sách tham lam gần như không thử hành động mới. Chỉ mới học được chính sách tối ưu.
Đã trả lời 0/3