Biểu diễn, mô hình sinh và căn chỉnh
Toàn bộ giáo trình trên một trang — tiện cho Ctrl+F, đọc ngoại tuyến hoặc in ra giấy.
Giáo trình 3 của lộ trình
Giáo trình Học sâu dừng ở kiến trúc Transformer và các thành phần của một mô hình ngôn ngữ lớn. Giáo trình này đi tiếp theo con đường một mô hình như vậy được tạo ra rồi đưa vào dùng: biểu diễn dữ liệu bằng vector, tiền huấn luyện trên dữ liệu không nhãn rồi tái sử dụng mô hình bằng tinh chỉnh hoặc LoRA, sinh nội dung mới bằng VAE, GAN và mô hình khuếch tán, và cuối cùng điều chỉnh hành vi của mô hình ngôn ngữ theo mong muốn của con người bằng học tăng cường, RLHF và DPO. Cách dùng các mô hình này trong sản phẩm nằm ở giáo trình Ứng dụng LLM.
Kiến thức cần có. Hồi quy logistic và softmax, cross-entropy, ước lượng hợp lý cực đại, SVD và tối ưu có ràng buộc ở mức của Nền tảng; kiến trúc Transformer ở mức của Học sâu. Chỗ nào dùng lại kiến thức cũ đều có liên kết tới đúng mục.
Về số liệu. Mọi con số đo được sinh bởi hai script trong
code/bieudien/với hạt giống cố định. Một số kết quả là kiểm chứng đẳng thức chứ không phải mô phỏng: nghiệm của bài toán RLHF có ràng buộc KL khớp với công thức dạng đóng tới , và chính sách tìm bằng DPO trùng chính sách RLHF hai bước tới . Ở ba chỗ, kết quả thí nghiệm khác với điều thường được phát biểu trong tài liệu phổ thông; các chỗ đó được trình bày đúng như số liệu cho thấy (Mục 2.4, Mục 10.3, Mục 12.4).
0Ký hiệu và quy ước#
Giáo trình dùng lại ký hiệu và quy ước thuật ngữ của Nền tảng và Học sâu, bổ sung các ký hiệu riêng dưới đây.
0.1Bảng ký hiệu#
| Ký hiệu | Ý nghĩa |
|---|---|
| , | từ trung tâm và từ ngữ cảnh trong word2vec; cũng dùng cho vector của chúng |
| từ vựng và kích thước từ vựng; trong phân tích SVD ở Mục 2.4 là ma trận các vector suy biến phải | |
| số lần và cùng xuất hiện trong một cửa sổ | |
| thông tin tương hỗ điểm, | |
| biến ẩn (VAE) hoặc nhiễu đầu vào (GAN) | |
| bộ mã hoá của VAE, phân phối hậu nghiệm xấp xỉ | |
| bộ giải mã của VAE | |
| tỉ lệ tín hiệu còn lại sau bước của quá trình khuếch tán | |
| , , | trạng thái, hành động, phần thưởng trong học tăng cường |
| hàm thưởng cho câu hỏi và câu trả lời | |
| , | chính sách đang huấn luyện và chính sách tham chiếu |
| phân kỳ Kullback–Leibler | |
| hàm mất mát hoặc hàm mục tiêu; trong phép chứng minh ở Mục 14.4 là hàm Lagrange | |
| , , | hai ma trận hạng thấp và hạng của LoRA |
Chữ vừa là hạng của LoRA (Chương 7) vừa là hàm thưởng (Chương 12 tới 15); hai nghĩa không xuất hiện trong cùng một chương.
Chữ dễ gây nhầm hơn, vì nó có hai nghĩa gần nhau. Trong VAE (Chương 9), nhân với số hạng KL giữa hậu nghiệm xấp xỉ và tiên nghiệm ; trong RLHF (Chương 14), nhân với KL giữa chính sách mới và chính sách tham chiếu. Ở cả hai nơi, là mức phạt khi đi xa khỏi một phân phối tham chiếu. Chỗ khác nhau nằm ở phân phối tham chiếu: ở VAE đó là tiên nghiệm Gauss, ở RLHF là mô hình đã tinh chỉnh có giám sát. Ngoài ra, trong Chương 11, là phương sai nhiễu ở bước của quá trình khuếch tán, theo đúng ký hiệu của bài báo gốc.
0.2Quy ước thuật ngữ#
| Tiếng Anh | Dùng trong giáo trình |
|---|---|
| representation, embedding | biểu diễn, embedding |
| pointwise mutual information | thông tin tương hỗ điểm (PMI) |
| negative sampling | lấy mẫu âm |
| anisotropy | tính bất đẳng hướng |
| contrastive learning | học tương phản |
| pre-training, fine-tuning, freezing | tiền huấn luyện, tinh chỉnh, đóng băng |
| transfer learning | học chuyển giao |
| parameter-efficient fine-tuning | tinh chỉnh tiết kiệm tham số |
| generative model, latent variable | mô hình sinh, biến ẩn |
| variational autoencoder | bộ tự mã hoá biến phân (VAE) |
| evidence lower bound | chặn dưới của bằng chứng (ELBO) |
| generative adversarial network | mạng đối sinh (GAN) |
| mode collapse | sụp chế độ |
| diffusion model, denoising | mô hình khuếch tán, khử nhiễu |
| reinforcement learning, policy, reward | học tăng cường, chính sách, phần thưởng |
| exploration, exploitation | khám phá, khai thác |
| advantage function | hàm lợi thế |
| alignment | căn chỉnh |
| reward hacking | lách phần thưởng |
Bảng đối chiếu đầy đủ nằm ở trang Từ điển thuật ngữ.
1Tổng quan#
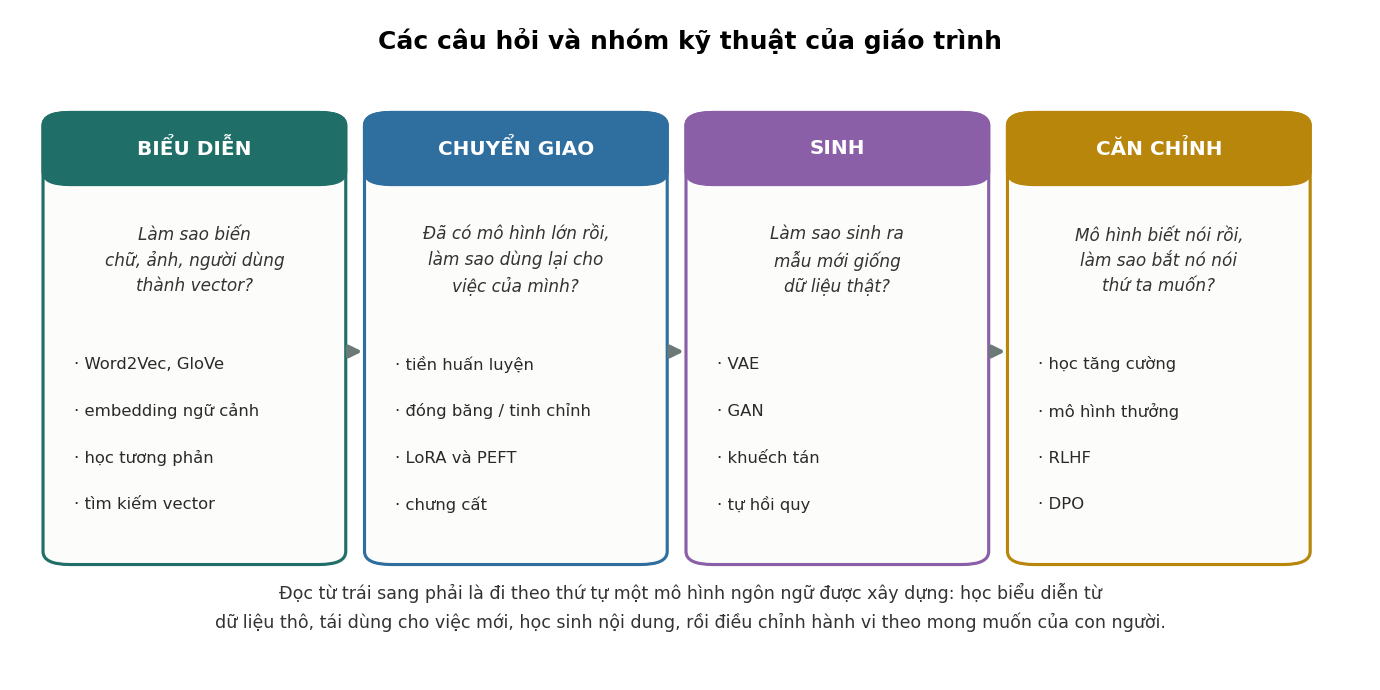
Giáo trình Học sâu kết thúc với một mô hình ngôn ngữ lớn ở dạng kiến trúc: các khối Transformer, số tham số, lượng bộ nhớ cần để huấn luyện. Từ một kiến trúc như vậy tới một trợ lý trả lời được câu hỏi của người dùng còn nhiều bước, và mỗi bước dùng một nhóm kỹ thuật riêng. Trước khi đi vào chi tiết, ta xếp các bước đó theo thứ tự để thấy mỗi nhóm kỹ thuật trả lời một câu hỏi mà nhóm trước để lại.
1.1Các nhóm kỹ thuật và mối liên hệ giữa chúng#
Embedding, học chuyển giao, mô hình sinh và căn chỉnh ra đời ở những thời điểm khác nhau, cho những mục đích khác nhau. Word2Vec (2013) tạo vector cho từ; mô hình khuếch tán (2020) sinh ảnh; RLHF (2017, phổ biến từ 2022) làm cho mô hình ngôn ngữ trả lời hữu ích hơn. Nhưng nếu đi theo quá trình xây dựng một mô hình ngôn ngữ hiện đại, chúng xếp thành một chuỗi: biểu diễn dữ liệu bằng vector, huấn luyện một mô hình lớn trên dữ liệu không nhãn rồi tái sử dụng nó, sinh ra nội dung mới, và cuối cùng điều chỉnh hành vi của mô hình theo mong muốn của con người.
1.2Câu hỏi của từng nhóm kỹ thuật#
Câu hỏi đầu tiên là biểu diễn dữ liệu thô bằng số. Máy tính chỉ xử lý số, nên chữ "mèo" phải trở thành một vector. Gán cho mỗi từ một chỉ số (mèo = 7, chó = 8, tủ lạnh = 9) là đưa vào một quan hệ giả: về mặt số học, mèo gần chó hơn gần tủ lạnh chỉ vì cách đánh số. Mã hoá one-hot, trong đó mỗi từ là một vector toàn số 0 với đúng một số 1, không đưa vào quan hệ giả nào, nhưng cũng không có quan hệ thật nào: mọi cặp từ đều cách nhau . Điều cần có là một không gian trong đó khoảng cách phản ánh sự giống nhau về nghĩa. Chương 2 tới 4 xây dựng không gian đó từ thống kê đồng hiện của các từ, không cần nhãn.
Câu hỏi thứ hai là tái sử dụng một mô hình đã huấn luyện. Huấn luyện một mô hình ngôn ngữ lớn từ đầu tốn hàng triệu đô la và hàng nghìn tỉ token, nên phần lớn ứng dụng lấy một mô hình có sẵn rồi điều chỉnh cho việc của mình. Điều cần biết là điều chỉnh tới đâu, bằng cách nào, với bao nhiêu dữ liệu. Chương 5 tới 7 trả lời các câu hỏi đó, kèm số đo cho thấy ngưỡng dữ liệu mà ở đó tinh chỉnh toàn phần bắt đầu vượt việc chỉ học một lớp tuyến tính trên đặc trưng đóng băng.
Câu hỏi thứ ba là sinh ra nội dung mới. Phân loại đi từ dữ liệu tới nhãn. Sinh đi theo chiều ngược lại và khó hơn nhiều: từ nhiễu ngẫu nhiên, tạo ra một mẫu chưa từng có nhưng trông giống dữ liệu thật. Chương 8 tới 11 trình bày ba họ mô hình: VAE, GAN và mô hình khuếch tán. Cả ba đều biến nhiễu Gauss thành mẫu, và khác nhau chủ yếu ở cách huấn luyện.
Câu hỏi cuối cùng là làm cho mô hình làm theo yêu cầu. Một mô hình vừa tiền huấn luyện biết ngôn ngữ nhưng chưa biết làm theo chỉ dẫn. Hỏi "thủ đô của Pháp là gì?", nó có thể trả lời, nhưng cũng có thể viết tiếp thành một đề kiểm tra gồm mười câu hỏi tương tự, vì trong văn bản trên mạng một câu hỏi thường đi cùng các câu hỏi khác. Chương 12 tới 15 trình bày cách điều chỉnh hành vi này. Giai đoạn căn chỉnh học từ so sánh giữa các câu trả lời thay vì từ câu trả lời mẫu, và việc đánh giá câu trả lời nào tốt hơn dễ hơn nhiều so với tự viết câu trả lời tốt nhất. Nhờ vậy mô hình có thể vượt chất lượng của các câu trả lời mẫu do người viết.
1.3Liên hệ với các giáo trình khác#
Giáo trình dùng lại nhiều kết quả của các giáo trình trước. Bảng dưới ghi nơi trình bày từng nội dung để tra lại khi cần.
| Nội dung cần dùng | Trình bày ở |
|---|---|
| Softmax, cross-entropy, hợp lý cực đại | Chương 6 và Chương 10 của Nền tảng |
| SVD và xấp xỉ hạng thấp | Chương 14 của Nền tảng |
| Tối ưu có ràng buộc, nhân tử Lagrange | Chương 12 của Nền tảng |
| Kiến trúc Transformer, attention | Chương 9 của Học sâu |
| Đếm tham số và bộ nhớ huấn luyện | Chương 12 của Học sâu |
| Embedding và RAG trong ứng dụng | Chương 6 tới 8 của Ứng dụng LLM |
| Vận hành mô hình ngôn ngữ | Chương 13 của MLOps |
Hai chỗ dùng lại nhiều nhất là phép đếm tham số ở Chương 12 của Học sâu, nền của Chương 7, và nhân tử Lagrange ở Chương 12 của Nền tảng, công cụ để giải bài toán ở Chương 14.
1.4Tóm tắt#
Bốn nhóm kỹ thuật của giáo trình ra đời riêng rẽ nhưng xếp thành một chuỗi khi nhìn theo quá trình tạo ra một mô hình ngôn ngữ: biểu diễn dữ liệu bằng vector, tiền huấn luyện rồi tái sử dụng mô hình, sinh nội dung mới, và căn chỉnh hành vi theo mong muốn của con người. Mỗi nhóm trả lời một câu hỏi mà nhóm trước để lại, và các chương đi đúng theo thứ tự đó.
Bước đầu tiên là biểu diễn. Chương 2 bắt đầu từ một việc rất đơn giản, đếm xem hai từ cùng xuất hiện bao nhiêu lần, rồi đi tới word2vec và chỉ ra rằng word2vec thực chất làm cùng một việc với phép đếm đó.
2Word2Vec#
Câu hỏi đầu tiên ở Chương 1 là gán cho mỗi từ một vector sao cho các từ gần nghĩa có vector gần nhau. Ta đi tới câu trả lời qua ba bước: đếm số lần các từ cùng xuất hiện, chuyển số đếm thành thông tin tương hỗ điểm (PMI), rồi nén ma trận PMI thành các vector ngắn. Word2Vec làm cùng việc đó mà không cần lập ma trận, và Levy và Goldberg (2014) chứng minh rằng nó thực chất đang phân rã ma trận PMI. Một kho ngữ liệu nhân tạo nhỏ cho phép quan sát từng bước bằng số.
2.1Giả thuyết phân bố#
"Gần nghĩa" là khái niệm của con người, không đo trực tiếp được. Tín hiệu thay thế đến từ ngôn ngữ học: giả thuyết phân bố (distributional hypothesis; Harris, 1954; Firth, 1957) cho rằng các từ xuất hiện trong những ngữ cảnh giống nhau thường có nghĩa giống nhau. Nếu trong rất nhiều câu tiếng Việt, "mèo" và "chó" cùng thường đi với "nuôi", "thú cưng", "cho ăn", thì hai từ này có điểm chung, và điểm chung đó đo được qua thống kê.
Như vậy một câu hỏi không đo được ("hai từ này có gần nghĩa không?") được thay bằng một câu hỏi đo được ("hai từ này có xuất hiện trong những ngữ cảnh giống nhau không?"). Sự thay thế không hoàn hảo: hai từ trái nghĩa như "tốt" và "xấu" xuất hiện trong ngữ cảnh gần như giống hệt nhau, nên sẽ có vector gần nhau. Nhưng nó đủ tốt để làm nền cho hầu hết các phương pháp biểu diễn văn bản về sau.
2.2Kho ngữ liệu thí nghiệm#
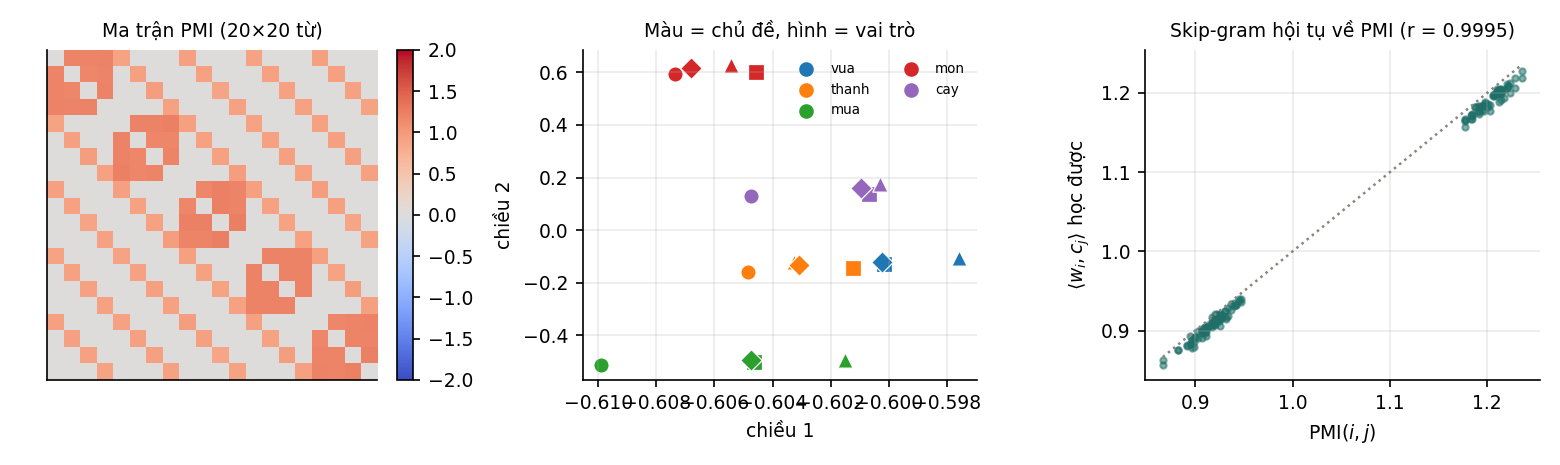
Để quan sát cơ chế một cách rõ ràng, thí nghiệm trong code/bieudien/experiments.py dùng một kho ngữ liệu nhân tạo nhỏ nhưng có cấu trúc. Từ vựng có 20 từ, mỗi từ là một cặp (chủ đề, vai trò) với 5 chủ đề và 4 vai trò, đặt tên như vua_nam, mua_nho, cay_lon. Kho gồm 40 000 câu, mỗi câu 3 từ. Một nửa số câu gồm các từ cùng chủ đề, ví dụ vua_nam vua_nho vua_lon; nửa còn lại gồm các từ cùng vai trò, ví dụ vua_nam mua_nam cay_nam.
Không câu nào cho biết có hai trục "chủ đề" và "vai trò", và không có nhãn nào; dữ liệu chỉ là các dãy từ. Nếu embedding học được tách hai trục thành hai hướng cộng được với nhau, đó là điều mô hình tự rút ra từ thống kê.
2.3Số lần đồng hiện và PMI#
Đếm số lần mỗi cặp từ cùng xuất hiện trong một câu cho ma trận đồng hiện . Số đếm thô có một nhược điểm: một từ rất phổ biến như "của" đồng hiện với hầu hết các từ, không phải vì liên quan mà vì phổ biến. Thứ cần đo là hai từ cùng xuất hiện nhiều hơn bao nhiêu so với mức kỳ vọng nếu chúng độc lập.
Định nghĩa 2.1 (Thông tin tương hỗ điểm)
Với là xác suất cặp cùng xuất hiện và , là các xác suất biên,
PMI dương nghĩa là hai từ cùng xuất hiện nhiều hơn mức ngẫu nhiên, bằng 0 nghĩa là đúng mức ngẫu nhiên, âm nghĩa là ít hơn. PPMI (positive PMI) là PMI với các giá trị âm thay bằng 0.
Tử số là xác suất quan sát được; mẫu số là xác suất nếu hai từ độc lập. Trong kho ngữ liệu thí nghiệm, PMI chỉ có ba giá trị:
| Cặp từ | PMI |
|---|---|
Cùng chủ đề, khác vai trò (vua_nam, vua_nu) |
|
Cùng vai trò, khác chủ đề (vua_nam, mua_nam) |
|
Khác cả chủ đề lẫn vai trò (vua_nam, mua_nu) |
Hai từ có chung một thuộc tính thì PMI dương; không có thuộc tính chung thì cùng xuất hiện đúng mức ngẫu nhiên. Cấu trúc hai trục của dữ liệu đã nằm sẵn trong ma trận PMI trước khi học bất cứ điều gì.
2.4Nén ma trận PPMI bằng SVD#
Ma trận PMI có phần tử. Với từ vựng thật cỡ 400 000 từ, đó là 160 tỉ phần tử, phần lớn bằng 0. Cần một biểu diễn ngắn và dày: mỗi từ một vector vài trăm chiều. Cách làm là xấp xỉ hạng thấp bằng SVD (Chương 14 của Nền tảng): với , giữ giá trị suy biến lớn nhất và đặt embedding của các từ là các hàng của . PPMI được dùng thay cho PMI vì các giá trị PMI âm ước lượng rất kém: chúng đòi hỏi đếm chính xác những cặp từ hiếm khi đi cùng nhau.
Chất lượng embedding được kiểm tra bằng phép loại suy dạng , tìm từ có vector gần nhất với theo cosine, loại trừ ba từ đã cho. Với :
vua_nam : vua_nu :: mua_nho : ?  ->  mua_nu
Do chinh xac tren 240 phep loai suy: 1.0000   (doan ngau nhien: 0.0588)
Cả 240 phép loại suy đều đúng. Vector , tức "đổi vai trò từ nam sang nữ", cộng vào mua_nho cho đúng mua_nu. Hai trục đã được tách thành hai hướng cộng được, dù dữ liệu không hề nói có hai trục.
Ta có thể nghĩ giữ càng nhiều chiều thì embedding càng tốt, nhưng độ chính xác không tăng đều theo số chiều giữ lại:
| Số chiều | 2 | 4 | 6 | 8 | 12 | 16 | 20 |
|---|---|---|---|---|---|---|---|
| Độ chính xác loại suy | 0,479 | 0,788 | 0,875 | 1,000 | 0,588 | 0,250 | 1,000 |
Giải thích nằm ở phổ của ma trận. Ma trận PPMI ở đây có đúng 8 trị riêng dương (7,28; 2,73; 2,70; 2,68; 2,68; 2,49; 2,46; 2,43) và 12 trị riêng âm có độ lớn gần bằng nhau, từ tới . Tám trị riêng dương ứng với cấu trúc hai trục: một hướng chung cho mọi từ, 4 hướng cho sự khác biệt giữa 5 chủ đề và 3 hướng cho sự khác biệt giữa 4 vai trò, tổng cộng . Mười hai trị riêng âm sinh ra vì đường chéo của ma trận bằng 0: một từ không bao giờ đồng hiện với chính nó. SVD cho giá trị suy biến bằng giá trị tuyệt đối của trị riêng và không phân biệt dấu, nên khi giữ 12 hoặc 16 chiều, embedding lấy thêm một phần các hướng ứng với trị riêng âm và coi chúng như hướng mang thông tin, làm sai lệch hình học. Giữ đủ 20 chiều thì ma trận được tái tạo chính xác và phép loại suy lại đúng hết.
Lưu ý
Trên kho ngữ liệu thật, không có ranh giới rõ ràng như vậy giữa phần cấu trúc và phần còn lại, và số chiều được chọn bằng thực nghiệm trên các nhiệm vụ đánh giá. Ví dụ này không cho thấy "đường cong đánh đổi" điển hình theo số chiều; nó cho thấy số chiều tốt nhất phụ thuộc vào cấu trúc phổ của ma trận, và giữ thêm chiều không phải lúc nào cũng có lợi.
2.5Skip-gram và lấy mẫu âm#
SVD ở Mục 2.4 cần lập toàn bộ ma trận PPMI, và với từ vựng thật ma trận đó quá lớn. Word2Vec (Mikolov và cộng sự, 2013) tránh việc này bằng cách xử lý từng cặp quan sát được bằng gradient descent. Mô hình skip-gram gán cho mỗi từ hai vector, khi là từ trung tâm và khi là từ ngữ cảnh, và mô hình hoá
Mẫu số là tổng trên toàn bộ từ vựng, tính lại cho mỗi cặp huấn luyện. Với vector 300 chiều, tính softmax đầy đủ và gradient của nó tốn cỡ phép tính mỗi cặp:
| Từ vựng | Softmax đầy đủ | Lấy mẫu âm, | Tỉ lệ |
|---|---|---|---|
| 1 000 | 600 000 | 3 600 | 167 |
| 50 000 | 30 000 000 | 3 600 | 8 333 |
| 400 000 | 240 000 000 | 3 600 | 66 667 |
| 2 000 000 | 1 200 000 000 | 3 600 | 333 333 |
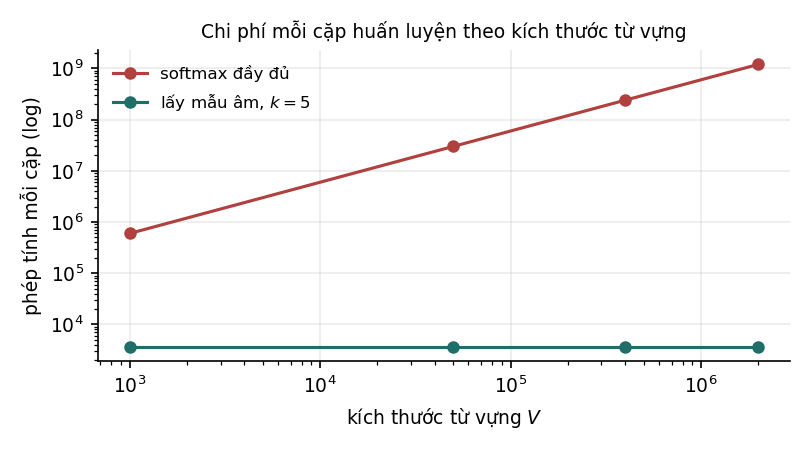
Lấy mẫu âm (negative sampling) thay bài toán "chọn đúng 1 trong từ" bằng bài toán phân loại nhị phân: cặp quan sát được có phải cặp thật không, và cặp ghép ngẫu nhiên có phải cặp thật không. Hàm mục tiêu cho mỗi cặp là
với là phân phối để rút từ ngẫu nhiên. Chi phí mỗi cặp không còn phụ thuộc vào , nhờ vậy word2vec huấn luyện được trên kho hàng tỉ từ ngay từ năm 2013. Trong bài báo gốc, tỉ lệ với tần suất của từ mũ ; số mũ này được chọn bằng thực nghiệm.
2.6Skip-gram phân rã ma trận PMI#
Đến đây có hai cách tạo embedding trông rất khác nhau: một cách đếm rồi phân rã ma trận, một cách huấn luyện bằng gradient descent trên từng cặp từ. Định lý sau cho thấy chúng nhắm tới cùng một ma trận.
Định lý 2.1 (Levy và Goldberg, 2014)
Nếu các vector đủ nhiều chiều để mọi tích vô hướng nhận giá trị tuỳ ý, thì điểm tối ưu của skip-gram với lấy mẫu âm, với mẫu âm rút từ phân phối unigram, thoả
Chứng minh
Với là tổng số cặp, cặp xuất hiện lần như cặp thật và, theo kỳ vọng, lần như cặp âm. Phần hàm mục tiêu phụ thuộc là
Dùng và , cho đạo hàm bằng 0:
Thay được .
Như vậy skip-gram với lấy mẫu âm là một cách phân rã ma trận PMI (dịch đi ) mà không cần lập ma trận: mỗi bước gradient chỉ chạm vào một cặp quan sát được và vài cặp ngẫu nhiên. Mô hình cũng không phải mạng nơ-ron sâu như tên gọi thường gợi ý: nó chỉ có một lớp, không có hàm phi tuyến ở giữa.
Định lý kiểm chứng được bằng số. Thí nghiệm tối ưu hàm mục tiêu kỳ vọng của skip-gram bằng gradient descent, với (để đích đúng bằng PMI) và phân phối unigram, rồi so tích vô hướng học được với PMI trên các cặp có đồng hiện:
| Số chiều | Tương quan với PMI | Sai lệch tuyệt đối trung bình | Sai lệch lớn nhất |
|---|---|---|---|
| 8 (hạng thấp) | 0,3727 | 0,2862 | 1,0566 |
| 20 (hạng đầy đủ) | 0,9995 | 0,0106 | 0,0251 |
Ở hạng đầy đủ, gradient descent hội tụ về đúng ma trận PMI, khớp Định lý 2.1: một bên là công thức giải tích, một bên là 4 000 vòng lặp tối ưu, cho cùng một ma trận.
Ở hạng thấp, mô hình không khớp chính xác được và phải chọn giữ lại phần nào của ma trận. Sự lựa chọn này khác với SVD. SVD cho xấp xỉ tốt nhất theo tổng bình phương sai số với trọng số như nhau cho mọi phần tử; skip-gram cho một xấp xỉ có trọng số theo tần suất của các cặp, và dùng hai bộ vector riêng cho từ và ngữ cảnh. Trên kho ngữ liệu này, embedding skip-gram hạng 8 (lấy các vector từ ) chỉ giải đúng 20,4% phép loại suy, so với 100% của SVD trên PPMI cùng số chiều. Kết quả không có nghĩa skip-gram kém hơn nói chung: Levy, Goldberg và Dagan (2015) so sánh trên dữ liệu thật và kết luận rằng khác biệt giữa các phương pháp phụ thuộc vào siêu tham số và cách xử lý dữ liệu nhiều hơn vào bản thân thuật toán. Điều ví dụ cho thấy là hai phương pháp cùng nhắm tới một ma trận vẫn có thể cho embedding rất khác nhau khi bị giới hạn số chiều.
2.7Các hiểu lầm thường gặp#
Word2Vec thường được giới thiệu như một thành tựu của học sâu, và cách giới thiệu đó để lại khá nhiều hiểu lầm. Bảng dưới đối chiếu những hiểu lầm hay gặp với điều các mục trên đã chỉ ra.
| Phát biểu | Thực tế |
|---|---|
| "Word2Vec là học sâu." | Mô hình chỉ có một lớp tuyến tính; về bản chất là phân rã ma trận. |
| "Lấy mẫu âm là phép xấp xỉ của softmax." | Không hẳn: đó là một hàm mục tiêu khác, có nghiệm là PMI dịch , không phải nghiệm của softmax đầy đủ. |
| "Embedding hiểu nghĩa của từ." | Embedding chỉ nắm thống kê đồng hiện, nên không phân biệt được các từ trái nghĩa xuất hiện trong ngữ cảnh giống nhau. |
| "Vector cộng trừ được nên mô hình biết suy luận." | Tính cộng được đến từ cấu trúc của ma trận PMI. Trên dữ liệu thật, nó đúng với một số quan hệ và sai với nhiều quan hệ khác. |
| "Số mũ 3/4 trong phân phối lấy mẫu âm có cơ sở lý thuyết." | Bài báo gốc chọn số mũ này bằng thực nghiệm. |
2.8Tóm tắt#
Embedding từ dựa trên giả thuyết phân bố: hai từ xuất hiện trong những ngữ cảnh giống nhau thường gần nghĩa. Đếm số lần đồng hiện, chuyển sang PMI để loại ảnh hưởng của tần suất, rồi nén ma trận PPMI bằng SVD đã cho embedding giải đúng cả 240 phép loại suy trên kho ngữ liệu thí nghiệm. Số chiều tốt nhất không phải số chiều lớn nhất mà do phổ của ma trận quyết định. Word2Vec với lấy mẫu âm làm cùng việc mà không lập ma trận, và chi phí mỗi cặp huấn luyện không phụ thuộc kích thước từ vựng. Ở điểm tối ưu, tích vô hướng của nó bằng PMI dịch đi ; ở hạng đầy đủ, thí nghiệm cho tương quan 0,9995 giữa hai đại lượng.
Có embedding rồi, việc tiếp theo là so sánh chúng, và cách so sánh mặc định là cosine. Chương 3 cho thấy cosine có thể cho con số rất cao giữa hai vector không liên quan gì tới nhau, khi đám mây embedding không nằm quanh gốc toạ độ.
3Hình học của không gian embedding#
Có embedding rồi, việc tiếp theo là đo độ giống nhau giữa hai vector, và lựa chọn mặc định là cosine. Thí nghiệm ở Mục 3.2 cho một kết quả dễ gây hiểu nhầm: 900 vector ngẫu nhiên độc lập có cosine trung bình 0,87 với nhau, một con số rất dễ bị đọc thành "giống nhau 87%". Hiện tượng này xảy ra khi đám mây embedding không nằm quanh gốc toạ độ, và hiểu vì sao nó xảy ra cũng cho thấy cách sửa.
3.1Đo độ tương đồng bằng cosine#
Độ tương đồng cosine giữa hai vector là
tức cosine của góc giữa chúng. Lý do thường được nêu để dùng cosine thay cho khoảng cách Euclid là độ dài vector phản ánh tần suất của từ nhiều hơn nghĩa, nên cần loại bỏ. Lý do đó đúng, nhưng cosine có một giả định ngầm: góc giữa hai vector chỉ có ý nghĩa khi đám mây điểm phân bố quanh gốc toạ độ.
3.2Tính bất đẳng hướng#
Nếu toàn bộ embedding lệch về một phía so với gốc toạ độ, mọi cặp vector đều tạo góc nhỏ với nhau, không phải vì chúng giống nhau mà vì chúng cùng chứa một thành phần chung lớn. Hiện tượng này gọi là tính bất đẳng hướng (anisotropy), và nó thường gặp ở embedding lấy từ các mô hình Transformer (Gao và cộng sự, 2019; Ethayarajh, 2019).
Hai chiều đủ để thấy cơ chế. Lấy và : cả hai cùng chứa thành phần chung , phần riêng của chúng là và , hai hướng ngược nhau. Cosine giữa và là . Trừ thành phần chung đi, phần còn lại có cosine . Con số 0,8 hoàn toàn đến từ thành phần chung, và nó che mất việc hai phần riêng thực ra ngược hướng.
Thí nghiệm tạo ba đám mây, mỗi đám 900 vector 64 chiều: các vector là nhiễu Gauss độc lập cộng thêm một vector hằng với độ lớn khác nhau. Độ lệch tâm đo bằng độ dài của vector trung bình chia cho độ dài trung bình của các vector.
| Phân bố | Cosine trung bình giữa hai vector | Sau khi trừ vector trung bình | Độ lệch tâm |
|---|---|---|---|
| Quanh gốc toạ độ | 0,0318 | ||
| Lệch tâm nhẹ | 0,6267 | ||
| Lệch tâm mạnh | 0,9342 |
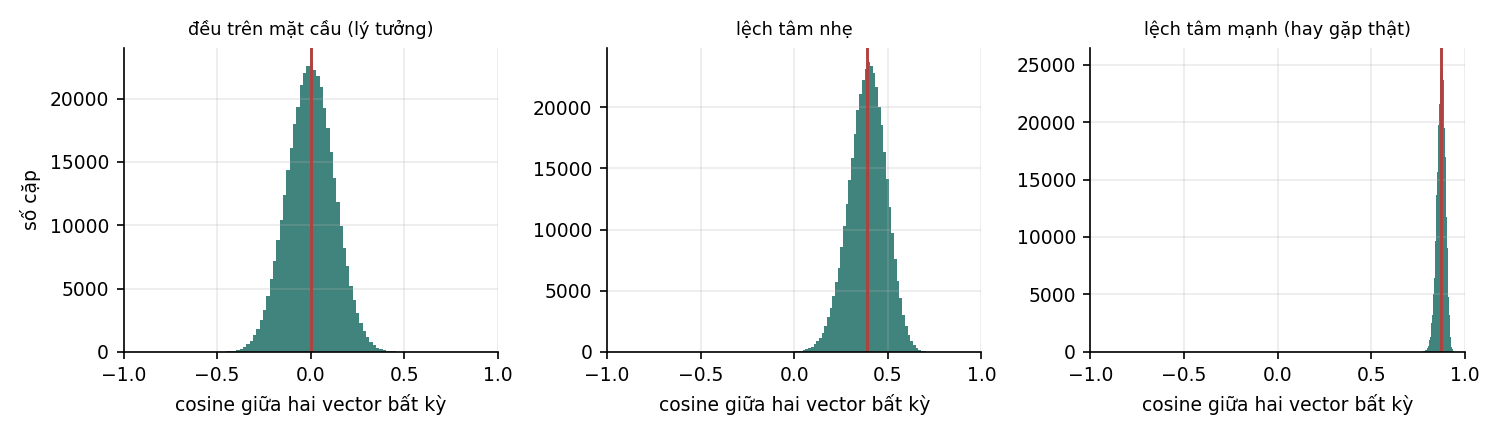
Hàng cuối cần đọc kỹ. Đây là 900 vector ngẫu nhiên độc lập, không có quan hệ ngữ nghĩa nào giữa chúng, vậy mà cosine trung bình giữa hai vector bất kỳ là 0,87. Nếu các vector này là embedding của câu, con số đó có thể bị hiểu nhầm thành "hai câu giống nhau 87%", trong khi nó chỉ phản ánh độ lệch tâm của đám mây.
Cột thứ ba cho thấy cách khắc phục đơn giản: trừ vector trung bình của cả tập khỏi mọi vector, cosine trung bình trở về khoảng 0 ở cả ba trường hợp.
3.3Cách khắc phục#
Có ba cách, xếp theo thứ tự nên thử. Cách rẻ nhất là trừ trung bình: tính vector trung bình trên một mẫu đại diện rồi trừ khỏi mọi embedding trước khi so sánh. Như bảng ở Mục 3.2 cho thấy, chỉ riêng bước này thường đã đủ để cosine có ý nghĩa trở lại.
Mạnh hơn là làm trắng (whitening): sau khi trừ trung bình, nhân thêm với để phương sai theo mọi hướng bằng nhau. Cách này cần ước lượng ma trận hiệp phương sai , việc đòi hỏi nhiều dữ liệu khi số chiều lớn (Mục 7.4 của Nền tảng).
Cách triệt để nhất là huấn luyện embedding với mục tiêu tương phản, sao cho cặp giống nhau gần nhau và cặp khác nhau xa nhau ngay từ đầu. Đây là cách các mô hình embedding câu hiện nay được huấn luyện (Mục 4.2).
Trong thực tế, tính bất đẳng hướng thường lộ ra qua một hệ thống tìm kiếm ngữ nghĩa cho mọi kết quả cosine từ 0,8 trở lên, kể cả những kết quả rõ ràng không liên quan. Nâng ngưỡng không giải quyết được vấn đề, vì thứ hạng giữa các kết quả vẫn bị thành phần chung chi phối; nên trừ trung bình rồi đo lại.
3.4Ý nghĩa của từng chiều#
Một câu hỏi thường gặp là chiều thứ 37 của embedding mang nghĩa gì. Câu trả lời thường là không mang nghĩa riêng nào, và lý do nằm ở toán học. Nếu thì với mọi ma trận trực giao ,
Xoay toàn bộ không gian embedding không làm thay đổi mọi tích vô hướng, nên bài toán chỉ xác định sai khác một phép xoay, và hệ trục toạ độ là tuỳ ý. Thứ có ý nghĩa là quan hệ giữa các vector: khoảng cách, góc, vector hiệu. Phép loại suy ở Mục 2.4 hoạt động vì nó chỉ dùng vector hiệu, mà vector hiệu biến đổi cùng phép xoay.
Ngoại lệ là khi huấn luyện có thêm ràng buộc thưa, ví dụ bằng bộ tự mã hoá thưa (sparse autoencoder): khi đó các chiều có thể trở nên diễn giải được. Đây là một hướng nghiên cứu về khả năng diễn giải của mô hình ngôn ngữ hiện nay, và hướng này cần thiết chính vì theo mặc định các chiều không có nghĩa riêng.
3.5Tóm tắt#
Cosine đo góc giữa hai vector, và góc chỉ có ý nghĩa khi đám mây điểm nằm quanh gốc toạ độ. Embedding thật thường lệch tâm, và khi lệch mạnh, hai vector ngẫu nhiên độc lập đã có cosine trung bình 0,87. Trừ vector trung bình đưa con số đó về khoảng 0; làm trắng mạnh hơn nhưng cần ước lượng ma trận hiệp phương sai; huấn luyện với mục tiêu tương phản sửa tận gốc. Từng chiều riêng lẻ của embedding thường không mang nghĩa, vì xoay cả không gian không làm đổi tích vô hướng nào; thứ mang nghĩa là quan hệ giữa các vector.
Embedding của Chương 2 còn một giới hạn mà không phép biến đổi hình học nào sửa được: mỗi từ chỉ có một vector, dù từ đó có nhiều nghĩa. Chương 4 bỏ giới hạn này bằng embedding theo ngữ cảnh, rồi xét bài toán tìm kiếm trên hàng triệu vector.
4Embedding theo ngữ cảnh và tìm kiếm vector#
Word2Vec gán cho mỗi từ đúng một vector, bất kể từ đó xuất hiện trong câu nào. Với những từ nhiều nghĩa, đây là giới hạn của chính thiết kế. Transformer bỏ được giới hạn này, nhưng trạng thái ẩn của một mô hình ngôn ngữ chưa phải embedding câu tốt; phải huấn luyện thêm bằng học tương phản. Khi đã có embedding tốt cho hàng triệu văn bản, bài toán chuyển sang tìm kiếm: tìm nhanh những vector gần một truy vấn. Chương 6 và 7 của Ứng dụng LLM trình bày cùng chủ đề từ phía ứng dụng, kèm thí nghiệm trên văn bản tiếng Việt.
4.1Hạn chế của embedding tĩnh#
Một vector cho mỗi từ không phân biệt được các nghĩa khác nhau của cùng một từ. Trong hai câu "Con đường này dài quá" và "Cho thêm đường vào cà phê", chữ "đường" mang hai nghĩa không liên quan gì tới nhau. Vector duy nhất của "đường" phải là một thoả hiệp giữa hai nghĩa, thường nghiêng về nghĩa phổ biến hơn trong dữ liệu, và không biểu diễn tốt nghĩa nào. Đây là giới hạn của thiết kế, không phải của cách huấn luyện: bất kỳ phương pháp nào gán một vector cho một chuỗi ký tự đều gặp vấn đề này.
4.2Embedding theo ngữ cảnh và học tương phản#
Cách khắc phục là gán vector cho một lần xuất hiện của từ trong một câu cụ thể, thay vì cho từ. Transformer làm đúng điều đó (Chương 9 của Học sâu): mỗi lớp attention kết hợp thông tin giữa các vị trí, nên biểu diễn của một token ở các lớp sau chứa thông tin của cả câu, và chữ "đường" trong hai câu trên có hai vector khác nhau. ELMo (Peters và cộng sự, 2018) và BERT (Devlin và cộng sự, 2019) là những mô hình đầu tiên phổ biến cách làm này.
Từ đó có một cách tạo embedding cho cả câu có vẻ tự nhiên: đưa câu qua một mô hình đã tiền huấn luyện rồi lấy trung bình các trạng thái ẩn. Nhưng kết quả thường kém.
Lưu ý
Trạng thái ẩn của một mô hình tiền huấn luyện chưa phải embedding câu tốt. Mô hình được huấn luyện để đoán token bị che hoặc token tiếp theo, không được huấn luyện để hai câu cùng nghĩa có biểu diễn gần nhau. Reimers và Gurevych (2019) cho thấy trung bình các vector đầu ra của BERT cho kết quả trên các bộ đánh giá độ tương đồng câu kém hơn cả trung bình các vector GloVe tĩnh. Tính bất đẳng hướng ở Chương 3 là một phần nguyên nhân.
Cách làm đúng là huấn luyện thêm với mục tiêu tương phản (contrastive objective): dùng các cặp câu đã biết là liên quan (câu hỏi và đoạn trả lời, câu và bản dịch, hai cách diễn đạt của cùng một ý), và tối ưu
trong đó là embedding của một câu, là embedding của câu cặp với nó, các là embedding của mọi câu cặp trong lô (gồm cả ), và là nhiệt độ, thường cỡ 0,01 tới 0,1. Hàm này có dạng cross-entropy của hồi quy softmax (Mục 6.4 của Nền tảng), trong đó "lớp đúng" là câu cặp thật và các "lớp sai" là những câu còn lại trong lô. Dạng hàm mất mát này thường được gọi là InfoNCE (van den Oord, Li và Vinyals, 2018). Chẳng hạn với một lô ba cặp, câu có cosine 0,8 với câu cặp của nó và 0,3; 0,1 với hai câu còn lại. Với , ba logit là 8, 3 và 1, softmax gán 0,992 cho câu cặp và mất mát chỉ còn 0,008. Với , ba logit là 0,8; 0,3; 0,1, câu cặp chỉ nhận xác suất 0,48 và mất mát là 0,74, dù cosine của nó cao nhất. Nhiệt độ nhỏ phóng đại chênh lệch giữa các cosine, nên mô hình được thưởng ngay khi câu cặp đứng đầu một cách rõ ràng.
Các câu khác trong cùng lô đóng vai trò mẫu âm, nên không phải tìm mẫu âm riêng; lô càng lớn thì càng nhiều mẫu âm, và các mô hình embedding tốt thường huấn luyện với lô rất lớn. Đây là cùng ý tưởng lấy mẫu âm ở Mục 2.5. SimCSE (Gao, Yao và Chen, 2021) cho thấy mục tiêu này vẫn hoạt động khi "câu cặp" chỉ là chính câu đó đi qua mô hình hai lần với dropout khác nhau. Các mô hình embedding hiện nay như họ E5 (Wang và cộng sự, 2022), dùng trong các thí nghiệm của Ứng dụng LLM, được huấn luyện theo cách này trên hàng trăm triệu cặp văn bản.
4.3Tìm kiếm vector#
Có embedding rồi, bài toán tiếp theo thường là: cho một truy vấn, tìm vector gần nhất trong một kho vector. Tìm chính xác bằng cách tính khoảng cách tới mọi vector tốn phép tính cho mỗi truy vấn. Với và , đó là khoảng 7,7 tỉ phép nhân–cộng cho một truy vấn, quá chậm nếu cần trả lời trong vài chục mili giây với nhiều truy vấn mỗi giây. Các cấu trúc dữ liệu cổ điển như cây k-d cũng không giúp được ở số chiều cao, vì lời nguyền số chiều làm chúng thoái hoá về quét toàn bộ (Mục 7.2 của Nền tảng).
Lối ra là chấp nhận tìm kiếm láng giềng gần đúng (approximate nearest neighbor, ANN): chỉ hứa trả về các vector gần, không hứa trả về đúng vector gần nhất, đổi lại nhanh hơn hàng chục tới hàng trăm lần. Ba họ phương pháp chính đánh đổi khác nhau giữa tốc độ, bộ nhớ và độ chính xác:
| Họ phương pháp | Ý tưởng | Đánh đổi |
|---|---|---|
| IVF (inverted file) | phân cụm kho bằng k-means; truy vấn chỉ quét vài cụm gần nhất | tốn ít bộ nhớ; có thể bỏ sót vector nằm gần biên cụm |
| HNSW | đồ thị láng giềng nhiều tầng; tìm bằng cách đi tham lam từ tầng thưa xuống tầng dày | nhanh và chính xác; tốn bộ nhớ để lưu đồ thị |
| PQ (product quantization) | chia vector thành nhiều đoạn, lượng tử hoá mỗi đoạn bằng một bảng mã nhỏ | nén mạnh; mất độ chính xác do lượng tử hoá |
PQ có liên hệ trực tiếp với giáo trình Quantization: đó là lượng tử hoá áp dụng cho từng đoạn của vector, với cùng đánh đổi giữa sai số và dung lượng. Chương 7 của Ứng dụng LLM đo cả ba phương pháp trên 4 419 vector.
Trước khi chọn phương pháp hay thư viện, nên tính dung lượng của kho. Một kho 10 triệu vector 768 chiều lưu ở FP32 chiếm
Con số này quyết định phần lớn kiến trúc hệ thống: nó không vừa bộ nhớ của một máy chủ thông thường, nên phải giảm độ chính xác số (FP16 còn 15,4 GB), nén bằng PQ, hoặc chia kho cho nhiều máy.
4.4Đánh giá hệ thống tìm kiếm vector#
Vì đã chấp nhận xấp xỉ, cần đo mức mất mát. Chỉ số chuẩn là recall@k của chỉ mục: trong kết quả trả về, bao nhiêu phần trăm thuộc về kết quả đúng tìm bằng quét toàn bộ, tính trên một mẫu truy vấn. Mỗi phương pháp có một tham số điều chỉnh độ chính xác (số cụm được quét với IVF, kích thước hàng đợi với HNSW), và kết quả nên được vẽ thành đường recall theo độ trễ. Giống đường ROC (Mục 8.3 của Nền tảng), không có điểm tốt nhất chung; chọn điểm nào trên đường là quyết định nghiệp vụ.
Recall của chỉ mục cao không bảo đảm hệ thống tìm kiếm hữu ích. Nếu bản thân embedding không nắm được điều người dùng coi là "liên quan", tìm đúng 100% láng giềng gần nhất vẫn cho kết quả vô dụng. Chất lượng embedding (đo bằng recall theo nhãn liên quan do người gán; Mục 6.6 của Ứng dụng LLM) và chất lượng chỉ mục (đo bằng recall so với tìm chính xác) là hai đại lượng khác nhau và phải đo riêng.
4.5Tóm tắt#
Embedding tĩnh gán một vector cho mỗi từ nên không phân biệt được các nghĩa của cùng một từ. Transformer gán vector cho từng lần xuất hiện, nhưng trạng thái ẩn của một mô hình chỉ được huấn luyện để đoán token chưa phải embedding câu tốt: trung bình các vector đầu ra của BERT còn kém trung bình vector GloVe trên các bộ đánh giá độ tương đồng câu. Huấn luyện thêm với hàm mất mát InfoNCE, dùng các câu khác trong lô làm mẫu âm, mới cho embedding câu dùng được. Với hàng triệu vector, tìm chính xác quá chậm, nên các hệ thống dùng tìm kiếm láng giềng gần đúng như IVF, HNSW hoặc PQ, và phải đo riêng hai thứ: chất lượng của embedding và recall của chỉ mục.
Các mô hình embedding ở chương này, cũng như mọi mô hình ngôn ngữ lớn, bắt đầu từ cùng một bước: tiền huấn luyện trên lượng lớn dữ liệu không nhãn. Chương 5 giải thích vì sao bước đó hiệu quả và có những cách nào để dùng lại một mô hình đã tiền huấn luyện.
5Tiền huấn luyện#
Mọi mô hình embedding ở Chương 4 đều bắt đầu từ một mô hình đã tiền huấn luyện, tức một mô hình lớn được huấn luyện trên dữ liệu không nhãn trước khi dùng cho nhiệm vụ cụ thể. Đây cũng là bước đầu tiên của mọi mô hình ngôn ngữ lớn. Cách làm này hiệu quả vì một lý do kinh tế đơn giản, và vì nhiệm vụ huấn luyện trông rất hẹp, đoán token tiếp theo, lại buộc mô hình học được nhiều điều hơn hẳn những gì tên gọi của nó gợi ra.
5.1Dữ liệu có nhãn và dữ liệu không nhãn#
Dữ liệu có nhãn đắt: thuê người đọc và gán nhãn vài chục nghìn câu tốn nhiều tuần và nhiều tiền, và với những nhãn cần chuyên môn như y tế hay pháp lý thì còn đắt hơn. Dữ liệu không nhãn rẻ hơn rất nhiều: văn bản, ảnh, mã nguồn công khai có sẵn với khối lượng lớn hơn hàng triệu lần. Bất kỳ cách nào biến dữ liệu không nhãn thành thứ có ích đều có giá trị lớn.
Tiền huấn luyện làm điều đó bằng một nhiệm vụ mà nhãn tự sinh ra từ dữ liệu, gọi là học tự giám sát (self-supervised learning): che một từ rồi đoán lại nó, hoặc đoán từ tiếp theo từ các từ phía trước. Không ai phải gán nhãn, nhưng mô hình vẫn có tín hiệu để học trên mọi vị trí của mọi văn bản.
5.2Những gì mô hình học được khi dự đoán token tiếp theo#
Để đoán đúng token tiếp theo trong mọi ngữ cảnh, mô hình buộc phải học nhiều thứ khác. Muốn điền đúng "Thủ đô của Pháp là ___", nó phải biết sự kiện về thế giới. Với "Cô ấy mở tủ lạnh và lấy ra một chai ___", nó phải hiểu tình huống thực tế, tức trong tủ lạnh thường có gì. Câu "Mặc dù trời mưa rất to, anh ấy vẫn ___" đòi hỏi nắm quan hệ nhượng bộ trong ngữ pháp, "2 + 3 = ___" đòi hỏi làm được phép tính đơn giản, còn "def fibonacci(n): if n <= 1: return n; return fibonacci(n-1) + ___" đòi hỏi hiểu cấu trúc của mã nguồn.
Không kỹ năng nào trong số đó được dạy riêng. Mô hình học chúng vì không học thì không giảm được mất mát dự đoán token tiếp theo trên một kho văn bản đủ lớn và đủ đa dạng. Vì vậy dự đoán token tiếp theo là một nhiệm vụ đại diện rất rộng: nó không phải mục tiêu cuối cùng mà là cách buộc mô hình xây dựng biểu diễn hữu ích về ngôn ngữ và về thế giới được mô tả trong văn bản.
5.3Các cách tái sử dụng mô hình tiền huấn luyện#
Có một mô hình đã tiền huấn luyện, ta có bốn cách dùng nó cho nhiệm vụ của mình. Các cách này khác nhau ở phần nào của mô hình được cập nhật (Hình 5), và do đó ở số tham số phải học và lượng dữ liệu có nhãn cần có.
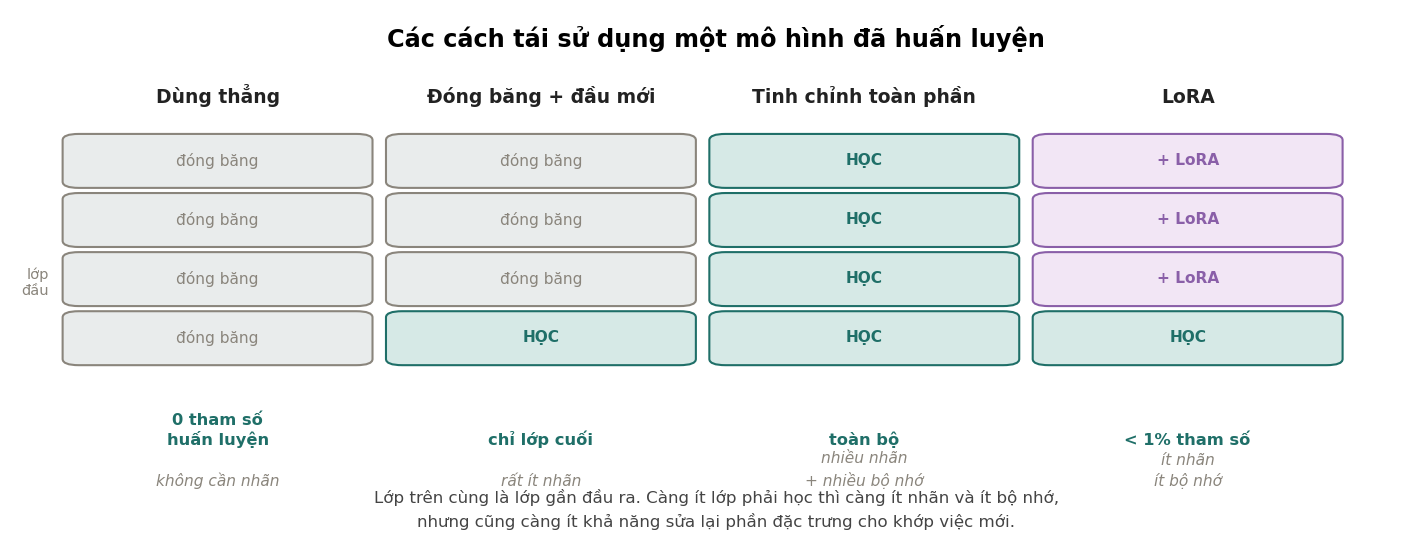
| Cách | Số tham số phải học | Lượng dữ liệu có nhãn cần | Khi nào dùng |
|---|---|---|---|
| Dùng trực tiếp, chỉ viết prompt | 0 | không cần, hoặc vài ví dụ trong prompt | nhiệm vụ nằm trong khả năng sẵn có của mô hình |
| Đóng băng, học thêm một lớp tuyến tính | chỉ lớp cuối | ít | ít nhãn; nhiều nhiệm vụ dùng chung một bộ đặc trưng |
| Tinh chỉnh toàn phần | toàn bộ | nhiều | nhiều nhãn và đủ bộ nhớ |
| LoRA và các phương pháp tương tự | dưới 1% | ít tới vừa phải | cần điều chỉnh sâu hơn một lớp tuyến tính nhưng bộ nhớ hạn chế |
Cách thứ hai còn gọi là linear probing: đặc trưng của mô hình được giữ nguyên và chỉ học một bộ phân loại tuyến tính trên đó. Câu hỏi thực tế là với bao nhiêu nhãn thì nên chuyển từ cách này sang cách khác. Chương 6 trả lời bằng số đo, Chương 7 trình bày LoRA, còn cách dùng mô hình qua prompt nằm ở Chương 3 và 4 của Ứng dụng LLM.
5.4Giới hạn của tiền huấn luyện#
Tiền huấn luyện không giúp được trong mọi trường hợp. Khi miền đích quá xa miền tiền huấn luyện, các đặc trưng học được không dùng lại được: một mô hình học trên văn bản web giúp được rất ít cho tín hiệu cảm biến công nghiệp. Khi nhiệm vụ đích cần kỹ năng mà nhiệm vụ tiền huấn luyện ít đòi hỏi, mô hình cũng yếu ở đó: mô hình ngôn ngữ thường giỏi ngữ pháp hơn số học nhiều chữ số, vì dự đoán token tiếp theo hiếm khi đòi hỏi tính toán chính xác.
Mô hình còn mang theo thiên kiến của dữ liệu. Nó học từ văn bản do người viết, nên học cả những định kiến trong đó, và tinh chỉnh có thể làm giảm nhưng không xoá hết các định kiến này. Công cụ để phát hiện vấn đề là đánh giá theo lát cắt (Mục 6.3 của MLOps) và kiểm thử phản thực tế (Mục 11.4 của Ứng dụng LLM).
5.5Tóm tắt#
Dữ liệu có nhãn đắt, còn dữ liệu không nhãn rẻ và có sẵn với khối lượng lớn hơn hàng triệu lần, nên một nhiệm vụ có nhãn tự sinh ra từ dữ liệu như đoán token tiếp theo có giá trị rất lớn. Nhiệm vụ đó buộc mô hình học sự kiện về thế giới, ngữ pháp, phép tính đơn giản và cấu trúc mã nguồn, vì thiếu chúng thì không đoán đúng được. Một mô hình đã tiền huấn luyện được dùng lại theo bốn cách: chỉ viết prompt, đóng băng và học một lớp tuyến tính, tinh chỉnh toàn phần, hoặc dùng LoRA. Tiền huấn luyện ít giúp ích khi miền đích quá xa hoặc khi nhiệm vụ cần kỹ năng hiếm gặp trong dữ liệu, và mô hình mang theo định kiến của dữ liệu.
Giữa các cách dùng lại, lựa chọn hay gặp nhất là đóng băng hay tinh chỉnh toàn phần. Trực giác nói ít dữ liệu thì đóng băng, nhiều dữ liệu thì tinh chỉnh, nhưng không cho biết ranh giới nằm ở đâu. Chương 6 đo ranh giới đó bằng một thí nghiệm có kiểm soát.
6Đóng băng và tinh chỉnh#
Có một mô hình đã tiền huấn luyện và mẫu có nhãn cho nhiệm vụ của mình: nên đóng băng phần trích đặc trưng và chỉ học lớp cuối, hay cho cả mô hình học lại? Ta trả lời câu hỏi này bằng một thí nghiệm có kiểm soát, trong đó ba cách làm dùng cùng một cài đặt mạng, và đo độ chính xác theo số mẫu có nhãn.
6.1Trực giác về đóng băng và tinh chỉnh#
Trực giác thông thường là ít dữ liệu thì đóng băng, nhiều dữ liệu thì tinh chỉnh. Lý do là đóng băng chỉ phải ước lượng một lớp tuyến tính, nên ít có nguy cơ overfitting; còn tinh chỉnh có nhiều tham số hơn nhiều, cần nhiều dữ liệu hơn, nhưng sửa được những đặc trưng chưa phù hợp. Trực giác này không cho biết ngưỡng chuyển đổi nằm ở đâu, mà ngưỡng mới là điều cần biết khi phải quyết định.
6.2Thiết kế thí nghiệm#
Để so sánh có ý nghĩa, ba cấu hình phải dùng cùng một cài đặt mạng và chỉ khác nhau ở hai điểm:
| Cấu hình | Trọng số ban đầu của lớp ẩn | Lớp ẩn có được cập nhật không |
|---|---|---|
| Đóng băng, học lớp tuyến tính | tiền huấn luyện | không |
| Tinh chỉnh toàn phần | tiền huấn luyện | có |
| Huấn luyện từ đầu | ngẫu nhiên | có |
Lưu ý
Lớp
MLPClassifiercủa scikit-learn không cho nạp trọng số ban đầu, nên nếu dùng nó cho cột "tinh chỉnh toàn phần", cấu hình đó thực chất là huấn luyện từ đầu, và hai cột sẽ cho kết quả gần như trùng nhau. Đây là một lỗi thiết kế thí nghiệm dễ mắc: tên cấu hình không khớp với việc mã thực sự làm. Thí nghiệm ở đây tự cài một mạng một lớp ẩn bằng NumPy để kiểm soát được trọng số khởi tạo.
Dữ liệu mô phỏng tình huống thực tế: đầu vào 40 chiều, lớp ẩn 24 đơn vị tanh, 4 lớp. Nhãn được sinh bởi một phép chiếu "thật" theo sau là một lớp tuyến tính, cộng nhiễu. Mô hình "tiền huấn luyện" dùng cộng nhiễu, tức đặc trưng gần đúng nhưng không trùng khớp với nhiệm vụ đích, giống quan hệ giữa một mô hình tiền huấn luyện và một nhiệm vụ cụ thể trong thực tế. Độ chính xác đo trên 4 000 mẫu kiểm tra; mỗi cấu hình chạy một lần với mỗi cỡ dữ liệu.
6.3Kết quả#
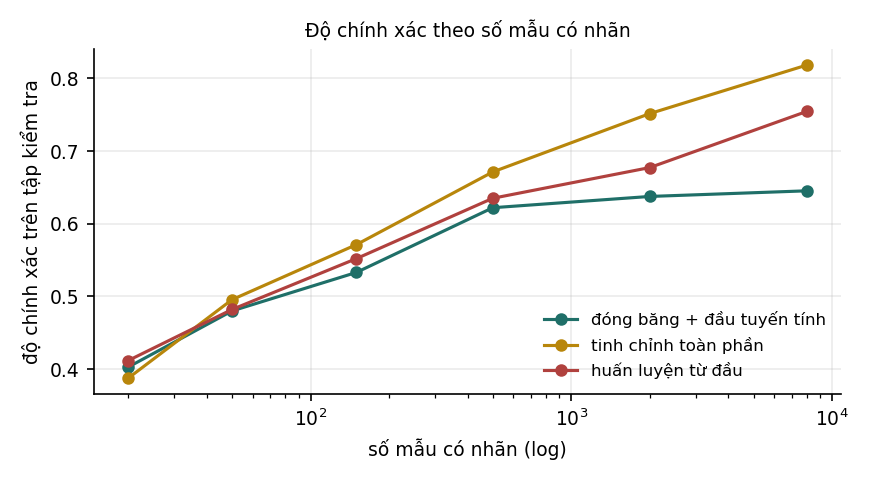
| Số mẫu có nhãn | Đóng băng, học lớp tuyến tính | Tinh chỉnh toàn phần | Huấn luyện từ đầu |
|---|---|---|---|
| 20 | 0,4027 | 0,3875 | 0,4118 |
| 50 | 0,4800 | 0,4955 | 0,4820 |
| 150 | 0,5330 | 0,5713 | 0,5520 |
| 500 | 0,6220 | 0,6713 | 0,6350 |
| 2 000 | 0,6375 | 0,7515 | 0,6773 |
| 8 000 | 0,6452 | 0,8183 | 0,7545 |
Hai hàng đầu cần đọc thận trọng. Với 20 và 50 mẫu, ba cấu hình không phân biệt được: với 20 mẫu và 4 lớp, mỗi lớp chỉ có khoảng 5 mẫu, mỗi cấu hình chỉ chạy một lần, và chênh lệch 0,01 tới 0,02 giữa các cột nằm trong mức dao động giữa các lần chạy. Không nên rút ra kết luận nào từ hai hàng này. Nói riêng, bảng không cho thấy đóng băng thắng khi ít dữ liệu, dù đó là điều trực giác dự đoán.
Từ 150 mẫu trở lên, tinh chỉnh toàn phần vượt hai cách còn lại, và khoảng cách so với đóng băng tăng dần: 0,04 ở 150 mẫu, 0,11 ở 2 000 mẫu, 0,17 ở 8 000 mẫu. Đặc trưng tiền huấn luyện chỉ gần đúng với nhiệm vụ, nên khi có đủ dữ liệu, sửa chúng có lợi hơn nhiều so với chỉ học một lớp tuyến tính phía trên.
Cột đóng băng gần như không tăng từ 500 mẫu trở đi (0,622; 0,638; 0,645). Khi đặc trưng bị cố định, mô hình chỉ còn là hồi quy softmax trên các đặc trưng đó. Thêm dữ liệu giúp ước lượng lớp tuyến tính chính xác hơn, nhưng không vượt được giới hạn do chính các đặc trưng đặt ra. Theo ngôn ngữ của Mục 2.4 của Học sâu, đây là tình trạng độ chệch cao: nếu đang đóng băng mà thêm dữ liệu không cải thiện độ chính xác, thêm nữa cũng không giúp, và cần cho phép cập nhật các lớp phía dưới.
Tinh chỉnh còn tốt hơn huấn luyện từ đầu ở mọi cỡ dữ liệu từ 150 mẫu trở lên, kể cả ở 8 000 mẫu (0,818 so với 0,755). Trọng số tiền huấn luyện vì vậy vẫn có ích khi dữ liệu đã nhiều: chúng là một điểm khởi đầu tốt hơn cho tối ưu.
6.4Kinh nghiệm khi tinh chỉnh#
Ngoài kết quả đo được, có một số kinh nghiệm phổ biến khi tinh chỉnh; chúng không phải kết quả đo trong giáo trình. Tốc độ học khi tinh chỉnh thường nhỏ hơn 10 tới 100 lần so với khi huấn luyện từ đầu, vì trọng số hiện tại đã tốt và một bước cập nhật lớn có thể phá hỏng những gì đã học trước khi kịp học điều mới. Mở đóng băng dần từ các lớp trên xuống thường ổn định hơn mở tất cả cùng lúc (Howard và Ruder, 2018), vì các lớp gần đầu vào học những đặc trưng chung nhất và ít cần sửa nhất.
Tinh chỉnh trên ít dữ liệu còn có thể gây quên thảm hoạ (catastrophic forgetting; McCloskey và Cohen, 1989): mô hình mất khả năng ở những việc nó từng làm được. Nếu điều đó quan trọng, có thể trộn một phần dữ liệu của miền gốc vào dữ liệu tinh chỉnh, hoặc dùng LoRA (Chương 7), vốn giữ nguyên trọng số gốc.
6.5Tóm tắt#
Thí nghiệm so sánh ba cấu hình chỉ khác nhau ở trọng số khởi tạo của lớp ẩn và việc lớp ẩn có được cập nhật hay không. Với 20 và 50 mẫu, ba cấu hình không phân biệt được. Từ 150 mẫu, tinh chỉnh toàn phần dẫn đầu, và ở 8 000 mẫu nó hơn đóng băng 0,17 và hơn huấn luyện từ đầu 0,06. Cột đóng băng chững lại từ 500 mẫu: khi đặc trưng bị cố định, thêm dữ liệu không vượt được giới hạn do đặc trưng đặt ra, và đó là dấu hiệu cần cho các lớp dưới học lại. Khi tinh chỉnh, tốc độ học nên nhỏ, và cần đề phòng quên thảm hoạ.
Tinh chỉnh toàn phần thắng khi có đủ dữ liệu, nhưng với một mô hình hàng tỉ tham số, nó đòi hỏi bộ nhớ vượt xa một GPU và tạo ra một bản sao đầy đủ của mô hình cho mỗi nhiệm vụ. Chương 7 tính cụ thể chi phí đó và trình bày LoRA, cách giữ phần lớn lợi ích của tinh chỉnh trong khi chỉ học một phần rất nhỏ số tham số.
7LoRA và tinh chỉnh tiết kiệm tham số#
Tinh chỉnh toàn phần cho kết quả tốt nhất khi có đủ dữ liệu (Chương 6), nhưng đòi hỏi bộ nhớ rất lớn và tạo ra một bản sao đầy đủ của mô hình cho mỗi nhiệm vụ. LoRA (Hu và cộng sự, 2022) giải quyết cả hai vấn đề bằng cách giữ nguyên trọng số gốc và chỉ học một phần cộng thêm có hạng thấp. Muốn thấy LoRA tiết kiệm được bao nhiêu, trước hết cần tính tinh chỉnh toàn phần tốn bao nhiêu.
7.1Chi phí bộ nhớ của tinh chỉnh toàn phần#
Xét Llama 2 7B với 6 476 005 376 tham số không tính embedding (Chương 12 của Học sâu). Tinh chỉnh toàn phần bằng Adam với mọi đại lượng lưu ở FP32 cần:
| Thành phần | Dung lượng |
|---|---|
| Trọng số | 24,1 GiB |
| Gradient | 24,1 GiB |
| Trạng thái Adam ( và ) | 48,2 GiB |
| Tổng, chưa tính giá trị kích hoạt | 96,4 GiB |
Một GPU 80 GB không đủ, và đây mới là mô hình nhỏ nhất trong họ Llama 2. Huấn luyện với độ chính xác hỗn hợp cần khoảng 16 byte mỗi tham số (Mục 12.5 của Học sâu), tức khoảng 108 GB cho 6,74 tỉ tham số của cả mô hình, vẫn không vừa.
Vấn đề thứ hai là lưu trữ và phục vụ. Nếu 50 khách hàng, mỗi người cần một phiên bản tinh chỉnh riêng, thì phải lưu 50 bản sao đầy đủ của mô hình 13 GB (ở FP16), tức 650 GB, và mỗi bản sao cần bộ nhớ GPU riêng khi phục vụ.
7.2Ý tưởng và giả định#
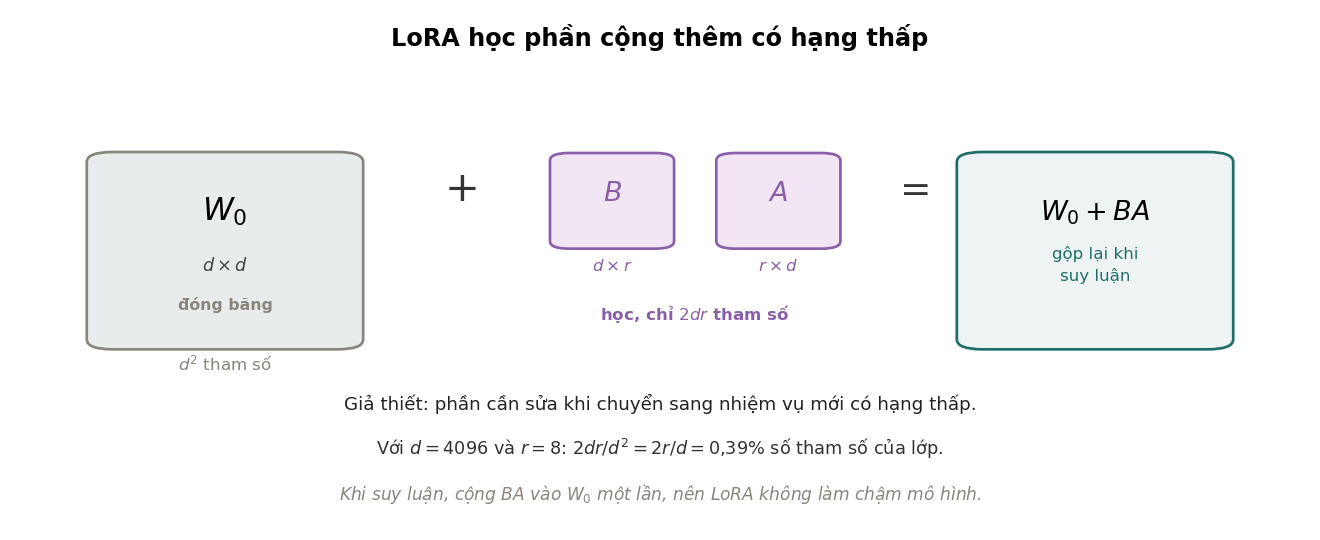
Định nghĩa 7.1 (LoRA)
Với một ma trận trọng số đã tiền huấn luyện, LoRA đóng băng và học
với hạng . Khi huấn luyện, đầu ra của lớp là ; chỉ và được cập nhật.
LoRA dựa trên một giả định, và giả định đó có thể sai: phần cần thay đổi khi chuyển sang nhiệm vụ mới có hạng thấp. Mô hình gốc đã đúng gần hết; phần cần điều chỉnh nằm trong một không gian con ít chiều. Có lý do để tin giả định này: nhiệm vụ đích thường chỉ đòi mô hình nhấn mạnh lại những gì nó đã biết, như một văn phong, một định dạng đầu ra hay một miền kiến thức, chứ không đòi học lại ngôn ngữ. Aghajanyan, Zettlemoyer và Gupta (2021) cũng cho thấy các mô hình tiền huấn luyện có "số chiều nội tại" thấp khi tinh chỉnh: tối ưu trong một không gian con ngẫu nhiên vài trăm chiều đã đạt phần lớn hiệu quả của tinh chỉnh toàn phần.
Có một chi tiết cài đặt cần biết: được khởi tạo ngẫu nhiên còn . Khi đó lúc bắt đầu, và mô hình khởi đầu đúng bằng mô hình gốc rồi thay đổi dần. Nếu khởi tạo cả hai ngẫu nhiên, ngay bước đầu mô hình đã bị cộng một nhiễu ngẫu nhiên. Trong bài báo gốc, còn được nhân với hệ số để có thể đổi mà không phải chỉnh lại tốc độ học.
7.3Số tham số#
Một ma trận có tham số; LoRA hạng có . Tỉ lệ là
giảm khi tăng: mô hình càng lớn, LoRA càng tiết kiệm.
| Mô hình | Ma trận đầy đủ | LoRA | LoRA | Tỉ lệ với | |
|---|---|---|---|---|---|
| GPT-2 small | 768 | 589 824 | 12 288 | 98 304 | 2,083% |
| GPT-2 large | 1 280 | 1 638 400 | 20 480 | 163 840 | 1,250% |
| Llama 2 7B | 4 096 | 16 777 216 | 65 536 | 524 288 | 0,391% |
| Llama 2 70B | 8 192 | 67 108 864 | 131 072 | 1 048 576 | 0,195% |
Bài báo gốc gắn LoRA vào và của mọi lớp attention; lựa chọn này đến từ thử nghiệm nhiều tổ hợp, không từ lý thuyết. Với Llama 2 7B (32 lớp), số tham số huấn luyện là :
| Hạng | Tham số huấn luyện | Tỉ lệ so với mô hình |
|---|---|---|
| 4 | 2 097 152 | 0,0324% |
| 8 | 4 194 304 | 0,0648% |
| 16 | 8 388 608 | 0,1295% |
| 64 | 33 554 432 | 0,5181% |
Với , trạng thái Adam ở FP32 chỉ còn byte, tức 32 MiB, so với 48,2 GiB khi tinh chỉnh toàn phần: nhỏ hơn khoảng 1 540 lần. Trọng số gốc vẫn phải nằm trong bộ nhớ, nhưng chỉ ở dạng đọc (13,5 GB ở FP16), và không cần gradient cho chúng. Đó là khác biệt giữa huấn luyện được trên một GPU và cần một cụm máy.
Thực tế về sau cho thấy gắn LoRA vào mọi ma trận tuyến tính, cả attention lẫn FFN, thường cho chất lượng tốt hơn chỉ gắn vào và với cùng số tham số (Dettmers và cộng sự, 2023), nên nhiều thư viện hiện nay mặc định như vậy.
7.4Các hiểu lầm thường gặp#
Quanh LoRA có ba hiểu lầm hay gặp. Hiểu lầm thứ nhất là LoRA làm mô hình chạy nhanh hơn khi suy luận. Thực tế, khi suy luận có thể cộng vào một lần rồi dùng ma trận đã gộp, nên tốc độ bằng đúng mô hình gốc; nếu không gộp, để đổi adapter nhanh giữa các yêu cầu, thì còn chậm hơn một chút vì có thêm hai phép nhân nhỏ. LoRA tiết kiệm bộ nhớ khi huấn luyện và dung lượng lưu trữ, không tiết kiệm thời gian suy luận.
Hiểu lầm thứ hai là LoRA luôn cho chất lượng bằng tinh chỉnh toàn phần. Bài báo gốc cho kết quả rất gần trên các nhiệm vụ được thử. Nhưng với nhiệm vụ đòi mô hình học kiến thức thật sự mới, chứ không chỉ đổi văn phong hay định dạng, giả định hạng thấp yếu đi và khoảng cách có thể rộng ra (Biderman và cộng sự, 2024).
Hiểu lầm thứ ba là hạng càng cao càng tốt. Hạng cao hơn nghĩa là nhiều tham số hơn, tức phương sai lớn hơn với cùng lượng dữ liệu (Chương 2 của Học sâu). Với ít dữ liệu, hoặc thường đủ, và hạng nên được chọn bằng tập xác thực.
7.5Lợi ích khi phục vụ nhiều mô hình#
Trở lại bài toán 50 khách hàng ở Mục 7.1. Với tinh chỉnh toàn phần, 50 khách hàng cần 50 bản sao 13 GB, tức 650 GB. Với LoRA , cần một bản gốc 13 GB cộng 50 adapter, mỗi adapter khoảng 16 MB ở FP32, tổng cộng khoảng 13,8 GB.
Vì mọi adapter dùng chung trọng số gốc, có thể giữ mô hình gốc trên GPU và chọn adapter theo từng yêu cầu, nên một GPU phục vụ được nhiều khách hàng cùng lúc. Các máy chủ suy luận như vLLM hỗ trợ trực tiếp cách phục vụ này. Lợi ích này độc lập với việc tiết kiệm bộ nhớ khi huấn luyện, và là một lý do chính khiến LoRA được dùng rộng rãi trong sản phẩm.
7.6Các phương pháp liên quan#
LoRA không phải cách duy nhất để tinh chỉnh với ít tham số. Bảng dưới đặt nó cạnh các phương pháp cùng họ.
| Phương pháp | Cách làm | Ghi chú |
|---|---|---|
| Adapter (Houlsby và cộng sự, 2019) | chèn các lớp nhỏ mới vào giữa các lớp của mô hình | có trước LoRA; tăng độ trễ vì không gộp vào trọng số gốc được |
| Prefix tuning, prompt tuning (Li và Liang, 2021; Lester, Al-Rfou và Constant, 2021) | học một số vector "token ảo" đặt trước đầu vào | rất ít tham số; chiếm một phần ngữ cảnh; khó huấn luyện hơn |
| BitFit (Ben Zaken, Ravfogel và Goldberg, 2022) | chỉ tinh chỉnh các hệ số chặn | cực ít tham số; đủ cho nhiệm vụ đơn giản |
| QLoRA (Dettmers và cộng sự, 2023) | LoRA trên mô hình gốc đã lượng tử hoá 4 bit | giảm tiếp bộ nhớ của phần đóng băng; xem Chương 11 của Quantization |
QLoRA hoạt động được vì mô hình gốc chỉ được đọc, không được cập nhật: lượng tử hoá nó làm giảm bộ nhớ của phần đóng băng mà không cản trở việc huấn luyện adapter, vốn vẫn ở độ chính xác cao. Hai kỹ thuật kết hợp được vì chúng tác động lên hai phần khác nhau của bộ nhớ. Với QLoRA, tinh chỉnh một mô hình 65 tỉ tham số vừa một GPU 48 GB.
7.7Tóm tắt#
Tinh chỉnh toàn phần Llama 2 7B bằng Adam ở FP32 cần 96,4 GiB chưa tính giá trị kích hoạt, và mỗi nhiệm vụ cần một bản sao đầy đủ của mô hình. LoRA đóng băng trọng số gốc và chỉ học phần cộng thêm có hạng , dựa trên giả định phần cần thay đổi nằm trong một không gian con ít chiều. Tỉ lệ tham số giảm khi mô hình lớn lên; với Llama 2 7B và trên , , trạng thái Adam chỉ còn 32 MiB. LoRA không làm suy luận nhanh hơn, nhưng cho phép một mô hình gốc phục vụ nhiều adapter, và kết hợp được với lượng tử hoá trong QLoRA.
Đến đây, mô hình mới được dùng để biểu diễn và phân loại. Một mô hình ngôn ngữ còn làm một việc khác hẳn: sinh ra văn bản mới. Chương 8 xét bài toán sinh nói chung và lý do bài toán này khó hơn phân loại nhiều.
8Mô hình sinh#
Các chương trước dùng mô hình để biểu diễn và phân loại, tức học . Mô hình sinh học phân phối của chính dữ liệu, , để có thể lấy ra mẫu mới: một ảnh chưa từng có, một câu chưa ai viết. Bài toán này khó hơn phân loại nhiều, và công cụ quen thuộc nhất để học một phân phối, ước lượng hợp lý cực đại, không áp dụng trực tiếp được. Hiểu vì sao sẽ giải thích được thiết kế của cả ba họ mô hình ở các chương sau.
8.1Bài toán sinh#
Một ảnh màu có giá trị, mỗi giá trị nhận một trong 256 mức. Số ảnh có thể có là , một số lớn không tưởng tượng được. Trong không gian đó, những ảnh trông giống ảnh thật chiếm một phần cực nhỏ: chọn ngẫu nhiên một điểm thì gần như chắc chắn được nhiễu. Người ta thường mô tả tập các ảnh thật như một đa tạp dữ liệu (data manifold) có số chiều thấp hơn nhiều so với không gian chứa nó. Mô hình sinh phải học hình dạng của tập đó đủ tốt để lấy ra những điểm mới nằm trên nó.
8.2Hằng số chuẩn hoá#
Công cụ chuẩn để học một phân phối là ước lượng hợp lý cực đại (Chương 10 của Nền tảng): chọn tham số làm dữ liệu quan sát được có xác suất cao nhất. Nếu mô hình hoá mật độ bằng một hàm bất kỳ qua
thì log hợp lý chứa . là tích phân trên toàn bộ không gian 196 608 chiều: không tính được, khó xấp xỉ, và phụ thuộc nên không bỏ qua được khi lấy gradient.
Các họ mô hình sinh khác nhau ở cách tránh hằng số này. Mô hình tự hồi quy, như các mô hình ngôn ngữ, viết . Mỗi phân phối có điều kiện chỉ cần chuẩn hoá trên một tập nhỏ, ví dụ từ vựng, bằng softmax, nên hợp lý tính được chính xác; đổi lại, mô hình phải sinh từng phần tử một. VAE tối đa một chặn dưới của log hợp lý, và chặn dưới đó tính được (Chương 9). GAN bỏ hẳn hợp lý, thay bằng một trò chơi giữa hai mạng (Chương 10). Mô hình khuếch tán chia bài toán thành một chuỗi bài toán khử nhiễu, mỗi bài là một bài hồi quy (Chương 11).
8.3So sánh các họ mô hình sinh#
VAE, GAN và mô hình khuếch tán có chung một cách sinh mẫu: lấy nhiễu Gauss rồi biến đổi nó thành dữ liệu (Hình 11). Chúng khác nhau ở cách huấn luyện, và khác biệt đó kéo theo các tính chất trong bảng dưới.
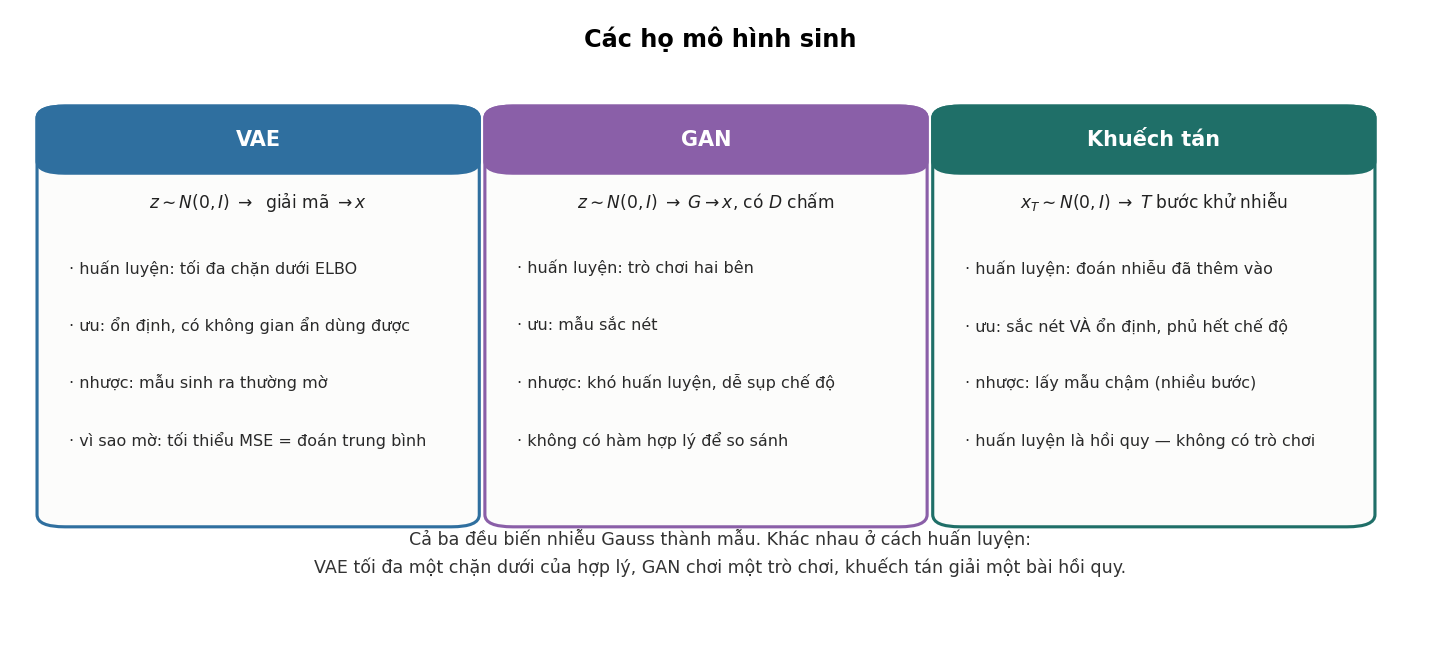
| VAE | GAN | Khuếch tán | |
|---|---|---|---|
| Huấn luyện bằng | tối đa chặn dưới ELBO | trò chơi giữa bộ sinh và bộ phân biệt | hồi quy dự đoán nhiễu |
| Độ ổn định khi huấn luyện | cao | thấp | cao |
| Độ sắc nét của mẫu | thường mờ | sắc nét | sắc nét |
| Phủ các chế độ của phân phối | tốt | dễ bỏ sót | tốt |
| Tốc độ lấy mẫu | một lượt chạy | một lượt chạy | nhiều bước |
| Có không gian ẩn dùng được | có | có một phần | không trực tiếp |
| Đánh giá được bằng hợp lý | có (chặn dưới) | không | có (chặn dưới) |
Bảng giải thích diễn biến của lĩnh vực. GAN chiếm ưu thế trong sinh ảnh khoảng 2015 tới 2020 vì cho mẫu sắc nét nhất. Mô hình khuếch tán thay thế GAN từ khoảng 2021 vì đạt độ sắc nét tương đương mà huấn luyện ổn định và phủ phân phối tốt hơn. Điểm yếu của nó là lấy mẫu chậm, nhưng lấy mẫu chậm cải thiện được bằng các kỹ thuật ở Mục 11.5, còn huấn luyện bất ổn thì khó khắc phục hơn nhiều.
8.4Tóm tắt#
Ảnh thật chỉ chiếm một phần cực nhỏ của không gian mọi ảnh có thể, và mô hình sinh phải học hình dạng của phần đó. Ước lượng hợp lý cực đại vấp phải hằng số chuẩn hoá , một tích phân trên toàn bộ không gian dữ liệu. Mô hình tự hồi quy tránh nó bằng cách chuẩn hoá từng bước trên một tập nhỏ, VAE tối đa một chặn dưới tính được, GAN bỏ hẳn hợp lý, còn mô hình khuếch tán chia bài toán thành nhiều bài hồi quy khử nhiễu. Mô hình khuếch tán thay thế GAN trong sinh ảnh vì đạt độ sắc nét tương đương mà huấn luyện ổn định hơn.
Ta đi qua ba họ theo thứ tự ra đời, bắt đầu từ VAE. Điểm xuất phát của VAE là bộ tự mã hoá, một mô hình nén dữ liệu tốt nhưng không sinh được mẫu mới.
9Bộ tự mã hoá biến phân#
Bộ tự mã hoá nén dữ liệu tốt nhưng không sinh được mẫu mới. Bộ tự mã hoá biến phân (variational autoencoder, VAE; Kingma và Welling, 2014) sửa điểm này bằng cách ép không gian ẩn có một phân phối biết trước. Ràng buộc đó xuất hiện trong hàm mục tiêu dưới dạng một số hạng KL, và hệ số đứng trước số hạng này làm nhiều việc hơn cách nó thường được mô tả: như thí nghiệm ở Mục 9.3 cho thấy, nó quyết định mô hình dùng bao nhiêu chiều ẩn.
9.1Bộ tự mã hoá và hạn chế khi sinh mẫu#
Bộ tự mã hoá (autoencoder) gồm bộ mã hoá nén thành một vector ẩn ngắn hơn, và bộ giải mã dựng lại từ , huấn luyện để gần :
Với bộ mã hoá và giải mã tuyến tính, nghiệm tối ưu chính là PCA (Chương 14 của Nền tảng). Để sinh mẫu mới, cần lấy một ngẫu nhiên rồi giải mã. Nhưng lấy từ phân phối nào? Bộ tự mã hoá không ràng buộc hình dạng của tập các mà nó dùng: chúng có thể tụ thành những cụm rời rạc hoặc nằm trên một đường cong mảnh. Một điểm chọn ngẫu nhiên trong không gian ẩn nhiều khả năng rơi vào vùng bộ giải mã chưa từng thấy, và cho ra kết quả vô nghĩa. Vấn đề không phải nén kém mà là không gian ẩn không có cấu trúc để lấy mẫu.
9.2VAE và chặn dưới ELBO#
VAE xem là biến ẩn ngẫu nhiên với tiên nghiệm cố định và bộ giải mã . Hợp lý của dữ liệu không tính được, nên VAE dùng thêm bộ mã hoá để xấp xỉ hậu nghiệm .
Mệnh đề 9.1 (Chặn dưới của bằng chứng)
Với mọi phân phối ,
và vì KL không âm, .
Chứng minh
Theo định lý Bayes, với mọi . Cộng và trừ rồi lấy kỳ vọng theo (vế trái không phụ thuộc ):
trong đó hai kỳ vọng cuối chính là hai phân kỳ KL.
VAE tối đa ELBO theo cả và . Thêm hệ số cho số hạng KL (Higgins và cộng sự, 2017) được hàm mục tiêu
với là VAE gốc.
Hai số hạng có ý nghĩa rõ ràng. Số hạng tái dựng yêu cầu giải mã từ phải dựng lại được ; với bộ giải mã Gauss, đó là bình phương sai số tái dựng với dấu trừ, cộng hằng số. Số hạng KL yêu cầu phân phối của ứng với mỗi gần . Nếu mọi đều gần tiên nghiệm, lấy mẫu sẽ rơi vào vùng bộ giải mã đã quen, và việc sinh mẫu trở nên hợp lệ. Với hai phân phối Gauss, số hạng KL có dạng đóng: mỗi chiều đóng góp , bằng 0 khi và chỉ khi , . Chẳng hạn một chiều có và đóng góp nat: hậu nghiệm của nó lệch khỏi gốc một đơn vị và hẹp hơn tiên nghiệm, và đó là chi phí phải trả để chiều này mang thông tin về . Hai số hạng kéo theo hai hướng ngược nhau, và điều chỉnh sự cân bằng giữa chúng.
Lưu ý (Tái tham số hoá)
Lấy mẫu là phép ngẫu nhiên, và gradient không truyền qua phép lấy mẫu được. Cách giải quyết là viết với : phần ngẫu nhiên nằm ở , không phụ thuộc tham số, nên gradient truyền qua và như bình thường. Đây là kỹ thuật cài đặt để huấn luyện VAE bằng gradient descent, không phải ý tưởng chính của VAE.
9.3Hệ số β và số chiều ẩn còn mang thông tin#
Lời giải thích thường gặp là " cân bằng giữa tái dựng và regularization". Thí nghiệm sau cho một mô tả cụ thể hơn. Dữ liệu gồm 600 điểm trong , sinh từ đúng 2 yếu tố ẩn Gauss qua một phép biến đổi tuyến tính, cộng nhiễu nhỏ. VAE được cho 6 chiều ẩn, nhiều hơn cần thiết, để xem nó làm gì với các chiều thừa. Bộ mã hoá và giải mã đều tuyến tính, nên VAE ở đây có liên hệ trực tiếp với PCA xác suất (Tipping và Bishop, 1999) và mọi hiện tượng đều giải thích được bằng công thức.
Một chiều ẩn được xem là còn mang thông tin nếu KL của riêng chiều đó, lấy trung bình trên dữ liệu, lớn hơn 0,01 nat: hậu nghiệm còn khác tiên nghiệm . Chiều có KL bằng 0 có hậu nghiệm trùng tiên nghiệm với mọi , tức không mang thông tin gì về .
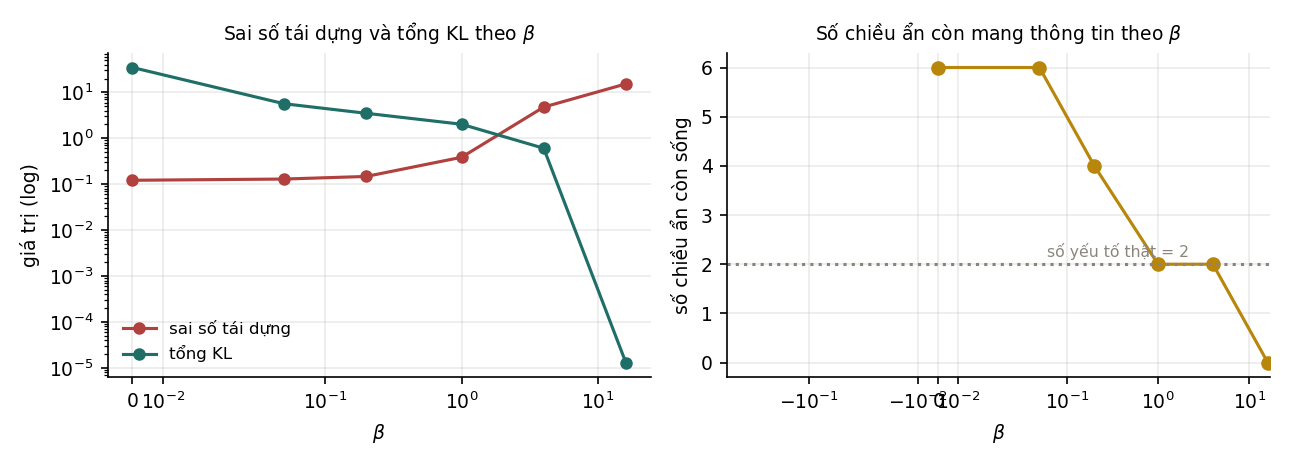
| Sai số tái dựng | Tổng KL | Số chiều mang thông tin | KL của từng chiều | |
|---|---|---|---|---|
| 0 | 0,1219 | 34,79 | 6 | 14,66 · 15,03 · 0,27 · 2,70 · 0,41 · 1,72 |
| 0,05 | 0,1296 | 5,66 | 6 | 2,57 · 2,60 · 0,09 · 0,16 · 0,10 · 0,13 |
| 0,2 | 0,1476 | 3,50 | 4 | 1,73 · 1,74 · 0,006 · 0,017 · 0,006 · 0,011 |
| 1 | 0,3861 | 2,02 | 2 | 1,015 · 1,006 · 0 · 0 · 0 · 0 |
| 4 | 4,78 | 0,61 | 2 | 0,36 · 0,007 · 0 · 0,24 · 0 · 0 |
| 16 | 15,28 | 0 | 0 | 0 · 0 · 0 · 0 · 0 · 0 |
Ba hàng , và cho thấy rõ cơ chế. Ở , cả 6 chiều đều mang thông tin. Không có ràng buộc nào kéo hậu nghiệm về tiên nghiệm, nên mô hình dùng mọi chiều được cho. Đây là bộ tự mã hoá thường ở Mục 9.1: tái dựng tốt nhất (0,1219) nhưng không gian ẩn không có cấu trúc để lấy mẫu.
Ở , đúng 2 chiều mang thông tin, bằng số yếu tố thật sinh ra dữ liệu, còn bốn chiều thừa có KL bằng 0. Số hạng KL đã hoạt động như một cơ chế tự chọn số chiều: mỗi chiều mang thông tin phải trả một "chi phí" KL, và chỉ những chiều giảm sai số tái dựng nhiều hơn chi phí đó mới được giữ lại.
Ở , không chiều nào mang thông tin. Đây là hiện tượng sụp hậu nghiệm (posterior collapse): không còn liên quan tới , và bộ giải mã chỉ dự đoán được giá trị trung bình của dữ liệu. Sai số tái dựng tăng lên 15,28, gấp khoảng 125 lần so với . Sụp hậu nghiệm cũng gặp khi bộ giải mã quá mạnh, ví dụ một mô hình tự hồi quy, vì khi đó bộ giải mã tự mô hình hoá được dữ liệu mà không cần (Bowman và cộng sự, 2016).
9.4Nguyên nhân mẫu của VAE bị mờ#
Với bộ giải mã Gauss, số hạng tái dựng là bình phương sai số (Mục 10.2 của Nền tảng), và hàm cực tiểu hoá kỳ vọng bình phương sai số là kỳ vọng có điều kiện:
Với ảnh, nếu cùng một ứng với nhiều ảnh thật khả dĩ, ví dụ cùng một khuôn mặt nhưng đường viền tóc lệch nhau vài điểm ảnh, thì trung bình của chúng là một ảnh nhoè ở các đường viền. Trung bình của nhiều ảnh sắc nét lệch nhau không phải một ảnh sắc nét. Lấy hai "ảnh" một chiều bốn điểm ảnh, và , cùng ứng với một với xác suất như nhau: cùng một cạnh, lệch nhau một điểm ảnh. Dự đoán tối ưu theo bình phương sai số là trung bình của chúng, , có một điểm ảnh xám không xuất hiện trong ảnh thật nào. Sai số kỳ vọng của nó là , trong khi dự đoán bằng một trong hai ảnh sắc nét có sai số kỳ vọng . Hàm mất mát bình phương vì vậy thưởng cho ảnh mờ. Độ mờ vì vậy không chủ yếu do mô hình thiếu dung lượng hay huấn luyện chưa đủ; nó đến từ việc chọn hàm mất mát bình phương, tức giả định nhiễu Gauss độc lập trên từng điểm ảnh. Đổi hàm mất mát thì đổi hiện tượng, và đó là điều GAN làm: thay hàm mất mát viết sẵn bằng một hàm mất mát học được.
9.5Tóm tắt#
Bộ tự mã hoá không sinh được mẫu vì không gian ẩn của nó không có cấu trúc để lấy mẫu. VAE xem là biến ẩn có tiên nghiệm và tối đa ELBO, một chặn dưới của log hợp lý gồm số hạng tái dựng và số hạng KL kéo hậu nghiệm về tiên nghiệm; mẹo tái tham số hoá cho phép huấn luyện bằng gradient descent. Thí nghiệm với dữ liệu sinh từ 2 yếu tố cho thấy quyết định số chiều ẩn còn mang thông tin: 6 chiều ở , đúng 2 chiều ở , và không chiều nào ở , khi hậu nghiệm sụp. Mẫu của VAE mờ vì hàm mất mát bình phương có nghiệm tối ưu là trung bình có điều kiện của nhiều ảnh sắc nét.
Nếu độ mờ đến từ một hàm mất mát viết sẵn, hướng sửa tự nhiên là để mô hình tự học hàm mất mát. Chương 10 trình bày GAN, mô hình làm đúng điều đó bằng một mạng thứ hai.
10Mạng đối sinh#
Chương 9 kết thúc ở chỗ độ mờ của VAE đến từ hàm mất mát bình phương viết sẵn. Mạng đối sinh (generative adversarial network, GAN; Goodfellow và cộng sự, 2014) không viết ra hàm đo mức giống thật mà học nó bằng một mạng thứ hai. Cách làm này cho mẫu sắc nét, nhưng biến việc huấn luyện thành một trò chơi giữa hai mạng, và trò chơi đó khó điều khiển hơn nhiều so với cực tiểu một hàm mất mát.
10.1Trò chơi giữa bộ sinh và bộ phân biệt#
GAN gồm hai mạng có mục tiêu ngược nhau: một bộ sinh biến nhiễu thành mẫu , và một bộ phân biệt nhận một mẫu rồi cho xác suất mẫu đó là thật. được huấn luyện để phân biệt mẫu thật với mẫu sinh ra, còn được huấn luyện để nhầm. Bài toán viết là
Bộ sinh không bao giờ nhìn thấy dữ liệu thật; nó chỉ nhận gradient qua bộ phân biệt. Mọi thông tin về "thế nào là thật" đi qua một kênh duy nhất là đánh giá của .
Mệnh đề 10.1 (Goodfellow và cộng sự, 2014)
Với cố định sinh ra phân phối , bộ phân biệt tối ưu là
và khi đó , với JS là phân kỳ Jensen–Shannon.
Chứng minh
Viết . Với mỗi , hàm đạt cực đại tại , cho . Thay vào và dùng định nghĩa với được biểu thức cần chứng minh.
Công thức của đọc được trực tiếp: tại một điểm mà mật độ dữ liệu là 0,3 còn mật độ của bộ sinh là 0,1, bộ phân biệt tối ưu trả lời ; ở nơi hai mật độ bằng nhau, nó trả lời 0,5, tức không phân biệt được. Như vậy, nếu bộ phân biệt luôn tối ưu, bộ sinh đang cực tiểu phân kỳ Jensen–Shannon giữa phân phối của nó và phân phối dữ liệu, đạt cực tiểu khi .
10.2Gradient của hàm mất mát gốc và bản không bão hoà#
Phân tích ở Mục 10.1 giả định bộ phân biệt luôn tối ưu. Khi huấn luyện thật, hai mạng cùng học dần từ đầu, và cách viết hàm mất mát cho bộ sinh quyết định nó có học được hay không. Thí nghiệm dùng dữ liệu hai chiều gồm 8 cụm Gauss đặt đều trên một đường tròn bán kính 2,4, mỗi cụm có độ lệch chuẩn 0,13. Bộ sinh và bộ phân biệt đều là MLP một lớp ẩn, huấn luyện 4 000 vòng, với hai hàm mất mát khác nhau cho bộ sinh, mỗi hàm 4 lần khởi tạo. Một cụm được tính là "được phủ" nếu có ít nhất một điểm sinh ra cách tâm cụm dưới 0,55; cột cuối là tỉ lệ điểm sinh ra nằm trong phạm vi đó của một cụm nào đó.
| Hàm mất mát của bộ sinh | Số cụm được phủ (4 lần khởi tạo) | Tỉ lệ điểm nằm trong cụm |
|---|---|---|
| Cực tiểu , dạng gốc | 0, 0, 0, 0 | 0,0% |
| Cực đại , dạng không bão hoà | 8, 8, 8, 8 | 15,3% |
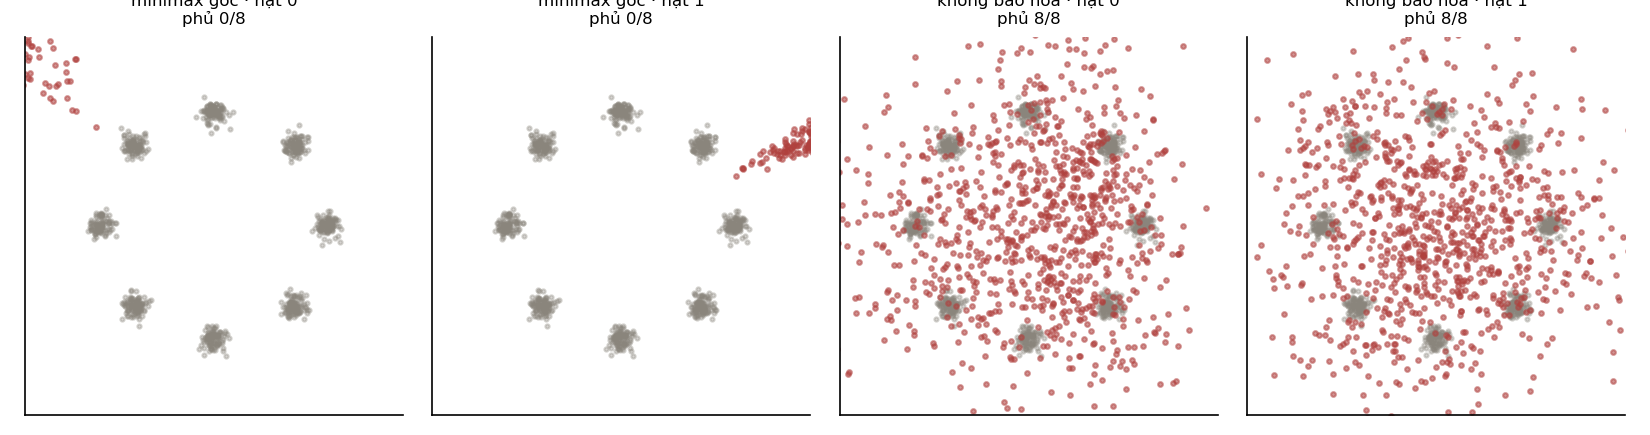
Dạng gốc thất bại hoàn toàn: bộ sinh không học được gì ở cả bốn lần. Nguyên nhân nằm ở đạo hàm. Viết với là đầu ra trước sigmoid của bộ phân biệt cho một mẫu sinh ra. Khi đó
Lúc bắt đầu huấn luyện, bộ sinh còn rất tệ nên bộ phân biệt dễ dàng nhận ra mẫu giả: . Gradient mà bộ sinh nhận được tỉ lệ với , nên cũng gần 0. Bộ sinh càng tệ càng nhận ít tín hiệu để sửa, và bị kẹt ngay từ đầu.
Bài báo GAN gốc đã nêu vấn đề này và đề xuất cách sửa: thay vì cực tiểu , cho bộ sinh cực đại . Hai hàm có cùng điểm cố định trong trò chơi nhưng đạo hàm khác hẳn:
lớn nhất đúng khi bộ sinh đang tệ nhất, . Với một mẫu giả mà bộ phân biệt cho xác suất là thật , dạng gốc cho đạo hàm theo bằng , còn dạng không bão hoà cho , lớn gấp 99 lần.
Ví dụ này cho thấy hai hàm mất mát có cùng điểm tối ưu vẫn có thể cho quá trình huấn luyện rất khác nhau, vì thứ quyết định việc học là gradient tại các điểm mà quá trình tối ưu thực sự đi qua, không phải vị trí của điểm tối ưu. Ý này đã xuất hiện khi so sánh hàm mất mát của perceptron, hinge và logistic ở Chương 6 của Nền tảng.
10.3Độ phủ các chế độ#
Sụp chế độ (mode collapse) là hiện tượng bộ sinh chỉ sinh ra một phần của phân phối: nó tìm được vài vùng làm bộ phân biệt nhầm rồi tập trung vào đó, bỏ qua các chế độ khác. Đây là hiện tượng có thật và thường gặp với dữ liệu nhiều chiều (Arjovsky, Chintala và Bottou, 2017).
Thí nghiệm này không tái hiện được sụp chế độ: với hàm mất mát không bão hoà, cả bốn lần khởi tạo đều phủ đủ 8 cụm, và các thay đổi như làm bộ phân biệt yếu đi hay giảm kích thước lô cũng không làm thay đổi kết quả đó. Vì vậy thí nghiệm không được dùng làm minh hoạ cho sụp chế độ; một ví dụ hai chiều đơn giản không đủ để hiện tượng này xuất hiện. Bài tập 10 đề xuất các thay đổi có thể làm nó xuất hiện.
Thí nghiệm lại cho thấy một vấn đề khác về chất lượng: chỉ 15,3% số điểm sinh ra nằm trong phạm vi một cụm. Phần lớn điểm nằm rải rác giữa các cụm. Bộ sinh phủ đúng vị trí các chế độ nhưng phân phối của nó không khớp với phân phối dữ liệu. Phủ đủ các chế độ vì vậy chưa có nghĩa là học đúng phân phối.
10.4Khó khăn khi huấn luyện GAN#
Ngoài vấn đề gradient ở Mục 10.2, GAN khó huấn luyện vì ba nguyên nhân mang tính cấu trúc. Nguyên nhân thứ nhất là không có hàm mục tiêu giảm đơn điệu. Khi huấn luyện mô hình thông thường, mất mát giảm là dấu hiệu tiến bộ. Với GAN, mất mát của bộ sinh tăng có thể vì bộ sinh kém đi, cũng có thể vì bộ phân biệt vừa tốt lên, nên đường cong mất mát không cho biết mô hình có đang tốt lên hay không.
Nguyên nhân thứ hai là bài toán tìm điểm cân bằng chứ không phải tìm cực tiểu. Nghiệm là một điểm yên ngựa của , tức cân bằng Nash của trò chơi hai người. Gradient descent xen kẽ cho hai bên không có bảo đảm hội tụ tới điểm yên ngựa, và có thể dao động quanh nó.
Nguyên nhân thứ ba là không có cách đánh giá dựa trên hợp lý. VAE và mô hình khuếch tán cho một chặn dưới của log hợp lý để so sánh các mô hình; GAN thì không. Các chỉ số như FID (Heusel và cộng sự, 2017) so sánh thống kê của đặc trưng trích từ một mạng phân loại ảnh, và có những điểm mù riêng.
Nhiều biến thể đã được đề xuất để giảm các khó khăn này, như Wasserstein GAN (Arjovsky, Chintala và Bottou, 2017) thay phân kỳ Jensen–Shannon bằng khoảng cách Wasserstein để gradient có ý nghĩa ngay cả khi hai phân phối không giao nhau. Nhưng ba nguyên nhân trên giải thích vì sao mô hình khuếch tán, vốn được huấn luyện bằng một bài hồi quy thông thường, thay thế GAN trong phần lớn ứng dụng sinh ảnh.
10.5Tóm tắt#
GAN học hàm đo mức giống thật bằng một bộ phân biệt. Khi bộ phân biệt tối ưu, bộ sinh cực tiểu phân kỳ Jensen–Shannon giữa phân phối của nó và phân phối dữ liệu. Dạng gốc của hàm mất mát cho bộ sinh có gradient tỉ lệ với , gần 0 đúng lúc bộ sinh còn tệ, nên trong thí nghiệm nó không phủ được cụm nào; dạng không bão hoà phủ đủ 8 cụm ở cả bốn lần khởi tạo. Thí nghiệm không tái hiện được sụp chế độ, nhưng cho thấy phủ đủ các chế độ chưa phải là học đúng phân phối: chỉ 15,3% số điểm sinh ra nằm trong một cụm. Việc không có hàm mục tiêu giảm đơn điệu, phải tìm điểm cân bằng thay vì cực tiểu, và không đánh giá được bằng hợp lý khiến GAN khó huấn luyện.
Một mô hình sinh lý tưởng sẽ cho mẫu sắc nét như GAN mà huấn luyện chỉ bằng cách cực tiểu một hàm mất mát thông thường. Mô hình khuếch tán ở Chương 11 đạt được điều đó bằng cách chia việc sinh thành nhiều bước khử nhiễu nhỏ.
11Mô hình khuếch tán#
Mô hình khuếch tán phá dần dữ liệu bằng nhiễu cho tới khi chỉ còn nhiễu, rồi học cách đảo ngược từng bước. Mỗi bước đảo ngược là một bài khử nhiễu nhỏ, và như ta sẽ thấy, huấn luyện cả mô hình quy về một bài hồi quy thông thường: không có trò chơi giữa hai mạng như GAN, và mất mát giảm nghĩa là mô hình tốt lên.
11.1Sinh mẫu bằng nhiều bước khử nhiễu#
Sinh một ảnh từ nhiễu trong một bước là bài toán rất khó. Nhưng khử một chút nhiễu khỏi một ảnh đã hơi nhiễu là bài toán khử nhiễu quen thuộc, tức một bài hồi quy. Mô hình khuếch tán (Sohl-Dickstein và cộng sự, 2015; Ho, Jain và Abbeel, 2020) ghép nhiều bước khử nhiễu nhỏ, thường 1 000 bước, thành một quá trình sinh. Cách tư duy này dùng được ở nhiều nơi: khi một phép biến đổi quá khó để học trực tiếp, tìm cách viết nó thành một chuỗi nhiều phép biến đổi dễ.
11.2Quá trình thuận và dạng đóng#
Quá trình thuận thêm nhiễu Gauss từng chút một:
với nhỏ, tăng dần theo một lịch định trước. Hệ số thu nhỏ tín hiệu một chút ở mỗi bước, vừa đủ để nếu có phương sai 1 thì cũng có phương sai 1.
Mệnh đề 11.1 (Dạng đóng của quá trình thuận)
Đặt và . Khi đó
tức với .
Chứng minh
Quy nạp theo . Với mệnh đề là định nghĩa. Giả sử . Khi đó . Tổng của hai biến Gauss độc lập có trung bình 0 là biến Gauss có phương sai bằng tổng các phương sai: .
Dạng đóng là điều làm cho huấn luyện khả thi: muốn có với bất kỳ, lấy trực tiếp từ trong một bước, không phải mô phỏng bước trung gian.
Dạng đóng kiểm chứng được bằng mô phỏng. Thí nghiệm dùng lịch tuyến tính từ tới qua 1 000 bước, giá trị ban đầu , mô phỏng 200 000 quỹ đạo đi từng bước rồi so trung bình và phương sai với dạng đóng. Chỉ số bước đánh từ 0 như trong mã, tức là sau bước nhiễu đầu tiên.
| Trung bình, mô phỏng | Trung bình, dạng đóng | Phương sai, mô phỏng | Phương sai, dạng đóng | |
|---|---|---|---|---|
| 1 | 1,99984 | 1,99978 | 0,00022 | 0,00022 |
| 10 | 1,99763 | 1,99781 | 0,00219 | 0,00219 |
| 100 | 1,89199 | 1,89224 | 0,10485 | 0,10486 |
| 400 | 0,88021 | 0,87994 | 0,80511 | 0,80643 |
| 999 | 0,00936 | 0,01271 | 1,00484 | 0,99996 |
Hai cách tính khớp nhau trong phạm vi sai số lấy mẫu của 200 000 quỹ đạo.
11.3Lịch nhiễu và tỉ số tín hiệu trên nhiễu#
cho biết phần tín hiệu còn lại sau bước. Đại lượng thường dùng hơn là tỉ số tín hiệu trên nhiễu
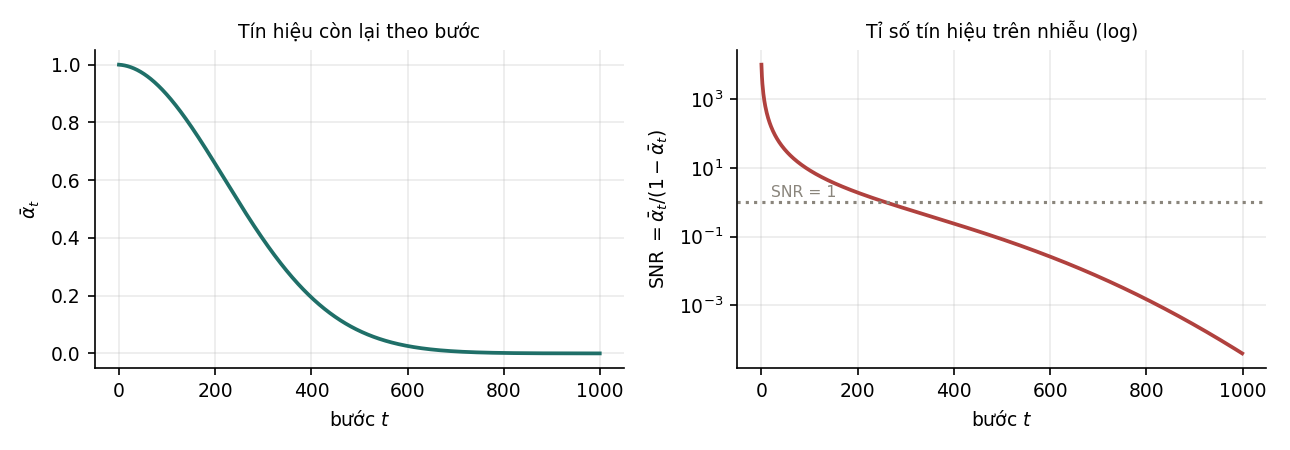
| SNR | Biên độ tín hiệu còn lại | ||
|---|---|---|---|
| 0 | 0,999900 | 9 999 | 99,99% |
| 50 | 0,969951 | 32,28 | 98,49% |
| 200 | 0,656347 | 1,91 | 81,02% |
| 500 | 0,077797 | 0,0844 | 27,89% |
| 800 | 0,001508 | 0,0015 | 3,88% |
| 999 | 0,64% |
Ở bước cuối chỉ còn 0,64% biên độ tín hiệu, tức gần như là nhiễu Gauss thuần tuý. Điều này cần thiết vì khi sinh mẫu, quá trình bắt đầu từ , và điểm xuất phát đó phải khớp với điểm kết thúc của quá trình thuận.
SNR cũng cho biết mô hình học gì ở mỗi bước. Ở nhỏ, SNR rất cao, ảnh gần như nguyên vẹn, và việc khử nhiễu liên quan tới các chi tiết nhỏ. Ở lớn, SNR rất thấp, gần như chỉ còn nhiễu, và việc khử nhiễu liên quan tới bố cục và màu sắc tổng thể. Khi sinh mẫu đi ngược từ về , mô hình vì vậy quyết định bố cục trước rồi mới thêm chi tiết. Nichol và Dhariwal (2021) chỉ ra lịch tuyến tính làm SNR giảm quá nhanh ở cuối, khiến nhiều bước cuối gần như lãng phí, và đề xuất lịch cosine.
11.4Huấn luyện bằng hồi quy#
Từ dạng đóng, . Mô hình khuếch tán huấn luyện một mạng để dự đoán lại nhiễu từ và :
Đây là bình phương sai số, một bài hồi quy thông thường như ở Chương 4 của Nền tảng. Không có trò chơi giữa hai mạng, không có điểm yên ngựa; mất mát giảm nghĩa là mô hình tốt lên. Thủ tục huấn luyện gồm bốn bước:
- Lấy một mẫu thật .
- Chọn ngẫu nhiên một bước .
- Lấy và tính bằng dạng đóng.
- Tính bình phương sai số giữa và , cập nhật tham số.
Hàm mất mát này là dạng đơn giản hoá của một chặn dưới biến phân cho log hợp lý, tương tự ELBO của VAE; Ho, Jain và Abbeel (2020) thấy bỏ các trọng số theo của chặn dưới cho chất lượng mẫu tốt hơn. Vì biết thì suy ra được từ dạng đóng, dự đoán và dự đoán tương đương về mặt toán học; dự đoán là một lựa chọn thực nghiệm. Chẳng hạn với ở bước 200 của lịch tuyến tính, và . Nếu nhiễu rút ra là thì , và đó là đầu vào của mạng, còn đáp án mạng phải đoán là 0,5. Biết đáp án đó thì . Khi sinh mẫu, mỗi bước dùng để ước lượng giá trị trung bình của , rồi cộng thêm một lượng nhiễu nhỏ.
11.5Tăng tốc lấy mẫu#
Nhược điểm chính của mô hình khuếch tán là lấy mẫu chậm: sinh một mẫu cần chạy mạng lần, và với là chậm hơn GAN khoảng một nghìn lần. Bảng dưới tóm tắt các cách khắc phục chính.
| Cách | Ý tưởng | Kết quả điển hình |
|---|---|---|
| DDIM (Song, Meng và Ermon, 2021) | quá trình ngược tất định, cho phép nhảy cách nhiều bước | từ 1 000 xuống vài chục bước |
| Lịch nhiễu tốt hơn | phân bố các bước theo SNR thay vì đều theo | ít bước hơn với cùng chất lượng |
| Chưng cất (Salimans và Ho, 2022) | huấn luyện một mô hình học gộp nhiều bước thành một | còn khoảng 4 tới 8 bước |
| Khuếch tán trong không gian ẩn (Rombach và cộng sự, 2022) | nén ảnh bằng một bộ tự mã hoá rồi chạy khuếch tán trong không gian ẩn nhỏ hơn | mỗi bước rẻ hơn nhiều |
Dòng cuối là cơ sở của nhiều mô hình sinh ảnh chạy được trên máy cá nhân, và là một ví dụ kết hợp hai họ mô hình: bộ tự mã hoá lo việc nén ảnh xuống không gian ẩn nhỏ, mô hình khuếch tán lo việc sinh trong không gian đó.
11.6Sinh có điều kiện#
Các ứng dụng như sinh ảnh từ mô tả văn bản cần mô hình với là điều kiện. Mạng nhận thêm , thường là embedding của câu mô tả do một bộ mã hoá văn bản tạo ra, đưa vào qua cross-attention (Mục 9.1 của Học sâu).
Kỹ thuật classifier-free guidance (Ho và Salimans, 2022) làm cho mẫu bám điều kiện chặt hơn: huấn luyện cùng một mạng với cả và với điều kiện rỗng (bỏ ngẫu nhiên khoảng 10% số lần), rồi khi sinh dùng
với đẩy mẫu theo hướng mà điều kiện tạo ra. Chẳng hạn nếu ở một toạ độ, dự đoán không điều kiện là 0,2 và dự đoán có điều kiện là 0,5, thì với ta dùng : không dừng ở dự đoán có điều kiện mà đi xa hơn theo cùng hướng. lớn cho mẫu khớp mô tả hơn nhưng kém đa dạng hơn. Chương 14 của Ứng dụng LLM bàn về việc dùng các mô hình sinh ảnh trong ứng dụng.
11.7Tóm tắt#
Quá trình thuận thêm nhiễu Gauss từng chút một, và nhờ dạng đóng , ta lấy được ở bước bất kỳ trong một phép tính; mô phỏng 200 000 quỹ đạo khớp với dạng đóng trong phạm vi sai số lấy mẫu. Với lịch tuyến tính, ở bước cuối chỉ còn 0,64% biên độ tín hiệu, nên quá trình sinh xuất phát được từ nhiễu Gauss thuần tuý. SNR giảm dần theo bước, nên khi sinh, mô hình quyết định bố cục trước rồi mới thêm chi tiết. Huấn luyện là hồi quy dự đoán nhiễu, ổn định như mọi bài hồi quy. Lấy mẫu chậm được khắc phục bằng DDIM, chưng cất và khuếch tán trong không gian ẩn, còn classifier-free guidance làm mẫu bám điều kiện chặt hơn.
Với ba họ mô hình sinh, ta đã biết cách tạo ra nội dung mới. Nhưng một mô hình ngôn ngữ sinh văn bản trôi chảy chưa chắc làm đúng điều người dùng muốn, như ví dụ câu hỏi về thủ đô của Pháp ở Chương 1. Phần cuối giáo trình bàn về việc điều chỉnh hành vi đó, và công cụ đầu tiên cần có là học tăng cường, cách học từ phần thưởng thay vì từ đáp án đúng (Chương 12).
12Nhập môn học tăng cường#
Ở Chương 1, mô hình vừa tiền huấn luyện được hỏi thủ đô của Pháp và có thể viết tiếp thành một đề kiểm tra thay vì trả lời. Muốn sửa hành vi đó bằng tín hiệu "câu trả lời này tốt hay tệ", cần một cách học từ phần thưởng thay vì từ đáp án đúng. Đó là học tăng cường (reinforcement learning). Ta chỉ xét những khái niệm tối thiểu cần cho RLHF ở Chương 14, kèm một thí nghiệm nhỏ về khám phá cho kết quả khác với cách giải thích thường gặp.
12.1Khác biệt với học có giám sát#
Trong học có giám sát, mỗi mẫu đi kèm đáp án đúng; mô hình dự đoán, so với đáp án, rồi điều chỉnh. Trong học tăng cường, không có đáp án, chỉ có phần thưởng: một con số cho biết việc vừa làm tốt hay tệ tới mức nào. Ba khác biệt đi kèm, và cả ba đều làm bài toán khó hơn:
| Học có giám sát | Học tăng cường | |
|---|---|---|
| Tín hiệu | đáp án đúng cho mỗi mẫu | một con số, không cho biết nên làm gì thay thế |
| Thời điểm | ngay sau mỗi dự đoán | có thể đến rất muộn sau hành động gây ra nó |
| Dữ liệu | cho sẵn, cố định | do chính chính sách đang học sinh ra |
Dòng cuối có tác động lớn nhất. Trong học tăng cường, hành động của tác tử quyết định nó sẽ thấy dữ liệu gì tiếp theo. Một chính sách kém chỉ thu thập được dữ liệu kém, rồi học từ dữ liệu đó lại ra chính sách kém. Đây là một vòng phản hồi, cùng bản chất với vòng phản hồi trong các hệ thống gợi ý (Mục 12.2 của MLOps).
12.2Các khái niệm cơ bản#
Một bài toán học tăng cường gồm một tác tử tương tác với môi trường. Tại mỗi thời điểm, môi trường ở một trạng thái , tác tử chọn một hành động và nhận về một phần thưởng , là một con số. Quy tắc chọn hành động gọi là chính sách , và có thể ngẫu nhiên. Để đánh giá một lựa chọn, ta dùng hàm giá trị hành động : tổng phần thưởng chiết khấu kỳ vọng nếu làm tại rồi tiếp tục theo . Hàm giá trị trạng thái là kỳ vọng của theo .
Tổng phần thưởng chiết khấu từ thời điểm là , với hệ số chiết khấu : gần 1 nghĩa là coi trọng phần thưởng xa, gần 0 nghĩa là chỉ quan tâm phần thưởng trước mắt. Một hành động có thể cho phần thưởng tức thời thấp mà vẫn là lựa chọn đúng, vì nó dẫn tới phần thưởng lớn về sau; hàm giá trị tồn tại để nắm được điều đó.
Hàm giá trị tối ưu thoả phương trình Bellman
trong đó kỳ vọng lấy theo phần thưởng và trạng thái kế tiếp sau khi làm tại . Giá trị của một hành động bằng phần thưởng nhận ngay cộng giá trị chiết khấu của hành động tốt nhất ở trạng thái kế tiếp.
Q-learning (Watkins và Dayan, 1992) biến phương trình này thành quy tắc cập nhật sau mỗi bước chuyển :
Đại lượng trong ngoặc là sai số thời gian (temporal difference error): chênh lệch giữa ước lượng mới dựa trên quan sát vừa có và ước lượng hiện tại. Q-learning là thuật toán ngoài chính sách (off-policy): nó học giá trị của chính sách tham lam theo , bất kể dữ liệu được thu thập bằng chính sách nào, miễn là mọi cặp trạng thái–hành động được thử đủ nhiều.
12.3Khám phá và khai thác#
Nếu luôn chọn hành động có cao nhất theo ước lượng hiện tại (khai thác), tác tử không bao giờ thử những hành động khác, và không bao giờ biết có lựa chọn tốt hơn. Nếu luôn chọn ngẫu nhiên (khám phá), nó biết nhiều nhưng không tận dụng được. Cách cân bằng thông dụng nhất là -tham lam: với xác suất chọn hành động ngẫu nhiên, còn lại chọn hành động có cao nhất. Thí nghiệm ở Mục 12.4 cho thấy đây không phải cơ chế khám phá duy nhất.
12.4Thí nghiệm khám phá trên lưới 7 × 7#
Môi trường là lưới : tác tử xuất phát ở góc dưới bên trái, đích ở góc trên bên phải (phần thưởng ), bốn ô bẫy (phần thưởng ), mỗi lượt kết thúc khi tới đích, rơi vào bẫy hoặc sau 80 bước. Q-learning chạy 6 000 lượt với , . Ba cấu hình chỉ khác nhau ở phần thưởng của mỗi bước đi thường và giá trị khởi tạo . Sau khi học, chính sách tham lam theo (không còn khám phá) được chạy để đo tỉ lệ tới đích.
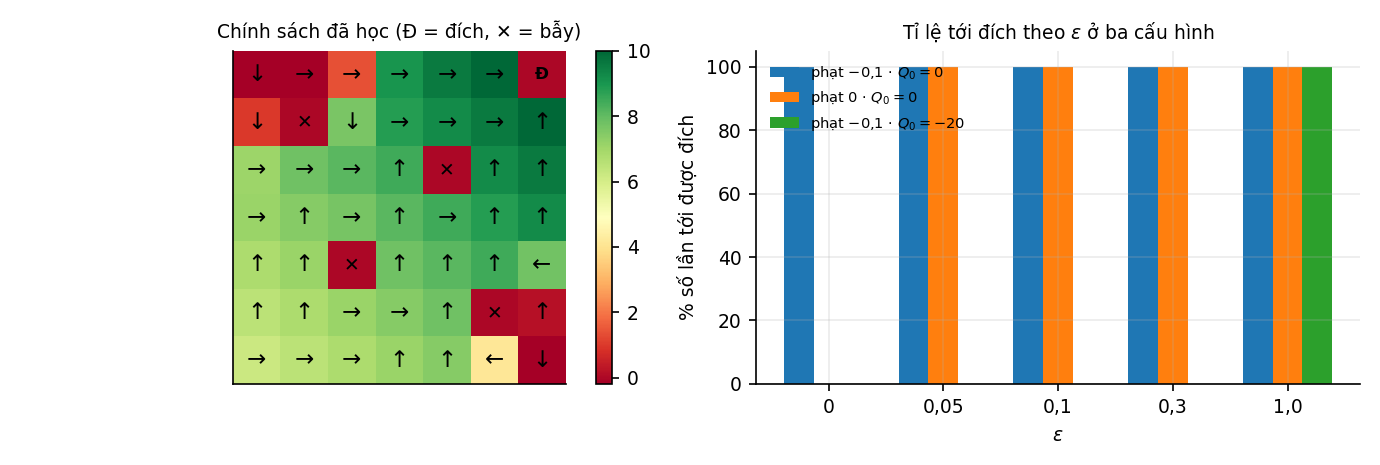
| Cấu hình | |||||
|---|---|---|---|---|---|
| 1. Phạt mỗi bước, | 100% | 100% | 100% | 100% | 100% |
| 2. Không phạt, | 0% | 100% | 100% | 100% | 100% |
| 3. Phạt mỗi bước, | 0% | 0% | 0% | 0% | 100% |
Cấu hình 1 thành công ngay cả với , tức không hề chọn ngẫu nhiên. Lời giải thích "cần để khám phá" không giải thích được kết quả này.
Lời giải thích nằm ở giá trị khởi tạo. Trong cấu hình 1, mọi phần thưởng của bước đi thường đều âm, trong khi khởi tạo bằng 0. Mỗi lần thử một hành động, của nó bị kéo xuống dưới 0, còn các hành động chưa thử vẫn ở 0. Một bước cập nhật cho thấy con số cụ thể: với , , một hành động được thử lần đầu ở trạng thái mà mọi còn bằng 0 có , thấp hơn 0 của ba hành động chưa thử. Chính sách tham lam vì vậy luôn ưu tiên hành động chưa thử, tức tự khám phá mà không cần yếu tố ngẫu nhiên. Cơ chế này gọi là khởi tạo lạc quan (optimistic initialization; Sutton và Barto, 2018): giá trị khởi tạo cao hơn giá trị thật làm mọi lựa chọn chưa thử trông hấp dẫn.
Cấu hình 2 mất tính lạc quan đó. Không phạt bước đi thì mọi bằng 0 cho tới khi tác tử tình cờ tới đích hoặc rơi vào bẫy. Với , hàm argmax luôn trả về cùng một hành động khi các giá trị bằng nhau, nên tác tử đi mãi một hướng và không bao giờ tới đích. Chỉ cần là đủ để tìm ra đích.
Cấu hình 3 khởi tạo bi quan: , thấp hơn mọi giá trị thật. Hành động đầu tiên được thử có tăng lên gần giá trị thật, trong khi các hành động khác vẫn ở , nên chính sách tham lam bám lấy hành động đã thử và gần như không khám phá. Cùng bước cập nhật như trên giờ cho , cao hơn của mọi hành động chưa thử. Với ngân sách 6 000 lượt, ngay cả cũng không đủ. Chỉ với , tức hành động hoàn toàn ngẫu nhiên, Q-learning mới học được chính sách tối ưu; điều này khả thi vì Q-learning là thuật toán ngoài chính sách.
Như vậy không phải nguồn khám phá duy nhất. Cách khởi tạo hàm giá trị cũng là một cơ chế khám phá, và trong cấu hình 1 nó thay thế hoàn toàn . Ngược lại, khởi tạo bi quan có thể làm nhỏ trở nên vô tác dụng.
12.5Tóm tắt#
Học tăng cường học từ phần thưởng, một con số không cho biết nên làm gì thay thế, có thể đến muộn, và phụ thuộc vào dữ liệu do chính chính sách đang học thu thập. Hàm giá trị nắm được phần thưởng về sau của một hành động; nó thoả phương trình Bellman, và Q-learning biến phương trình đó thành quy tắc cập nhật theo sai số thời gian. Thí nghiệm trên lưới cho thấy khởi tạo lạc quan đủ để tác tử tới đích 100% với , còn khởi tạo bi quan làm cả cũng thất bại.
Q-learning cần một bảng giá trị cho mọi cặp trạng thái–hành động. Với mô hình ngôn ngữ, trạng thái là toàn bộ văn bản đã sinh và hành động là chọn một trong hàng chục nghìn token, nên cách làm này không khả thi. Chương 13 chuyển sang tối ưu trực tiếp chính sách, mà với mô hình ngôn ngữ thì chính sách chính là mô hình đã có.
13Gradient chính sách#
Q-learning học hàm giá trị rồi suy ra chính sách. Với mô hình ngôn ngữ, cách tự nhiên hơn là điều chỉnh trực tiếp chính sách, vì chính sách chính là mô hình đã có. PPO, thuật toán dùng trong RLHF, thuộc họ phương pháp này. Để hiểu nó, ta đi từ định lý gradient chính sách, qua vấn đề phương sai của ước lượng gradient và cách đường nền giảm phương sai đó.
13.1Giới hạn của Q-learning với mô hình ngôn ngữ#
Q-learning cần một bảng hoặc một mô hình cho và cần tính ở mỗi bước. Với mô hình ngôn ngữ, hành động là chọn token tiếp theo trong từ vựng hàng chục nghìn token, và trạng thái là toàn bộ văn bản đã sinh, nên số trạng thái là vô hạn. Quan trọng hơn, mô hình ngôn ngữ đã là một chính sách . Gradient chính sách (policy gradient) tối ưu trực tiếp tham số của chính sách theo phần thưởng kỳ vọng, không cần học hàm giá trị trước.
13.2Định lý gradient chính sách#
Xét trường hợp một bước: chính sách chọn hành động , nhận phần thưởng . Mục tiêu là cực đại . Khó khăn là được lấy mẫu từ chính , nên không lấy đạo hàm bên trong kỳ vọng như thường được. Đồng nhất thức sau, gọi là thủ thuật log (log-derivative trick), giải quyết điều đó:
Định lý 13.1 (Gradient chính sách)
Chứng minh
, và tổng cuối chính là kỳ vọng theo .
Vế phải là một kỳ vọng, nên ước lượng được bằng cách lấy mẫu: rút hành động từ , tính trung bình của . Đây là thuật toán REINFORCE (Williams, 1992). Về mặt trực giác, REINFORCE lấy mẫu một hành động, xem phần thưởng, rồi tăng log xác suất của hành động đó theo tỉ lệ với phần thưởng. Với bài toán nhiều bước, được thay bằng tổng phần thưởng từ bước đó trở đi, và công thức giữ nguyên dạng (Sutton và cộng sự, 2000).
13.3Phương sai và đường nền#
Ước lượng của REINFORCE không chệch nhưng có phương sai lớn. Lý do thấy được từ công thức: nếu mọi phần thưởng đều dương, ví dụ nằm trong khoảng , thì mỗi mẫu đều đẩy log xác suất của hành động được chọn lên, kể cả hành động tệ. Việc học chỉ đến từ chênh lệch về độ mạnh của các lần đẩy, và chênh lệch đó bị nhiễu lấy mẫu che lấp.
Cách khắc phục là trừ một đường nền (baseline):
Phép trừ không làm thay đổi kỳ vọng, với mọi hằng số :
Tổng xác suất luôn bằng 1, nên đạo hàm của nó bằng 0. Với đường nền gần phần thưởng trung bình, hành động tốt hơn trung bình được đẩy lên, hành động kém hơn bị đẩy xuống, và phương sai giảm.
Hai hành động đủ để thấy điều này bằng số. Chính sách là softmax của , tức chọn mỗi hành động với xác suất 0,5, và phần thưởng là 1 cho hành động thứ nhất, 3 cho hành động thứ hai. Với softmax, , nên lấy được hành động thứ nhất cho và lấy được hành động thứ hai cho . Không có đường nền, ước lượng từ một mẫu là hoặc . Trung bình của chúng là , đúng hướng, nhưng mẫu thứ nhất chỉ sai hướng: nó đẩy hành động kém lên. Với đường nền , hai mẫu cho và , cả hai đều đúng bằng . Kỳ vọng giữ nguyên, còn phương sai trong ví dụ này giảm về 0.
13.4Thí nghiệm về tác dụng của đường nền#
Bài toán một bước có 6 hành động với phần thưởng trung bình , cộng nhiễu Gauss độ lệch chuẩn 0,25; hành động thứ năm tốt hơn hẳn, các hành động còn lại xấp xỉ nhau. Chính sách hiện tại là phân phối đều, tham số hoá bằng softmax. Với mỗi số mẫu , thí nghiệm lặp lại phép ước lượng gradient 400 lần và đo độ lệch chuẩn của ước lượng (trung bình trên 6 thành phần), không có và có đường nền. Đường nền là phần thưởng trung bình của chính mẫu đó.
| Số mẫu | Độ lệch chuẩn, không đường nền | Có đường nền | Tỉ số |
|---|---|---|---|
| 16 | 0,13674 | 0,05776 | 2,37 |
| 64 | 0,06745 | 0,02944 | 2,29 |
| 256 | 0,03376 | 0,01449 | 2,33 |
| 1 024 | 0,01632 | 0,00718 | 2,27 |
Đường nền giảm độ lệch chuẩn khoảng 2,3 lần ở mọi cỡ mẫu. Vì số mẫu cần để đạt một độ chính xác tỉ lệ với phương sai, tức bình phương độ lệch chuẩn, điều này tương đương cần ít mẫu hơn khoảng 5,3 lần.
Trung bình của ước lượng không đổi (với 4 096 mẫu, lấy trung bình 200 lần):
gradient TB khong nen : [-0.06274 -0.03002 -0.08005 -0.04598  0.27275 -0.05396]
gradient TB co nen    : [-0.06272 -0.02927 -0.07917 -0.04593  0.2716  -0.05451]
lech lon nhat: 1.15e-03
Hai vector trùng nhau trong phạm vi sai số lấy mẫu, và cả hai đều chỉ đúng hướng: chỉ thành phần của hành động thứ năm dương. Còn một chi tiết kỹ thuật: dùng trung bình của chính các mẫu trong lô làm đường nền tạo ra một độ chệch cỡ , vì đường nền phụ thuộc vào mẫu đang được dùng. Với lớn, độ chệch này không đáng kể, và có thể loại bỏ hoàn toàn bằng cách tính đường nền cho mỗi mẫu từ các mẫu còn lại.
13.5Hàm lợi thế và PPO#
Trong bài toán nhiều bước, đường nền tốt thường phụ thuộc trạng thái: . Khi đó đại lượng nhân với là
gọi là hàm lợi thế (advantage function): hành động này tốt hơn mức trung bình tại trạng thái này bao nhiêu. Các thuật toán actor–critic học đồng thời chính sách (actor) và một ước lượng của (critic) để tính lợi thế; GAE (Schulman và cộng sự, 2016) là cách ước lượng lợi thế thông dụng.
Thuật toán được dùng trong RLHF là PPO (proximal policy optimization; Schulman và cộng sự, 2017). Ngoài lợi thế, PPO giới hạn mức thay đổi của chính sách trong mỗi lần cập nhật: nó cắt tỉ số trong khoảng , thường với , để một bước cập nhật lớn không làm chính sách thay đổi quá nhiều dựa trên những ước lượng lợi thế nhiễu. Ý tưởng này tương tự lý do tốc độ học khi tinh chỉnh phải nhỏ (Mục 6.4).
13.6Tóm tắt#
Gradient chính sách tối ưu trực tiếp phần thưởng kỳ vọng theo tham số của chính sách. Nhờ thủ thuật log, gradient viết được thành một kỳ vọng, , và ước lượng được bằng lấy mẫu; đó là REINFORCE. Ước lượng này không chệch nhưng phương sai lớn. Trừ một đường nền không làm đổi kỳ vọng, vì tổng xác suất luôn bằng 1, và trong thí nghiệm giảm độ lệch chuẩn khoảng 2,3 lần, tương đương cần ít mẫu hơn khoảng 5,3 lần. Trong bài toán nhiều bước, đường nền tốt là , cho hàm lợi thế ; PPO dùng lợi thế và cắt tỉ số xác suất để mỗi lần cập nhật không đổi chính sách quá nhiều.
Học tăng cường cần một phần thưởng. Với một trợ lý ngôn ngữ, không có sẵn hàm nào chấm được một câu trả lời là tốt hay tệ. Chương 14 trình bày cách học hàm thưởng đó từ những so sánh của con người.
14Học tăng cường từ phản hồi của con người#
Sau tiền huấn luyện và tinh chỉnh có giám sát, mô hình ngôn ngữ làm theo chỉ dẫn nhưng chỉ tốt bằng các câu trả lời mẫu nó được học. RLHF (reinforcement learning from human feedback) cải thiện tiếp bằng dữ liệu so sánh giữa các câu trả lời. Cách làm này dựa trên một quan sát đơn giản về con người: chọn câu trả lời tốt hơn trong hai câu dễ hơn nhiều so với tự viết ra câu trả lời tốt nhất. Từ dữ liệu so sánh, ta học một hàm thưởng, rồi dùng học tăng cường ở Chương 12 và 13 để tối ưu mô hình theo hàm thưởng đó.
14.1Các giai đoạn huấn luyện một trợ lý#
Quy trình phổ biến, theo InstructGPT (Ouyang và cộng sự, 2022), gồm ba giai đoạn (Hình 14). Giai đoạn đầu là tiền huấn luyện trên hàng nghìn tỉ token không nhãn bằng cách dự đoán token tiếp theo (Chương 5). Giai đoạn thứ hai là tinh chỉnh có giám sát (supervised fine-tuning, SFT) trên hàng chục nghìn cặp (yêu cầu, câu trả lời tốt) do người viết; sau bước này, mô hình trả lời câu hỏi thay vì viết tiếp văn bản. Giai đoạn thứ ba học từ so sánh và gồm hai bước, ký hiệu 3a và 3b trên hình. Ở bước 3a, người đánh giá chọn câu trả lời tốt hơn trong các cặp câu trả lời của mô hình, và dữ liệu đó được dùng để huấn luyện một mô hình thưởng. Ở bước 3b, mô hình ngôn ngữ được tối ưu theo mô hình thưởng bằng học tăng cường, thường là PPO.
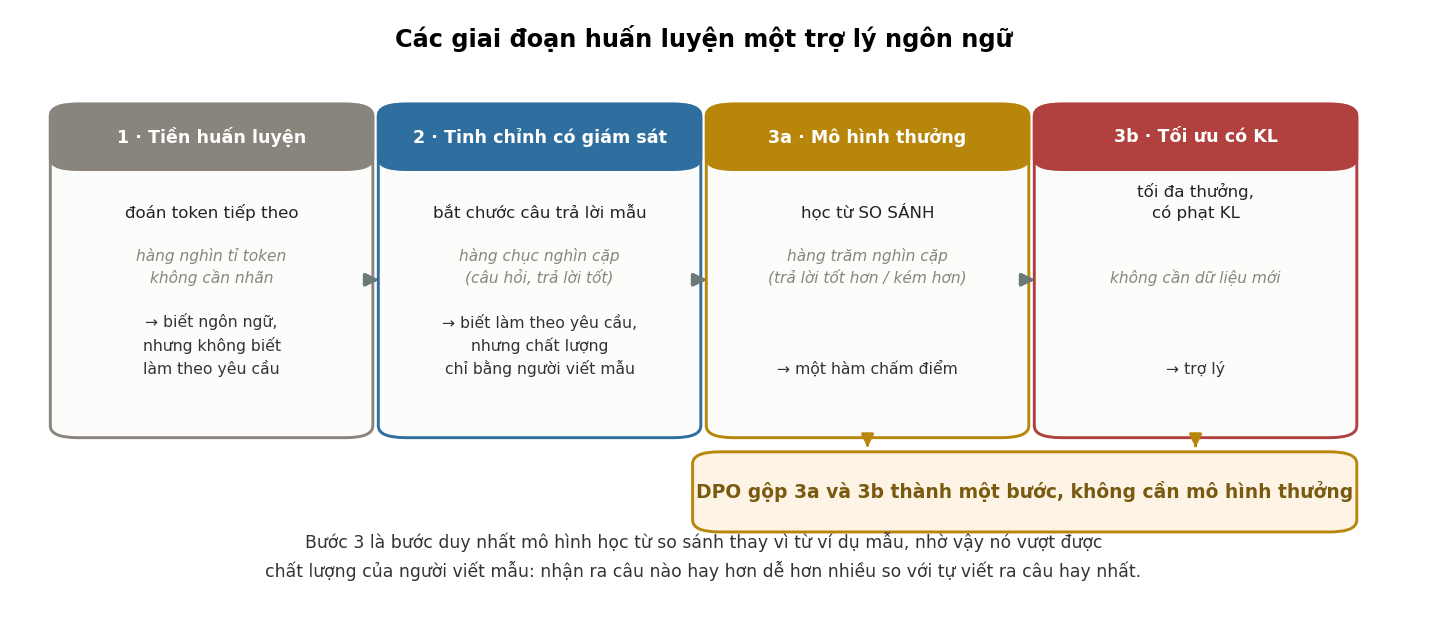
Giai đoạn thứ hai có một giới hạn: học bắt chước chỉ đưa mô hình tới chất lượng của các câu trả lời mẫu. Giai đoạn thứ ba được thiết kế để vượt giới hạn đó.
14.2Học từ so sánh#
Lý do chính là một sự bất đối xứng: đánh giá dễ hơn tạo ra. Nhiều người không viết được một bài thơ hay, nhưng chỉ ra được bài nào hay hơn trong hai bài. Viết một đoạn mã tối ưu thì khó, nhưng so sánh hai đoạn mã và nói đoạn nào rõ ràng hơn thì dễ hơn nhiều. Thu thập so sánh thay cho câu trả lời mẫu vì vậy cho tín hiệu về chất lượng cao hơn mức người gán nhãn tự viết ra được.
Lý do thứ hai mang tính thực tế: so sánh nhất quán giữa những người gán nhãn hơn chấm điểm tuyệt đối. Hỏi mười người "câu trả lời này bao nhiêu điểm trên thang 10" thường cho những con số rất khác nhau, vì mỗi người dùng thang đo theo cách riêng; hỏi "câu nào tốt hơn" cho mức đồng thuận cao hơn.
Christiano và cộng sự (2017) dùng học từ so sánh để huấn luyện tác tử trong các môi trường mô phỏng; Stiennon và cộng sự (2020) và Ouyang và cộng sự (2022) áp dụng cho mô hình ngôn ngữ. Trong InstructGPT, người đánh giá ưa thích câu trả lời của mô hình 1,3 tỉ tham số đã qua RLHF hơn câu trả lời của GPT-3 175 tỉ tham số chưa qua RLHF.
14.3Mô hình thưởng Bradley–Terry#
Từ dữ liệu so sánh, cần một hàm cho điểm câu trả lời của câu hỏi . Mô hình Bradley–Terry (Bradley và Terry, 1952) giả định xác suất người đánh giá chọn hơn là
Đây là hồi quy logistic trên hiệu của hai điểm thưởng (Mục 6.3 của Nền tảng), và mô hình thưởng được huấn luyện bằng hợp lý cực đại, tức cực tiểu trên các cặp. Trong thực tế, là một mô hình ngôn ngữ đã tinh chỉnh, thay lớp chiếu ra từ vựng bằng một đầu ra vô hướng.
Chẳng hạn nếu mô hình thưởng cho câu được chọn 1,5 điểm và câu bị loại 0,5 điểm, xác suất mô hình gán cho lựa chọn của người đánh giá là , và mất mát của cặp này là . Cần lưu ý rằng chỉ xác định được sai khác một hằng số cộng cho mỗi câu hỏi. Cộng cùng một hằng số vào điểm của mọi câu trả lời cho cùng một câu hỏi không thay đổi hiệu, nên không thay đổi hợp lý: 11,5 và 10,5 điểm cho đúng xác suất 0,731. Điều này vô hại vì bước sau chỉ dùng qua hàm mũ rồi chuẩn hoá (Mục 14.4), nên hằng số bị hằng số chuẩn hoá hấp thụ.
14.4Tối ưu có ràng buộc KL và nghiệm dạng đóng#
Có mô hình thưởng rồi, cần tìm chính sách cho phần thưởng cao. Nhưng nếu chỉ cực đại phần thưởng, mô hình sẽ khai thác mọi điểm yếu của mô hình thưởng, vốn chỉ là một xấp xỉ học từ dữ liệu hữu hạn; hiện tượng này gọi là lách phần thưởng (reward hacking; Gao, Schulman và Hilton, 2023). Cách hạn chế là phạt độ lệch khỏi chính sách tham chiếu , thường là mô hình sau bước SFT:
Mệnh đề 14.1
Nghiệm của bài toán trên là
Chứng minh
Với cố định, viết mục tiêu dưới dạng tổng trên các câu trả lời và thêm nhân tử Lagrange cho ràng buộc (Chương 12 của Nền tảng):
Đạo hàm theo bằng 0: , suy ra . Chuẩn hoá để tổng bằng 1 được . Hàm mục tiêu lõm theo nên điểm dừng này là cực đại.
Nghiệm có ý nghĩa rõ ràng: chính sách tối ưu là chính sách tham chiếu, đánh trọng số lại theo hàm mũ của phần thưởng. Câu trả lời có phần thưởng cao được tăng xác suất, phần thưởng thấp bị giảm. Nếu thì bất kể lớn tới đâu. điều chỉnh mức đánh trọng số lại: dồn toàn bộ xác suất vào câu trả lời có phần thưởng cao nhất, giữ nguyên . Với hai câu trả lời có và phần thưởng , công thức cho : xác suất của câu tốt hơn là 0,881 với , 0,731 với và chỉ 0,55 với .
Nghiệm dạng đóng kiểm chứng được bằng số. Trên một không gian nhỏ gồm 8 câu trả lời, bài toán được giải theo hai cách độc lập: thay vào công thức dạng đóng, và tối ưu trực tiếp bằng BFGS trên đơn hình xác suất mà không dùng công thức.
| Chênh lệch giữa hai cách | Phần thưởng kỳ vọng đạt được | ||
|---|---|---|---|
| 0,05 | 4,741 | 2,438 | |
| 0,20 | 4,658 | 2,424 | |
| 1,00 | 0,417 | 0,303 | |
| 5,00 | 0,017 |
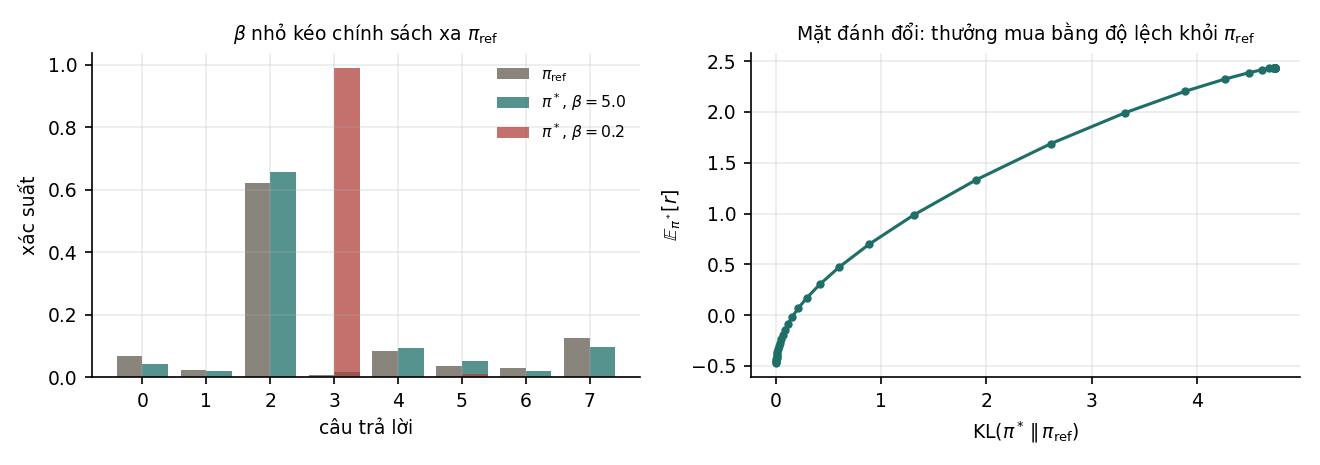
Hình bên phải cho cách hiểu phù hợp về : nó không có một giá trị "đúng" cần tìm, mà chọn một điểm trên đường đánh đổi. Muốn phần thưởng theo mô hình thưởng cao hơn thì phải chấp nhận đi xa hơn, và đi xa hơn thì nguy cơ lách phần thưởng cao hơn. Trong thực tế, được chọn bằng cách theo dõi chất lượng theo đánh giá của người hoặc của một mô hình thưởng độc lập khi KL tăng.
14.5Hạn chế của quy trình RLHF#
Quy trình RLHF với PPO cần huấn luyện một mô hình thưởng riêng, rồi giữ bốn mô hình trong bộ nhớ cùng lúc khi tối ưu: chính sách đang học, chính sách tham chiếu để tính KL, mô hình thưởng, và mô hình giá trị (critic) của PPO. Quy trình tốn bộ nhớ và nhạy với siêu tham số, vì kế thừa các khó khăn của học tăng cường ở Chương 12 và 13. Câu hỏi tự nhiên là có thể bỏ bớt thành phần nào mà vẫn tối ưu cùng một mục tiêu không.
14.6Tóm tắt#
Tinh chỉnh có giám sát chỉ đưa mô hình tới chất lượng của câu trả lời mẫu. RLHF vượt giới hạn đó bằng dữ liệu so sánh, vì đánh giá dễ hơn tạo ra và so sánh nhất quán giữa người gán nhãn hơn chấm điểm tuyệt đối. Mô hình thưởng Bradley–Terry là hồi quy logistic trên hiệu hai điểm thưởng. Tối ưu phần thưởng có phạt KL với hệ số có nghiệm dạng đóng: chính sách tham chiếu đánh trọng số lại theo , và trên không gian 8 câu trả lời, nghiệm này khớp với nghiệm tìm bằng BFGS với chênh lệch không quá . chọn một điểm trên đường đánh đổi giữa phần thưởng và độ lệch khỏi chính sách tham chiếu. Quy trình với PPO giữ bốn mô hình trong bộ nhớ và nhạy với siêu tham số.
Nghiệm dạng đóng ở Mục 14.4 còn dùng được theo chiều ngược lại: biết chính sách thì suy ra được hàm thưởng. Chương 15 khai thác điều đó để bỏ cả mô hình thưởng lẫn học tăng cường mà vẫn tối ưu cùng một mục tiêu.
15Tối ưu trực tiếp theo sở thích (DPO)#
DPO (direct preference optimization; Rafailov và cộng sự, 2023) dựa trên một quan sát: nghiệm dạng đóng ở Mục 14.4 có thể đảo ngược để biểu diễn phần thưởng qua chính sách, và khi thay vào mô hình Bradley–Terry, hằng số chuẩn hoá không tính được tự triệt tiêu. Kết quả là một hàm mất mát tính trực tiếp từ dữ liệu so sánh, không cần mô hình thưởng và không cần học tăng cường. Vì DPO và RLHF tối ưu cùng một mục tiêu, câu hỏi thực tế không phải phương pháp nào đúng hơn mà là mỗi cách đánh đổi những gì.
15.1Hàm thưởng ẩn trong chính sách#
Từ nghiệm ở Mục 14.4, . Lấy logarit rồi giải theo :
Đẳng thức cho thấy mọi chính sách đều ngầm xác định một hàm thưởng mà nó là nghiệm tối ưu: không cần huấn luyện một mô hình thưởng riêng, vì chính sách đã chứa thông tin đó ở dạng khác.
15.2Hằng số chuẩn hoá triệt tiêu#
Số hạng không tính được, vì là tổng trên mọi câu trả lời có thể. Nhưng mô hình Bradley–Terry chỉ dùng hiệu phần thưởng của hai câu trả lời cho cùng một câu hỏi:
phụ thuộc nhưng không phụ thuộc , nên triệt tiêu khi lấy hiệu. Thay vào hàm mất mát của mô hình thưởng ở Mục 14.3 được hàm mất mát DPO, tối ưu trực tiếp trên tham số của chính sách:
Hàm mất mát có dạng cross-entropy nhị phân (Chương 6 của Nền tảng); mỗi số hạng log xác suất tính được bằng một lượt xuôi qua mô hình. Với một cặp mà gán 0,5 cho mỗi câu và : lúc bắt đầu, nên hiệu phần thưởng ẩn bằng 0 và mất mát là . Khi chính sách chuyển xác suất sang câu được chọn, thành 0,7 và 0,3, hiệu phần thưởng ẩn là và mất mát giảm còn 0,504. Không cần mô hình thưởng, không cần lấy mẫu từ chính sách trong khi huấn luyện, và không cần critic.
15.3Kiểm chứng bằng số#
Phép suy ra ở trên chặt chẽ trên giấy; thí nghiệm kiểm tra nó khi chạy thật. Trên một không gian 8 câu trả lời, đủ nhỏ để giải chính xác, ta sinh 52 588 cặp so sánh từ một hàm thưởng thật đã biết theo mô hình Bradley–Terry, rồi tìm chính sách theo hai cách. Cách thứ nhất là RLHF hai bước: khớp hàm thưởng bằng hợp lý cực đại, rồi tính . Cách thứ hai là DPO một bước: cực tiểu trực tiếp theo , không dùng mô hình thưởng nào.
| Câu trả lời | RLHF hai bước | DPO một bước | Chênh lệch | |
|---|---|---|---|---|
| 0 | 0,0669 | 0,0015 | 0,0015 | |
| 1 | 0,0246 | 0,0000 | 0,0000 | |
| 2 | 0,6201 | 0,4329 | 0,4329 | |
| 3 | 0,0087 | 0,0080 | 0,0080 | |
| 4 | 0,0845 | 0,0060 | 0,0060 | |
| 5 | 0,0378 | 0,0143 | 0,0143 | |
| 6 | 0,0306 | 0,2868 | 0,2868 | |
| 7 | 0,1267 | 0,2504 | 0,2504 |
Chênh lệch lớn nhất là : hai chính sách trùng nhau tới sai số của bộ tối ưu. Hàm thưởng học được ở cách thứ nhất có tương quan 0,99995 với hàm thưởng thật, nên phép so sánh không bị ảnh hưởng bởi một mô hình thưởng kém.
So cột với cột kết quả cho thấy phép đánh trọng số lại theo hàm mũ ở Mục 14.4: câu trả lời 6 tăng từ 0,0306 lên 0,2868 (gấp khoảng 9,4 lần), câu trả lời 0 giảm từ 0,0669 xuống 0,0015 (khoảng 45 lần).
15.4So sánh DPO với RLHF#
| RLHF với PPO | DPO | |
|---|---|---|
| Số mô hình trong bộ nhớ khi huấn luyện | 4 | 2 |
| Cần mô hình thưởng riêng | có | không |
| Độ ổn định khi huấn luyện | thấp hơn | cao hơn |
| Học trên câu trả lời do chính sách hiện tại sinh ra | có, lấy mẫu mới trong khi huấn luyện | không, chỉ dùng tập so sánh cố định |
| Có một mô hình thưởng dùng lại được | có | không |
Hai dòng cuối là điểm mạnh còn lại của RLHF. RLHF lấy mẫu từ chính sách hiện tại rồi chấm bằng mô hình thưởng, nên học được trên đúng những câu trả lời mô hình đang sinh ra. DPO chỉ học trên tập so sánh đã thu thập sẵn; khi chính sách đi xa khỏi phân phối của tập đó, tín hiệu học yếu đi. Xu và cộng sự (2024) so sánh hai cách trên nhiều nhiệm vụ và thấy PPO được chỉnh tốt vẫn có thể cho kết quả tốt hơn DPO, nhất là ở các nhiệm vụ như sinh mã. Ngoài ra, mô hình thưởng là một thành phần dùng lại được: chấm dữ liệu mới, so sánh các phiên bản mô hình, phát hiện suy giảm chất lượng trong vận hành.
Vì vậy khi phải chọn giữa hai cách, không có phe nào đúng tuyệt đối. Hai phương pháp tối ưu cùng một mục tiêu và có cùng nghiệm tối ưu trên lý thuyết; DPO đơn giản, rẻ và ổn định hơn nên là lựa chọn mặc định hợp lý. RLHF có lợi thế khi cần học trên phân phối câu trả lời mà mô hình đang sinh ra, hoặc khi mô hình thưởng có giá trị riêng cho đánh giá và giám sát.
15.5Các phương pháp sau DPO#
Hướng nghiên cứu này còn phát triển nhanh, nên ở đây chỉ nêu các ý chính. IPO (Azar và cộng sự, 2024) xử lý một điểm yếu của DPO: khi dữ liệu so sánh gần như tất định, tức một câu trả lời luôn được chọn, DPO có xu hướng đẩy tỉ số xác suất ra vô cùng, giống hiện tượng trọng số của hồi quy logistic tăng không giới hạn trên dữ liệu tách được (Mục 6.5 của Nền tảng). IPO thay hàm mất mát để chặn hiện tượng này. KTO (Ethayarajh và cộng sự, 2024) chỉ cần nhãn "tốt" hoặc "không tốt" cho từng câu trả lời riêng lẻ, không cần cặp so sánh, nên dữ liệu rẻ hơn khi thu thập. Một hướng khác thay người gán nhãn bằng chính một mô hình ngôn ngữ: phản hồi từ AI (RLAIF; Bai và cộng sự, 2022b) dùng một mô hình, theo một bộ nguyên tắc viết sẵn, để tạo dữ liệu so sánh.
Các phương pháp này giữ cùng khung, cực đại phần thưởng có ràng buộc KL, và thay đổi cách lấy tín hiệu hoặc cách hạn chế độ lệch. Nắm được khung ở Mục 14.4 thì đọc một phương pháp mới chủ yếu là xem nó thay đổi thành phần nào.
15.6Tóm tắt#
Nghiệm dạng đóng của RLHF cho phép viết phần thưởng qua chính sách, . Mô hình Bradley–Terry chỉ dùng hiệu phần thưởng của hai câu trả lời cho cùng một câu hỏi, nên triệt tiêu, và hàm mất mát DPO tính trực tiếp được từ dữ liệu so sánh. Trên không gian 8 câu trả lời, chính sách DPO trùng chính sách RLHF hai bước tới . DPO đơn giản và ổn định hơn, chỉ cần 2 mô hình trong bộ nhớ; RLHF giữ lợi thế khi cần học trên câu trả lời do chính sách hiện tại sinh ra và khi cần một mô hình thưởng dùng lại được. Các phương pháp ra đời sau như IPO, KTO và RLAIF giữ cùng khung cực đại phần thưởng có ràng buộc KL.
Với chương này, giáo trình đã đi hết con đường đặt ra ở Chương 1: biểu diễn dữ liệu bằng vector, tiền huấn luyện và tái sử dụng mô hình, sinh nội dung mới, và căn chỉnh hành vi theo mong muốn của con người. Cách đưa một mô hình đã căn chỉnh vào sản phẩm, với prompt, truy xuất tài liệu và đánh giá, là nội dung của giáo trình Ứng dụng LLM.
16Bài tập#
Các bài tập đi theo các chương của giáo trình. Bốn bài yêu cầu suy luận lại các phép chứng minh chính: word2vec phân rã ma trận PMI, dạng đóng của quá trình khuếch tán, gradient của hai hàm mất mát GAN và hàm mất mát DPO. Hai bài tính tay số tham số của LoRA và nghiệm của bài toán RLHF, hai bài chẩn đoán các tình huống hay gặp khi dùng embedding và khi huấn luyện, một bài thiết kế trợ lý cho một công ty bảo hiểm, và bài cuối là một thí nghiệm cần chạy mã. Lời giải chi tiết, kèm nhãn chương và độ khó của từng bài, nằm ở trang Lời giải.
Bài 1 (suy luận). Levy và Goldberg (2014) chứng minh skip-gram với lấy mẫu âm ngầm phân rã ma trận PMI dịch đi . (a) Viết phần hàm mục tiêu kỳ vọng phụ thuộc vào của một cặp , rồi cho đạo hàm theo bằng 0. (b) Suy ra . (c) Tăng từ 1 lên 15 thì ma trận đích thay đổi thế nào? Nếu sau đó cắt các giá trị âm về 0, số phần tử bằng 0 thay đổi ra sao? (d) Vì sao ở hạng đầy đủ gradient descent hội tụ về đúng ma trận đó, còn ở hạng thấp thì không? Số đo ở Mục 2.6 cho thấy điều gì?
Bài 2 (chẩn đoán). Một hệ thống tìm kiếm ngữ nghĩa lấy trung bình trạng thái ẩn của một mô hình ngôn ngữ làm embedding câu, rồi xếp hạng bằng cosine. Mọi cặp câu đều có cosine từ 0,82 tới 0,94, kể cả những cặp rõ ràng không liên quan. (a) Chẩn đoán vấn đề và giải thích cơ chế. (b) Nêu cách sửa rẻ nhất, và dùng số đo ở Mục 3.2 để nói nó hiệu quả tới đâu. (c) Vì sao không nên sửa bằng cách nâng ngưỡng cosine lên 0,93? (d) Nêu cách sửa triệt để và những gì nó đòi hỏi thêm.
Bài 3 (tính tay). Một mô hình có , 32 lớp, tổng 6 476 005 376 tham số không tính embedding. Gắn LoRA hạng vào và của mọi lớp. (a) Viết công thức số tham số huấn luyện theo , rồi tính với . (b) Với , trạng thái Adam ở FP32 chiếm bao nhiêu bộ nhớ? So với tinh chỉnh toàn phần. (c) Tỉ số thay đổi thế nào khi tăng từ 768 lên 8 192 với cố định? Điều đó cho biết gì về lợi ích của LoRA với mô hình lớn? (d) Một công ty phục vụ 50 khách hàng, mỗi khách hàng một phiên bản tinh chỉnh riêng của một mô hình 13 GB. Tính dung lượng lưu trữ khi tinh chỉnh toàn phần và khi dùng LoRA , giả sử mỗi adapter 16 MB.
Bài 4 (suy luận). Quá trình thuận của mô hình khuếch tán: . (a) Chứng minh bằng quy nạp rằng với . (b) Vì sao dạng đóng này cần thiết để huấn luyện khả thi? (c) Với lịch tuyến tính từ tới qua 1 000 bước, ở bước cuối bằng . Còn lại bao nhiêu phần trăm biên độ tín hiệu, và vì sao con số này quan trọng? (d) Giải thích vì sao ở nhỏ mô hình học chi tiết, còn ở lớn mô hình học bố cục.
Bài 5 (suy luận). Hai hàm mất mát cho bộ sinh của GAN: cực tiểu và cực đại , với . (a) Tính đạo hàm của mỗi hàm theo . (b) Lúc bắt đầu huấn luyện, với mẫu giả. Gradient của mỗi hàm lớn cỡ nào? (c) Dùng kết quả đo ở Mục 10.2 để nêu hậu quả. (d) Hai hàm có cùng điểm cố định. Từ đó rút ra nhận định tổng quát nào về việc chọn hàm mất mát? Nêu một ví dụ khác trong các giáo trình của lộ trình cho thấy cùng hiện tượng.
Bài 6 (tính tay). Bài toán RLHF trên câu trả lời rời rạc. (a) Lập hàm Lagrange với ràng buộc , cho đạo hàm theo bằng 0 và suy ra nghiệm dạng đóng. (b) Khi và , chính sách tối ưu là gì? Giải thích bằng lời. (c) Nếu với một câu trả lời , thì bằng bao nhiêu dù lớn tới đâu? Điều đó có ý nghĩa gì cho an toàn, và nó không bảo đảm được điều gì? (d) Dùng số liệu ở Mục 14.4 để giải thích vì sao nên xem là một vị trí trên đường đánh đổi thay vì một siêu tham số có giá trị đúng duy nhất.
Bài 7 (suy luận). Suy ra hàm mất mát DPO. (a) Từ nghiệm dạng đóng ở Bài 6, viết theo và . (b) Thay vào hợp lý Bradley–Terry và chỉ rõ chỗ triệt tiêu. (c) Vì sao phép triệt tiêu đòi hỏi hai câu trả lời phải cho cùng một câu hỏi ? (d) Nêu hai tình huống RLHF có thể tốt hơn DPO, dù hai phương pháp có cùng nghiệm tối ưu.
Bài 8 (chẩn đoán). Với mỗi tình huống, nêu vấn đề và hai việc nên làm: (a) Huấn luyện VAE, sai số tái dựng cao còn KL gần như bằng 0 ở mọi chiều ẩn. (b) Tinh chỉnh toàn phần một mô hình trên 80 mẫu có nhãn cho độ chính xác kiểm tra thấp hơn khi chỉ học lớp cuối trên đặc trưng đóng băng. (c) Đóng băng đặc trưng và tăng dữ liệu từ 500 lên 5 000 mẫu, độ chính xác chỉ tăng từ 0,62 lên 0,64. (d) Huấn luyện GAN 20 000 vòng, mất mát của bộ sinh tăng đều. Có nên dừng không?
Bài 9 (thiết kế). Một công ty bảo hiểm muốn xây trợ lý hỗ trợ khách hàng từ một mô hình ngôn ngữ mở trọng số 7 tỉ tham số. (a) Công ty có 3 000 đoạn hội thoại mẫu do nhân viên giỏi viết. Nên tinh chỉnh toàn phần, dùng LoRA, hay chỉ viết prompt? Trả lời dựa trên Mục 6.3 và Mục 7.3. (b) Sau ba tháng, công ty thu được 40 000 cặp so sánh do khách hàng đánh giá ("câu trả lời nào hữu ích hơn"). Thiết kế bước tiếp theo, chọn DPO hoặc RLHF và giải thích. (c) Bộ phận pháp chế yêu cầu trợ lý không bao giờ hứa chi trả bảo hiểm. Vì sao ràng buộc KL ở Mục 14.4 không đủ bảo đảm điều đó, và cần thêm gì? (d) Thiết kế cách giám sát trợ lý khi vận hành, dựa trên Chương 10 của MLOps.
Bài 10 (thí nghiệm). Trong phần (G) của code/bieudien/experiments.py, GAN với hàm mất mát không bão hoà phủ đủ 8 cụm ở mọi lần khởi tạo, tức không tái hiện được sụp chế độ.
(a) Nêu ba thay đổi có thể làm sụp chế độ xuất hiện, và với mỗi thay đổi, nêu cơ chế dự kiến.
(b) Cài một trong ba thay đổi, chạy lại và báo cáo kết quả, kể cả khi kết quả khác với dự đoán.
(c) Đề xuất một chỉ số đo mức phủ tốt hơn việc đếm số cụm có điểm rơi vào. Gợi ý: xét phân phối số điểm rơi vào mỗi cụm.
(d) Vì sao phủ đủ các chế độ chưa đủ để kết luận mô hình học đúng phân phối? Dùng con số 15,3% ở Mục 10.3.
17Câu hỏi phỏng vấn#
17.1Cách trình bày câu trả lời#
Các câu hỏi về biểu diễn, mô hình sinh và căn chỉnh thường có dạng "X hoạt động thế nào" hoặc "vì sao dùng X thay cho Y". Câu trả lời tốt đi theo ba bước như ở các giáo trình trước: vấn đề X giải quyết, cơ chế (tốt nhất bằng một công thức ngắn hoặc một con số), và giới hạn của X. Với nhóm chủ đề này, nêu được mối liên hệ giữa các phương pháp thường làm câu trả lời nổi bật, ví dụ word2vec là phân rã ma trận PMI, hay DPO và RLHF có cùng nghiệm tối ưu.
17.2Biểu diễn#
Câu hỏi: Word2Vec hoạt động thế nào?
Trả lời
Word2Vec dựa trên giả thuyết phân bố: các từ xuất hiện trong ngữ cảnh giống nhau có nghĩa giống nhau. Skip-gram học hai vector cho mỗi từ sao cho tích vô hướng giữa từ trung tâm và từ ngữ cảnh lớn với các cặp thật, nhỏ với các cặp ghép ngẫu nhiên. Levy và Goldberg (2014) chứng minh rằng ở điểm tối ưu, tích vô hướng bằng PMI dịch đi , nên word2vec thực chất phân rã ma trận PMI mà không lập ma trận đó. Ở Mục 2.6, với hạng đầy đủ, tích vô hướng học được có tương quan 0,9995 với PMI.
Câu hỏi: Vì sao cần lấy mẫu âm?
Trả lời
Softmax đầy đủ có mẫu số là tổng trên toàn bộ từ vựng, tính lại cho mỗi cặp huấn luyện. Lấy mẫu âm thay bài toán chọn 1 trong từ bằng bài toán phân loại nhị phân, nên chi phí không phụ thuộc . Với từ vựng 2 triệu từ và vector 300 chiều, softmax đầy đủ tốn khoảng 1,2 tỉ phép tính mỗi cặp, lấy mẫu âm với tốn 3 600. Số mũ 3/4 trong phân phối lấy mẫu là lựa chọn thực nghiệm.
Câu hỏi: Vì sao cosine giữa hai embedding bất kỳ thường rất cao?
Trả lời
Do tính bất đẳng hướng: đám mây embedding lệch khỏi gốc toạ độ, nên mọi vector có chung một thành phần lớn. Ở Mục 3.2, 900 vector ngẫu nhiên độc lập cộng một vector hằng có cosine trung bình 0,87, dù không có quan hệ gì với nhau. Trừ vector trung bình đưa con số này về khoảng 0. Cách sửa triệt để là huấn luyện embedding với mục tiêu tương phản.
Câu hỏi: Chiều thứ 37 của một embedding mang nghĩa gì?
Trả lời
Thường không mang nghĩa riêng. Nếu thì với mọi ma trận trực giao : xoay toàn bộ không gian không thay đổi mọi tích vô hướng, nên hệ trục toạ độ là tuỳ ý. Thứ có nghĩa là quan hệ giữa các vector. Các chiều chỉ diễn giải được khi huấn luyện có thêm ràng buộc, như bộ tự mã hoá thưa.
Câu hỏi: Vì sao không dùng trực tiếp trạng thái ẩn của BERT làm embedding câu?
Trả lời
Vì mô hình được huấn luyện để đoán token bị che, không được huấn luyện để các câu cùng nghĩa có biểu diễn gần nhau. Reimers và Gurevych (2019) cho thấy trung bình các vector đầu ra của BERT kém cả trung bình vector GloVe trên các bộ đánh giá độ tương đồng câu. Cần huấn luyện thêm với mục tiêu tương phản trên các cặp câu liên quan, dùng các câu khác trong lô làm mẫu âm.
17.3Học chuyển giao#
Câu hỏi: Vì sao dự đoán token tiếp theo dạy được nhiều kỹ năng?
Trả lời
Để dự đoán đúng trong mọi ngữ cảnh, mô hình buộc phải nắm sự kiện về thế giới, quan hệ ngữ pháp, phép tính đơn giản và cấu trúc mã nguồn. Không kỹ năng nào được dạy riêng; chúng là hệ quả của việc giảm mất mát trên một kho văn bản đủ lớn và đa dạng. Nhiệm vụ dự đoán token là một nhiệm vụ đại diện rất rộng, và nhãn tự sinh ra từ dữ liệu.
Câu hỏi: Nên đóng băng hay tinh chỉnh toàn phần?
Trả lời
Tuỳ lượng dữ liệu có nhãn và mức phù hợp của đặc trưng tiền huấn luyện. Ở thí nghiệm Mục 6.3, với 20 và 50 mẫu, ba cách không phân biệt được; từ 150 mẫu trở lên, tinh chỉnh toàn phần vượt đóng băng, khoảng cách tăng tới 0,17 ở 8 000 mẫu (0,818 so với 0,645). Cột đóng băng gần như không tăng từ 500 mẫu: đặc trưng cố định đặt một giới hạn trên, và khi thấy dấu hiệu đó thì thêm dữ liệu không giúp, cần cho phép cập nhật các lớp dưới.
Câu hỏi: LoRA hoạt động thế nào và tiết kiệm được gì?
Trả lời
LoRA đóng băng và học phần cộng thêm , với , , , dựa trên giả định phần cần thay đổi có hạng thấp. khởi tạo bằng 0 để mô hình bắt đầu đúng bằng mô hình gốc. Với Llama 2 7B, LoRA trên và có 4 194 304 tham số, trạng thái Adam 32 MiB so với 48,2 GiB khi tinh chỉnh toàn phần. LoRA tiết kiệm bộ nhớ khi huấn luyện và dung lượng lưu trữ; khi suy luận, được cộng vào nên tốc độ không đổi.
Câu hỏi: LoRA có làm mô hình chạy nhanh hơn không?
Trả lời
Không. Khi suy luận, được cộng vào một lần, nên mô hình chạy đúng bằng tốc độ mô hình gốc. Nếu không gộp, để đổi adapter theo từng yêu cầu, thì chậm hơn một chút.
17.4Mô hình sinh#
Câu hỏi: VAE, GAN và mô hình khuếch tán khác nhau thế nào?
Trả lời
Cả ba biến nhiễu Gauss thành mẫu, khác nhau ở cách huấn luyện: VAE cực đại một chặn dưới của log hợp lý; GAN là trò chơi giữa bộ sinh và bộ phân biệt; mô hình khuếch tán giải một bài hồi quy dự đoán nhiễu. Mô hình khuếch tán thay thế GAN trong phần lớn ứng dụng sinh ảnh vì đạt độ sắc nét tương đương mà huấn luyện ổn định; đổi lại phải lấy mẫu nhiều bước.
Câu hỏi: Vì sao mẫu của VAE thường mờ?
Trả lời
Với bộ giải mã Gauss, số hạng tái dựng là bình phương sai số, và hàm cực tiểu hoá bình phương sai số là kỳ vọng có điều kiện . Nếu nhiều ảnh thật ứng với cùng một , trung bình của chúng nhoè ở các đường viền. Độ mờ là hệ quả của hàm mất mát, không chủ yếu do mô hình thiếu dung lượng.
Câu hỏi: Hệ số trong VAE điều khiển điều gì?
Trả lời
Ngoài việc cân bằng tái dựng và KL, nó quyết định số chiều ẩn còn mang thông tin. Ở Mục 9.3, dữ liệu sinh từ đúng 2 yếu tố, VAE được cho 6 chiều ẩn: với cả 6 chiều đều dùng; với đúng 2 chiều mang thông tin; với không chiều nào, tức sụp hậu nghiệm, và sai số tái dựng tăng lên 15,28.
Câu hỏi: Vì sao bài báo GAN gốc đổi hàm mất mát của bộ sinh?
Trả lời
Với , đạo hàm của theo là . Lúc đầu bộ sinh kém, với mẫu giả, nên gradient gần 0 và bộ sinh không học được. Cực đại cho đạo hàm , lớn nhất khi bộ sinh kém nhất. Ở Mục 10.2, dạng gốc phủ 0 trong 8 cụm ở cả bốn lần khởi tạo, dạng không bão hoà phủ đủ 8 cụm.
Câu hỏi: Vì sao mô hình khuếch tán dễ huấn luyện hơn GAN?
Trả lời
Vì hàm mất mát là bình phương sai số giữa nhiễu thật và nhiễu dự đoán, một bài hồi quy: mất mát giảm nghĩa là mô hình tốt lên, không có trò chơi giữa hai mạng. Dạng đóng cho phép lấy ở bước bất kỳ trong một phép tính, nên mỗi bước huấn luyện chỉ cần một bước ngẫu nhiên .
17.5Căn chỉnh#
Câu hỏi: Vì sao cần RLHF khi đã có tinh chỉnh có giám sát?
Trả lời
Tinh chỉnh có giám sát là học bắt chước, nên mô hình chỉ tốt bằng các câu trả lời mẫu. RLHF học từ so sánh, và đánh giá câu trả lời nào tốt hơn dễ hơn tự viết câu trả lời tốt nhất, nên tín hiệu so sánh cho phép vượt chất lượng của câu trả lời mẫu. So sánh cũng nhất quán giữa những người gán nhãn hơn chấm điểm tuyệt đối.
Câu hỏi: Nghiệm của bài toán RLHF có ràng buộc KL là gì?
Trả lời
: chính sách tham chiếu đánh trọng số lại theo hàm mũ của phần thưởng, suy ra bằng nhân tử Lagrange. Nếu thì bất kể phần thưởng. Ở Mục 14.4, nghiệm dạng đóng khớp với nghiệm tìm bằng BFGS tới .
Câu hỏi: Vì sao cần số hạng KL?
Trả lời
Để hạn chế lách phần thưởng. Mô hình thưởng là một xấp xỉ học từ dữ liệu hữu hạn; tối ưu quá mạnh theo nó là tối ưu theo điểm yếu của xấp xỉ, và mô hình có thể mất khả năng ngôn ngữ để đạt điểm cao. chọn một điểm trên đường đánh đổi giữa phần thưởng và độ lệch khỏi mô hình tham chiếu.
Câu hỏi: DPO hoạt động thế nào?
Trả lời
Nghiệm dạng đóng của RLHF đảo ngược được: . Thay vào mô hình Bradley–Terry, vốn chỉ dùng hiệu phần thưởng của hai câu trả lời cho cùng một câu hỏi, triệt tiêu. Kết quả là một hàm mất mát cross-entropy nhị phân tính trực tiếp từ dữ liệu so sánh, không cần mô hình thưởng hay học tăng cường. Ở Mục 15.3, chính sách DPO và chính sách RLHF hai bước khác nhau không quá .
Câu hỏi: Nên dùng DPO hay RLHF?
Trả lời
Hai phương pháp tối ưu cùng một mục tiêu và có cùng nghiệm tối ưu. DPO đơn giản, cần 2 mô hình trong bộ nhớ thay vì 4, ổn định hơn, nên là lựa chọn mặc định hợp lý. RLHF có lợi thế khi cần học trên các câu trả lời mà chính sách hiện tại sinh ra, và mô hình thưởng của nó dùng lại được để đánh giá và giám sát.
Câu hỏi: -tham lam có phải cách khám phá duy nhất không?
Trả lời
Không. Khởi tạo lạc quan, tức khởi tạo hàm giá trị cao hơn giá trị thật, làm mọi hành động chưa thử trông hấp dẫn, nên chính sách tham lam tự khám phá. Ở Mục 12.4, với phạt mỗi bước và , vẫn tới đích 100%; với khởi tạo bi quan , ngay cả cũng không đủ.
17.6Các câu trả lời chưa đạt#
| Câu trả lời | Vì sao chưa đạt |
|---|---|
| "Word2Vec là mạng nơ-ron sâu." | Mô hình chỉ có một lớp tuyến tính; về bản chất là phân rã ma trận PMI. |
| "Embedding hiểu nghĩa của từ." | Embedding nắm thống kê đồng hiện, nên không phân biệt được các từ trái nghĩa có ngữ cảnh giống nhau. |
| "Cosine 0,9 nghĩa là hai câu rất giống nhau." | Trên đám mây bất đẳng hướng, hai vector ngẫu nhiên cũng có cosine khoảng 0,87. |
| "LoRA làm mô hình chạy nhanh hơn." | Khi suy luận, được gộp vào nên tốc độ bằng mô hình gốc; LoRA tiết kiệm bộ nhớ khi huấn luyện. |
| "Hạng LoRA càng cao càng tốt." | Hạng cao hơn thì nhiều tham số hơn, phương sai lớn hơn; với ít dữ liệu, hạng nhỏ thường đủ. |
| "VAE mờ vì mô hình chưa đủ lớn." | Độ mờ đến từ hàm mất mát bình phương, có nghiệm tối ưu là kỳ vọng có điều kiện. |
| "GAN khó huấn luyện vì khó chỉnh siêu tham số." | Lý do sâu hơn: bài toán tìm điểm cân bằng thay vì cực tiểu, và đường cong mất mát không phản ánh chất lượng. |
| "Mô hình khuếch tán chậm nên kém GAN." | Chậm khi lấy mẫu, nhưng huấn luyện là hồi quy ổn định; lấy mẫu chậm cải thiện được bằng DDIM, chưng cất, không gian ẩn. |
| "RLHF dạy mô hình trả lời đúng." | RLHF dạy mô hình trả lời theo sở thích của người đánh giá, không nhất thiết đúng sự thật. |
| "DPO là phiên bản xấp xỉ của RLHF." | DPO tối ưu cùng mục tiêu và có cùng nghiệm; khác biệt nằm ở dữ liệu dùng khi huấn luyện, không ở mục tiêu. |
| "Tăng trong RLHF làm mô hình an toàn hơn." | giữ mô hình gần ; nếu có hành vi không an toàn thì tăng không giúp. |
| "Muốn khám phá thì phải có ." | Khởi tạo lạc quan cũng là cơ chế khám phá; ở Mục 12.4, vẫn thành công nhờ nó. |
18Tài liệu tham khảo#
Biểu diễn và embedding
- Z. S. Harris. Distributional Structure. Word, 1954. Giả thuyết phân bố.
- J. R. Firth. A Synopsis of Linguistic Theory 1930–1955. Studies in Linguistic Analysis, 1957.
- T. Mikolov, K. Chen, G. Corrado, J. Dean. Efficient Estimation of Word Representations in Vector Space. ICLR Workshop, 2013.
- T. Mikolov và cộng sự. Distributed Representations of Words and Phrases and their Compositionality. NeurIPS, 2013. Lấy mẫu âm và số mũ 3/4.
- O. Levy, Y. Goldberg. Neural Word Embedding as Implicit Matrix Factorization. NeurIPS, 2014. Định lý 2.1.
- O. Levy, Y. Goldberg, I. Dagan. Improving Distributional Similarity with Lessons Learned from Word Embeddings. TACL, 2015.
- J. Pennington, R. Socher, C. D. Manning. GloVe: Global Vectors for Word Representation. EMNLP, 2014.
- J. Gao và cộng sự. Representation Degeneration Problem in Training Natural Language Generation Models. ICLR, 2019. Tính bất đẳng hướng.
- K. Ethayarajh. How Contextual are Contextualized Word Representations? EMNLP, 2019.
- M. E. Peters và cộng sự. Deep Contextualized Word Representations. NAACL, 2018. ELMo.
- J. Devlin, M.-W. Chang, K. Lee, K. Toutanova. BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding. NAACL, 2019.
- N. Reimers, I. Gurevych. Sentence-BERT: Sentence Embeddings using Siamese BERT-Networks. EMNLP, 2019.
- A. van den Oord, Y. Li, O. Vinyals. Representation Learning with Contrastive Predictive Coding. arXiv:1807.03748, 2018. Hàm mất mát InfoNCE.
- T. Gao, X. Yao, D. Chen. SimCSE: Simple Contrastive Learning of Sentence Embeddings. EMNLP, 2021.
- L. Wang và cộng sự. Text Embeddings by Weakly-Supervised Contrastive Pre-training. arXiv:2212.03533, 2022. Họ mô hình E5.
- H. Jégou, M. Douze, C. Schmid. Product Quantization for Nearest Neighbor Search. IEEE TPAMI, 2011.
- Y. A. Malkov, D. A. Yashunin. Efficient and Robust Approximate Nearest Neighbor Search Using Hierarchical Navigable Small World Graphs. IEEE TPAMI, 2018.
Học chuyển giao và tinh chỉnh tiết kiệm tham số
- J. Howard, S. Ruder. Universal Language Model Fine-tuning for Text Classification. ACL, 2018. Mở đóng băng dần.
- M. McCloskey, N. J. Cohen. Catastrophic Interference in Connectionist Networks. Psychology of Learning and Motivation, 1989.
- N. Houlsby và cộng sự. Parameter-Efficient Transfer Learning for NLP. ICML, 2019. Adapter.
- E. J. Hu và cộng sự. LoRA: Low-Rank Adaptation of Large Language Models. ICLR, 2022.
- A. Aghajanyan, L. Zettlemoyer, S. Gupta. Intrinsic Dimensionality Explains the Effectiveness of Language Model Fine-Tuning. ACL, 2021.
- T. Dettmers, A. Pagnoni, A. Holtzman, L. Zettlemoyer. QLoRA: Efficient Finetuning of Quantized LLMs. NeurIPS, 2023.
- D. Biderman và cộng sự. LoRA Learns Less and Forgets Less. TMLR, 2024.
- X. L. Li, P. Liang. Prefix-Tuning: Optimizing Continuous Prompts for Generation. ACL, 2021.
- B. Lester, R. Al-Rfou, N. Constant. The Power of Scale for Parameter-Efficient Prompt Tuning. EMNLP, 2021.
- E. Ben Zaken, S. Ravfogel, Y. Goldberg. BitFit: Simple Parameter-efficient Fine-tuning for Transformer-based Masked Language-models. ACL, 2022.
Mô hình sinh
- D. P. Kingma, M. Welling. Auto-Encoding Variational Bayes. ICLR, 2014. VAE và tái tham số hoá.
- I. Higgins và cộng sự. beta-VAE: Learning Basic Visual Concepts with a Constrained Variational Framework. ICLR, 2017.
- M. E. Tipping, C. M. Bishop. Probabilistic Principal Component Analysis. Journal of the Royal Statistical Society B, 1999.
- S. R. Bowman và cộng sự. Generating Sentences from a Continuous Space. CoNLL, 2016. Sụp hậu nghiệm với bộ giải mã tự hồi quy.
- I. Goodfellow và cộng sự. Generative Adversarial Nets. NeurIPS, 2014. Bài toán minimax, bộ phân biệt tối ưu và hàm mất mát không bão hoà.
- M. Arjovsky, S. Chintala, L. Bottou. Wasserstein Generative Adversarial Networks. ICML, 2017.
- M. Heusel và cộng sự. GANs Trained by a Two Time-Scale Update Rule Converge to a Local Nash Equilibrium. NeurIPS, 2017. Chỉ số FID.
- J. Sohl-Dickstein, E. Weiss, N. Maheswaranathan, S. Ganguli. Deep Unsupervised Learning using Nonequilibrium Thermodynamics. ICML, 2015.
- J. Ho, A. Jain, P. Abbeel. Denoising Diffusion Probabilistic Models. NeurIPS, 2020. Dạng đóng, hàm mất mát dự đoán nhiễu.
- J. Song, C. Meng, S. Ermon. Denoising Diffusion Implicit Models. ICLR, 2021.
- A. Nichol, P. Dhariwal. Improved Denoising Diffusion Probabilistic Models. ICML, 2021. Lịch nhiễu cosine.
- T. Salimans, J. Ho. Progressive Distillation for Fast Sampling of Diffusion Models. ICLR, 2022.
- R. Rombach và cộng sự. High-Resolution Image Synthesis with Latent Diffusion Models. CVPR, 2022.
- J. Ho, T. Salimans. Classifier-Free Diffusion Guidance. arXiv:2207.12598, 2022.
Học tăng cường và căn chỉnh
- R. S. Sutton, A. G. Barto. Reinforcement Learning: An Introduction, 2nd ed. MIT Press, 2018. Khởi tạo lạc quan ở Chương 2.
- C. J. C. H. Watkins, P. Dayan. Q-learning. Machine Learning, 1992.
- R. J. Williams. Simple Statistical Gradient-Following Algorithms for Connectionist Reinforcement Learning. Machine Learning, 1992. REINFORCE và đường nền.
- R. S. Sutton, D. McAllester, S. Singh, Y. Mansour. Policy Gradient Methods for Reinforcement Learning with Function Approximation. NeurIPS, 2000.
- J. Schulman và cộng sự. High-Dimensional Continuous Control Using Generalized Advantage Estimation. ICLR, 2016.
- J. Schulman và cộng sự. Proximal Policy Optimization Algorithms. arXiv:1707.06347, 2017.
- P. F. Christiano và cộng sự. Deep Reinforcement Learning from Human Preferences. NeurIPS, 2017.
- N. Stiennon và cộng sự. Learning to Summarize from Human Feedback. NeurIPS, 2020.
- L. Ouyang và cộng sự. Training Language Models to Follow Instructions with Human Feedback. NeurIPS, 2022. InstructGPT và quy trình ba giai đoạn.
- Y. Bai và cộng sự. Training a Helpful and Harmless Assistant with Reinforcement Learning from Human Feedback. arXiv:2204.05862, 2022a.
- Y. Bai và cộng sự. Constitutional AI: Harmlessness from AI Feedback. arXiv:2212.08073, 2022b.
- R. A. Bradley, M. E. Terry. Rank Analysis of Incomplete Block Designs: I. The Method of Paired Comparisons. Biometrika, 1952.
- L. Gao, J. Schulman, J. Hilton. Scaling Laws for Reward Model Overoptimization. ICML, 2023.
- R. Rafailov và cộng sự. Direct Preference Optimization: Your Language Model is Secretly a Reward Model. NeurIPS, 2023.
- S. Xu và cộng sự. Is DPO Superior to PPO for LLM Alignment? A Comprehensive Study. ICML, 2024.
- M. G. Azar và cộng sự. A General Theoretical Paradigm to Understand Learning from Human Preferences. AISTATS, 2024. IPO.
- K. Ethayarajh và cộng sự. KTO: Model Alignment as Prospect Theoretic Optimization. ICML, 2024.
Phụ lục: chạy lại thí nghiệm#
code/bieudien/
├── experiments.py            # Hình 2, 3, 4, 6, 8, 9, 10, 12, 13 và mọi số liệu đo được
├── experiments_output.txt    # kết quả in ra của script trên
└── fig_diagrams.py           # Hình 1, 5, 7, 11, 14 (sơ đồ khái niệm)
pip install numpy scipy matplotlib scikit-learn
python code/bieudien/experiments.py     # khoảng 5 phút trên CPU
python code/bieudien/fig_diagrams.py
Môi trường đã dùng: Python 3.13, NumPy 2.3, SciPy 1.16, scikit-learn 1.7, matplotlib 3.10. Trên Windows, đặt PYTHONIOENCODING=utf-8 khi ghi kết quả ra tệp.
Các kết quả kiểm chứng đẳng thức phải khớp tới sai số của bộ giải chứ không chỉ khớp gần đúng:
| Đẳng thức | Sai lệch đo được |
|---|---|
| Nghiệm RLHF có ràng buộc KL khớp dạng đóng (Mục 14.4) | tới |
| Chính sách DPO trùng chính sách RLHF hai bước (Mục 15.3) | |
| Dạng đóng của quá trình thuận khuếch tán (Mục 11.2) | khớp trung bình và phương sai trên 200 000 quỹ đạo |
| Skip-gram hạng đầy đủ hội tụ về PMI (Mục 2.6) | tương quan 0,9995 |
Ba kết quả khác với cách phát biểu thường gặp, và giáo trình trình bày chúng đúng như số liệu cho thấy. Bảng quét số chiều của embedding ở Mục 2.4 không phải một đường cong đánh đổi: độ chính xác loại suy đạt 100% ở 8 chiều, giảm ở 12 và 16 chiều, rồi lại 100% ở 20 chiều, vì phổ của ma trận PPMI có đúng 8 trị riêng dương. Thí nghiệm GAN ở Mục 10.3 không tái hiện được sụp chế độ; nó cho thấy dạng minimax gốc không học được vì gradient triệt tiêu, và phủ đủ các chế độ vẫn chưa có nghĩa là học đúng phân phối. Thí nghiệm học tăng cường ở Mục 12.4 cho thấy vẫn thành công trong một cấu hình nhờ khởi tạo lạc quan.
Ngoài ra, thí nghiệm ở Mục 6.3 chạy mỗi cấu hình một lần, nên các chênh lệch nhỏ ở cỡ dữ liệu nhỏ không có ý nghĩa thống kê; mô phỏng ở Mục 2.4 dùng kho ngữ liệu nhân tạo 20 từ, nên chỉ minh hoạ cơ chế chứ không đại diện cho embedding trên dữ liệu thật.