9Bộ tự mã hoá biến phân#
Bộ tự mã hoá nén dữ liệu tốt nhưng không sinh được mẫu mới. Bộ tự mã hoá biến phân (variational autoencoder, VAE; Kingma và Welling, 2014) sửa điểm này bằng cách ép không gian ẩn có một phân phối biết trước. Ràng buộc đó xuất hiện trong hàm mục tiêu dưới dạng một số hạng KL, và hệ số đứng trước số hạng này làm nhiều việc hơn cách nó thường được mô tả: như thí nghiệm ở Mục 9.3 cho thấy, nó quyết định mô hình dùng bao nhiêu chiều ẩn.
9.1Bộ tự mã hoá và hạn chế khi sinh mẫu#
Bộ tự mã hoá (autoencoder) gồm bộ mã hoá nén thành một vector ẩn ngắn hơn, và bộ giải mã dựng lại từ , huấn luyện để gần :
Với bộ mã hoá và giải mã tuyến tính, nghiệm tối ưu chính là PCA (Chương 14 của Nền tảng). Để sinh mẫu mới, cần lấy một ngẫu nhiên rồi giải mã. Nhưng lấy từ phân phối nào? Bộ tự mã hoá không ràng buộc hình dạng của tập các mà nó dùng: chúng có thể tụ thành những cụm rời rạc hoặc nằm trên một đường cong mảnh. Một điểm chọn ngẫu nhiên trong không gian ẩn nhiều khả năng rơi vào vùng bộ giải mã chưa từng thấy, và cho ra kết quả vô nghĩa. Vấn đề không phải nén kém mà là không gian ẩn không có cấu trúc để lấy mẫu.
9.2VAE và chặn dưới ELBO#
VAE xem là biến ẩn ngẫu nhiên với tiên nghiệm cố định và bộ giải mã . Hợp lý của dữ liệu không tính được, nên VAE dùng thêm bộ mã hoá để xấp xỉ hậu nghiệm .
Mệnh đề 9.1 (Chặn dưới của bằng chứng)
Với mọi phân phối ,
và vì KL không âm, .
Chứng minh
Theo định lý Bayes, với mọi . Cộng và trừ rồi lấy kỳ vọng theo (vế trái không phụ thuộc ):
trong đó hai kỳ vọng cuối chính là hai phân kỳ KL.
VAE tối đa ELBO theo cả và . Thêm hệ số cho số hạng KL (Higgins và cộng sự, 2017) được hàm mục tiêu
với là VAE gốc.
Hai số hạng có ý nghĩa rõ ràng. Số hạng tái dựng yêu cầu giải mã từ phải dựng lại được ; với bộ giải mã Gauss, đó là bình phương sai số tái dựng với dấu trừ, cộng hằng số. Số hạng KL yêu cầu phân phối của ứng với mỗi gần . Nếu mọi đều gần tiên nghiệm, lấy mẫu sẽ rơi vào vùng bộ giải mã đã quen, và việc sinh mẫu trở nên hợp lệ. Với hai phân phối Gauss, số hạng KL có dạng đóng: mỗi chiều đóng góp , bằng 0 khi và chỉ khi , . Chẳng hạn một chiều có và đóng góp nat: hậu nghiệm của nó lệch khỏi gốc một đơn vị và hẹp hơn tiên nghiệm, và đó là chi phí phải trả để chiều này mang thông tin về . Hai số hạng kéo theo hai hướng ngược nhau, và điều chỉnh sự cân bằng giữa chúng.
Lưu ý (Tái tham số hoá)
Lấy mẫu là phép ngẫu nhiên, và gradient không truyền qua phép lấy mẫu được. Cách giải quyết là viết với : phần ngẫu nhiên nằm ở , không phụ thuộc tham số, nên gradient truyền qua và như bình thường. Đây là kỹ thuật cài đặt để huấn luyện VAE bằng gradient descent, không phải ý tưởng chính của VAE.
9.3Hệ số β và số chiều ẩn còn mang thông tin#
Lời giải thích thường gặp là " cân bằng giữa tái dựng và regularization". Thí nghiệm sau cho một mô tả cụ thể hơn. Dữ liệu gồm 600 điểm trong , sinh từ đúng 2 yếu tố ẩn Gauss qua một phép biến đổi tuyến tính, cộng nhiễu nhỏ. VAE được cho 6 chiều ẩn, nhiều hơn cần thiết, để xem nó làm gì với các chiều thừa. Bộ mã hoá và giải mã đều tuyến tính, nên VAE ở đây có liên hệ trực tiếp với PCA xác suất (Tipping và Bishop, 1999) và mọi hiện tượng đều giải thích được bằng công thức.
Một chiều ẩn được xem là còn mang thông tin nếu KL của riêng chiều đó, lấy trung bình trên dữ liệu, lớn hơn 0,01 nat: hậu nghiệm còn khác tiên nghiệm . Chiều có KL bằng 0 có hậu nghiệm trùng tiên nghiệm với mọi , tức không mang thông tin gì về .
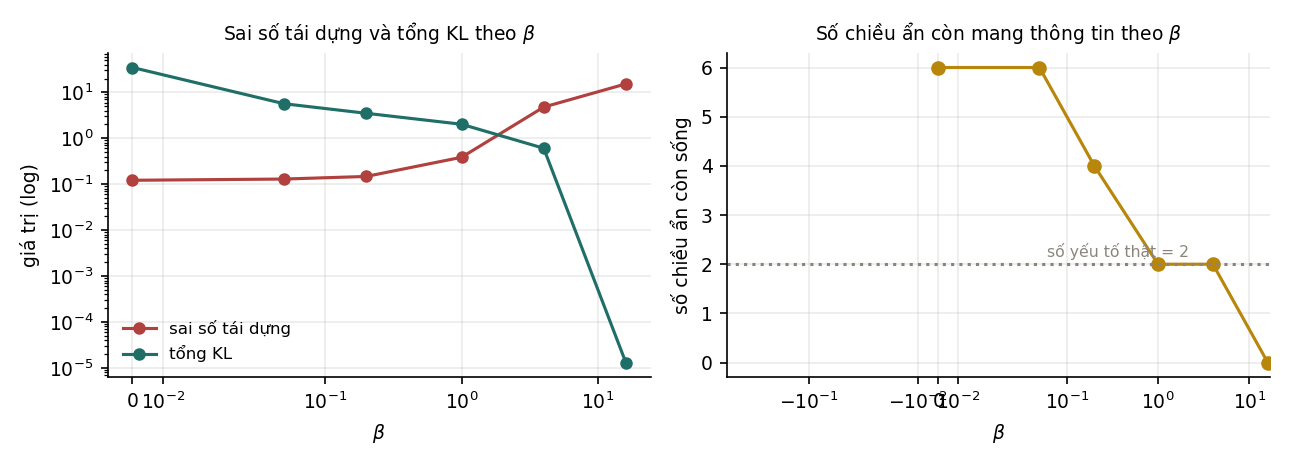
| Sai số tái dựng | Tổng KL | Số chiều mang thông tin | KL của từng chiều | |
|---|---|---|---|---|
| 0 | 0,1219 | 34,79 | 6 | 14,66 · 15,03 · 0,27 · 2,70 · 0,41 · 1,72 |
| 0,05 | 0,1296 | 5,66 | 6 | 2,57 · 2,60 · 0,09 · 0,16 · 0,10 · 0,13 |
| 0,2 | 0,1476 | 3,50 | 4 | 1,73 · 1,74 · 0,006 · 0,017 · 0,006 · 0,011 |
| 1 | 0,3861 | 2,02 | 2 | 1,015 · 1,006 · 0 · 0 · 0 · 0 |
| 4 | 4,78 | 0,61 | 2 | 0,36 · 0,007 · 0 · 0,24 · 0 · 0 |
| 16 | 15,28 | 0 | 0 | 0 · 0 · 0 · 0 · 0 · 0 |
Ba hàng , và cho thấy rõ cơ chế. Ở , cả 6 chiều đều mang thông tin. Không có ràng buộc nào kéo hậu nghiệm về tiên nghiệm, nên mô hình dùng mọi chiều được cho. Đây là bộ tự mã hoá thường ở Mục 9.1: tái dựng tốt nhất (0,1219) nhưng không gian ẩn không có cấu trúc để lấy mẫu.
Ở , đúng 2 chiều mang thông tin, bằng số yếu tố thật sinh ra dữ liệu, còn bốn chiều thừa có KL bằng 0. Số hạng KL đã hoạt động như một cơ chế tự chọn số chiều: mỗi chiều mang thông tin phải trả một "chi phí" KL, và chỉ những chiều giảm sai số tái dựng nhiều hơn chi phí đó mới được giữ lại.
Ở , không chiều nào mang thông tin. Đây là hiện tượng sụp hậu nghiệm (posterior collapse): không còn liên quan tới , và bộ giải mã chỉ dự đoán được giá trị trung bình của dữ liệu. Sai số tái dựng tăng lên 15,28, gấp khoảng 125 lần so với . Sụp hậu nghiệm cũng gặp khi bộ giải mã quá mạnh, ví dụ một mô hình tự hồi quy, vì khi đó bộ giải mã tự mô hình hoá được dữ liệu mà không cần (Bowman và cộng sự, 2016).
9.4Nguyên nhân mẫu của VAE bị mờ#
Với bộ giải mã Gauss, số hạng tái dựng là bình phương sai số (Mục 10.2 của Nền tảng), và hàm cực tiểu hoá kỳ vọng bình phương sai số là kỳ vọng có điều kiện:
Với ảnh, nếu cùng một ứng với nhiều ảnh thật khả dĩ, ví dụ cùng một khuôn mặt nhưng đường viền tóc lệch nhau vài điểm ảnh, thì trung bình của chúng là một ảnh nhoè ở các đường viền. Trung bình của nhiều ảnh sắc nét lệch nhau không phải một ảnh sắc nét. Lấy hai "ảnh" một chiều bốn điểm ảnh, và , cùng ứng với một với xác suất như nhau: cùng một cạnh, lệch nhau một điểm ảnh. Dự đoán tối ưu theo bình phương sai số là trung bình của chúng, , có một điểm ảnh xám không xuất hiện trong ảnh thật nào. Sai số kỳ vọng của nó là , trong khi dự đoán bằng một trong hai ảnh sắc nét có sai số kỳ vọng . Hàm mất mát bình phương vì vậy thưởng cho ảnh mờ. Độ mờ vì vậy không chủ yếu do mô hình thiếu dung lượng hay huấn luyện chưa đủ; nó đến từ việc chọn hàm mất mát bình phương, tức giả định nhiễu Gauss độc lập trên từng điểm ảnh. Đổi hàm mất mát thì đổi hiện tượng, và đó là điều GAN làm: thay hàm mất mát viết sẵn bằng một hàm mất mát học được.
9.5Tóm tắt#
Bộ tự mã hoá không sinh được mẫu vì không gian ẩn của nó không có cấu trúc để lấy mẫu. VAE xem là biến ẩn có tiên nghiệm và tối đa ELBO, một chặn dưới của log hợp lý gồm số hạng tái dựng và số hạng KL kéo hậu nghiệm về tiên nghiệm; mẹo tái tham số hoá cho phép huấn luyện bằng gradient descent. Thí nghiệm với dữ liệu sinh từ 2 yếu tố cho thấy quyết định số chiều ẩn còn mang thông tin: 6 chiều ở , đúng 2 chiều ở , và không chiều nào ở , khi hậu nghiệm sụp. Mẫu của VAE mờ vì hàm mất mát bình phương có nghiệm tối ưu là trung bình có điều kiện của nhiều ảnh sắc nét.
Nếu độ mờ đến từ một hàm mất mát viết sẵn, hướng sửa tự nhiên là để mô hình tự học hàm mất mát. Chương 10 trình bày GAN, mô hình làm đúng điều đó bằng một mạng thứ hai.
Tự kiểm tra
4 câu. Chọn đáp án để xem ngay lời giải thích.
1Trong thí nghiệm ở Mục 9.3, hệ số của VAE quyết định điều gì?
Vì sao: Dữ liệu sinh từ đúng 2 yếu tố, và với VAE giữ đúng 2 chiều mang thông tin; mỗi chiều phải "trả" một chi phí KL, và chỉ những chiều giảm sai số tái dựng đủ nhiều mới được giữ.2Sụp hậu nghiệm là gì?
Vì sao: Ở , mọi chiều có KL bằng 0 và sai số tái dựng tăng lên 15,28, gấp khoảng 125 lần so với . Hiện tượng này cũng gặp khi bộ giải mã quá mạnh.3Vì sao mẫu của VAE thường mờ?
Vì sao: Trung bình của nhiều ảnh sắc nét lệch nhau vài điểm ảnh là một ảnh nhoè ở các đường viền. Độ mờ là hệ quả của lựa chọn hàm mất mát.4Mẹo tái tham số hoá dùng để làm gì?
Vì sao: Đây là kỹ thuật cài đặt để huấn luyện VAE bằng gradient descent, không phải ý tưởng chính của VAE.
Đã trả lời 0/4