2Word2Vec#
Câu hỏi đầu tiên ở Chương 1 là gán cho mỗi từ một vector sao cho các từ gần nghĩa có vector gần nhau. Ta đi tới câu trả lời qua ba bước: đếm số lần các từ cùng xuất hiện, chuyển số đếm thành thông tin tương hỗ điểm (PMI), rồi nén ma trận PMI thành các vector ngắn. Word2Vec làm cùng việc đó mà không cần lập ma trận, và Levy và Goldberg (2014) chứng minh rằng nó thực chất đang phân rã ma trận PMI. Một kho ngữ liệu nhân tạo nhỏ cho phép quan sát từng bước bằng số.
2.1Giả thuyết phân bố#
"Gần nghĩa" là khái niệm của con người, không đo trực tiếp được. Tín hiệu thay thế đến từ ngôn ngữ học: giả thuyết phân bố (distributional hypothesis; Harris, 1954; Firth, 1957) cho rằng các từ xuất hiện trong những ngữ cảnh giống nhau thường có nghĩa giống nhau. Nếu trong rất nhiều câu tiếng Việt, "mèo" và "chó" cùng thường đi với "nuôi", "thú cưng", "cho ăn", thì hai từ này có điểm chung, và điểm chung đó đo được qua thống kê.
Như vậy một câu hỏi không đo được ("hai từ này có gần nghĩa không?") được thay bằng một câu hỏi đo được ("hai từ này có xuất hiện trong những ngữ cảnh giống nhau không?"). Sự thay thế không hoàn hảo: hai từ trái nghĩa như "tốt" và "xấu" xuất hiện trong ngữ cảnh gần như giống hệt nhau, nên sẽ có vector gần nhau. Nhưng nó đủ tốt để làm nền cho hầu hết các phương pháp biểu diễn văn bản về sau.
2.2Kho ngữ liệu thí nghiệm#
Để quan sát cơ chế một cách rõ ràng, thí nghiệm trong code/bieudien/experiments.py dùng một kho ngữ liệu nhân tạo nhỏ nhưng có cấu trúc. Từ vựng có 20 từ, mỗi từ là một cặp (chủ đề, vai trò) với 5 chủ đề và 4 vai trò, đặt tên như vua_nam, mua_nho, cay_lon. Kho gồm 40 000 câu, mỗi câu 3 từ. Một nửa số câu gồm các từ cùng chủ đề, ví dụ vua_nam vua_nho vua_lon; nửa còn lại gồm các từ cùng vai trò, ví dụ vua_nam mua_nam cay_nam.
Không câu nào cho biết có hai trục "chủ đề" và "vai trò", và không có nhãn nào; dữ liệu chỉ là các dãy từ. Nếu embedding học được tách hai trục thành hai hướng cộng được với nhau, đó là điều mô hình tự rút ra từ thống kê.
2.3Số lần đồng hiện và PMI#
Đếm số lần mỗi cặp từ cùng xuất hiện trong một câu cho ma trận đồng hiện . Số đếm thô có một nhược điểm: một từ rất phổ biến như "của" đồng hiện với hầu hết các từ, không phải vì liên quan mà vì phổ biến. Thứ cần đo là hai từ cùng xuất hiện nhiều hơn bao nhiêu so với mức kỳ vọng nếu chúng độc lập.
Định nghĩa 2.1 (Thông tin tương hỗ điểm)
Với là xác suất cặp cùng xuất hiện và , là các xác suất biên,
PMI dương nghĩa là hai từ cùng xuất hiện nhiều hơn mức ngẫu nhiên, bằng 0 nghĩa là đúng mức ngẫu nhiên, âm nghĩa là ít hơn. PPMI (positive PMI) là PMI với các giá trị âm thay bằng 0.
Tử số là xác suất quan sát được; mẫu số là xác suất nếu hai từ độc lập. Trong kho ngữ liệu thí nghiệm, PMI chỉ có ba giá trị:
| Cặp từ | PMI |
|---|---|
Cùng chủ đề, khác vai trò (vua_nam, vua_nu) |
|
Cùng vai trò, khác chủ đề (vua_nam, mua_nam) |
|
Khác cả chủ đề lẫn vai trò (vua_nam, mua_nu) |
Hai từ có chung một thuộc tính thì PMI dương; không có thuộc tính chung thì cùng xuất hiện đúng mức ngẫu nhiên. Cấu trúc hai trục của dữ liệu đã nằm sẵn trong ma trận PMI trước khi học bất cứ điều gì.
2.4Nén ma trận PPMI bằng SVD#
Ma trận PMI có phần tử. Với từ vựng thật cỡ 400 000 từ, đó là 160 tỉ phần tử, phần lớn bằng 0. Cần một biểu diễn ngắn và dày: mỗi từ một vector vài trăm chiều. Cách làm là xấp xỉ hạng thấp bằng SVD (Chương 14 của Nền tảng): với , giữ giá trị suy biến lớn nhất và đặt embedding của các từ là các hàng của . PPMI được dùng thay cho PMI vì các giá trị PMI âm ước lượng rất kém: chúng đòi hỏi đếm chính xác những cặp từ hiếm khi đi cùng nhau.
Chất lượng embedding được kiểm tra bằng phép loại suy dạng , tìm từ có vector gần nhất với theo cosine, loại trừ ba từ đã cho. Với :
vua_nam : vua_nu :: mua_nho : ?  ->  mua_nu
Do chinh xac tren 240 phep loai suy: 1.0000   (doan ngau nhien: 0.0588)
Cả 240 phép loại suy đều đúng. Vector , tức "đổi vai trò từ nam sang nữ", cộng vào mua_nho cho đúng mua_nu. Hai trục đã được tách thành hai hướng cộng được, dù dữ liệu không hề nói có hai trục.
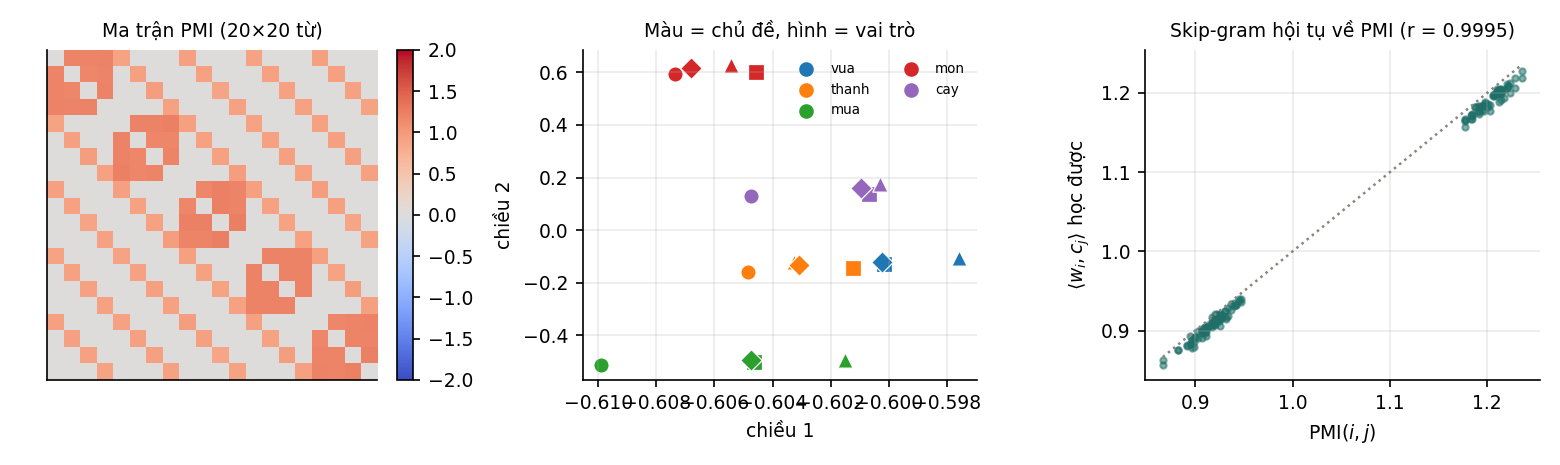
Ta có thể nghĩ giữ càng nhiều chiều thì embedding càng tốt, nhưng độ chính xác không tăng đều theo số chiều giữ lại:
| Số chiều | 2 | 4 | 6 | 8 | 12 | 16 | 20 |
|---|---|---|---|---|---|---|---|
| Độ chính xác loại suy | 0,479 | 0,788 | 0,875 | 1,000 | 0,588 | 0,250 | 1,000 |
Giải thích nằm ở phổ của ma trận. Ma trận PPMI ở đây có đúng 8 trị riêng dương (7,28; 2,73; 2,70; 2,68; 2,68; 2,49; 2,46; 2,43) và 12 trị riêng âm có độ lớn gần bằng nhau, từ tới . Tám trị riêng dương ứng với cấu trúc hai trục: một hướng chung cho mọi từ, 4 hướng cho sự khác biệt giữa 5 chủ đề và 3 hướng cho sự khác biệt giữa 4 vai trò, tổng cộng . Mười hai trị riêng âm sinh ra vì đường chéo của ma trận bằng 0: một từ không bao giờ đồng hiện với chính nó. SVD cho giá trị suy biến bằng giá trị tuyệt đối của trị riêng và không phân biệt dấu, nên khi giữ 12 hoặc 16 chiều, embedding lấy thêm một phần các hướng ứng với trị riêng âm và coi chúng như hướng mang thông tin, làm sai lệch hình học. Giữ đủ 20 chiều thì ma trận được tái tạo chính xác và phép loại suy lại đúng hết.
Lưu ý
Trên kho ngữ liệu thật, không có ranh giới rõ ràng như vậy giữa phần cấu trúc và phần còn lại, và số chiều được chọn bằng thực nghiệm trên các nhiệm vụ đánh giá. Ví dụ này không cho thấy "đường cong đánh đổi" điển hình theo số chiều; nó cho thấy số chiều tốt nhất phụ thuộc vào cấu trúc phổ của ma trận, và giữ thêm chiều không phải lúc nào cũng có lợi.
2.5Skip-gram và lấy mẫu âm#
SVD ở Mục 2.4 cần lập toàn bộ ma trận PPMI, và với từ vựng thật ma trận đó quá lớn. Word2Vec (Mikolov và cộng sự, 2013) tránh việc này bằng cách xử lý từng cặp quan sát được bằng gradient descent. Mô hình skip-gram gán cho mỗi từ hai vector, khi là từ trung tâm và khi là từ ngữ cảnh, và mô hình hoá
Mẫu số là tổng trên toàn bộ từ vựng, tính lại cho mỗi cặp huấn luyện. Với vector 300 chiều, tính softmax đầy đủ và gradient của nó tốn cỡ phép tính mỗi cặp:
| Từ vựng | Softmax đầy đủ | Lấy mẫu âm, | Tỉ lệ |
|---|---|---|---|
| 1 000 | 600 000 | 3 600 | 167 |
| 50 000 | 30 000 000 | 3 600 | 8 333 |
| 400 000 | 240 000 000 | 3 600 | 66 667 |
| 2 000 000 | 1 200 000 000 | 3 600 | 333 333 |
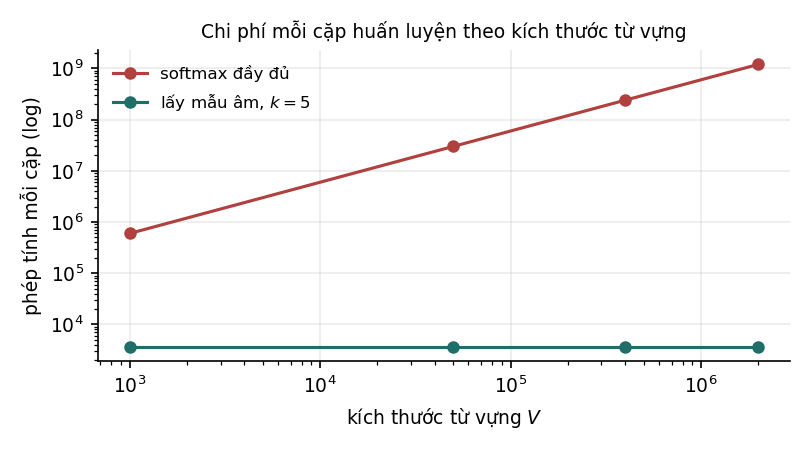
Lấy mẫu âm (negative sampling) thay bài toán "chọn đúng 1 trong từ" bằng bài toán phân loại nhị phân: cặp quan sát được có phải cặp thật không, và cặp ghép ngẫu nhiên có phải cặp thật không. Hàm mục tiêu cho mỗi cặp là
với là phân phối để rút từ ngẫu nhiên. Chi phí mỗi cặp không còn phụ thuộc vào , nhờ vậy word2vec huấn luyện được trên kho hàng tỉ từ ngay từ năm 2013. Trong bài báo gốc, tỉ lệ với tần suất của từ mũ ; số mũ này được chọn bằng thực nghiệm.
2.6Skip-gram phân rã ma trận PMI#
Đến đây có hai cách tạo embedding trông rất khác nhau: một cách đếm rồi phân rã ma trận, một cách huấn luyện bằng gradient descent trên từng cặp từ. Định lý sau cho thấy chúng nhắm tới cùng một ma trận.
Định lý 2.1 (Levy và Goldberg, 2014)
Nếu các vector đủ nhiều chiều để mọi tích vô hướng nhận giá trị tuỳ ý, thì điểm tối ưu của skip-gram với lấy mẫu âm, với mẫu âm rút từ phân phối unigram, thoả
Chứng minh
Với là tổng số cặp, cặp xuất hiện lần như cặp thật và, theo kỳ vọng, lần như cặp âm. Phần hàm mục tiêu phụ thuộc là
Dùng và , cho đạo hàm bằng 0:
Thay được .
Như vậy skip-gram với lấy mẫu âm là một cách phân rã ma trận PMI (dịch đi ) mà không cần lập ma trận: mỗi bước gradient chỉ chạm vào một cặp quan sát được và vài cặp ngẫu nhiên. Mô hình cũng không phải mạng nơ-ron sâu như tên gọi thường gợi ý: nó chỉ có một lớp, không có hàm phi tuyến ở giữa.
Định lý kiểm chứng được bằng số. Thí nghiệm tối ưu hàm mục tiêu kỳ vọng của skip-gram bằng gradient descent, với (để đích đúng bằng PMI) và phân phối unigram, rồi so tích vô hướng học được với PMI trên các cặp có đồng hiện:
| Số chiều | Tương quan với PMI | Sai lệch tuyệt đối trung bình | Sai lệch lớn nhất |
|---|---|---|---|
| 8 (hạng thấp) | 0,3727 | 0,2862 | 1,0566 |
| 20 (hạng đầy đủ) | 0,9995 | 0,0106 | 0,0251 |
Ở hạng đầy đủ, gradient descent hội tụ về đúng ma trận PMI, khớp Định lý 2.1: một bên là công thức giải tích, một bên là 4 000 vòng lặp tối ưu, cho cùng một ma trận.
Ở hạng thấp, mô hình không khớp chính xác được và phải chọn giữ lại phần nào của ma trận. Sự lựa chọn này khác với SVD. SVD cho xấp xỉ tốt nhất theo tổng bình phương sai số với trọng số như nhau cho mọi phần tử; skip-gram cho một xấp xỉ có trọng số theo tần suất của các cặp, và dùng hai bộ vector riêng cho từ và ngữ cảnh. Trên kho ngữ liệu này, embedding skip-gram hạng 8 (lấy các vector từ ) chỉ giải đúng 20,4% phép loại suy, so với 100% của SVD trên PPMI cùng số chiều. Kết quả không có nghĩa skip-gram kém hơn nói chung: Levy, Goldberg và Dagan (2015) so sánh trên dữ liệu thật và kết luận rằng khác biệt giữa các phương pháp phụ thuộc vào siêu tham số và cách xử lý dữ liệu nhiều hơn vào bản thân thuật toán. Điều ví dụ cho thấy là hai phương pháp cùng nhắm tới một ma trận vẫn có thể cho embedding rất khác nhau khi bị giới hạn số chiều.
2.7Các hiểu lầm thường gặp#
Word2Vec thường được giới thiệu như một thành tựu của học sâu, và cách giới thiệu đó để lại khá nhiều hiểu lầm. Bảng dưới đối chiếu những hiểu lầm hay gặp với điều các mục trên đã chỉ ra.
| Phát biểu | Thực tế |
|---|---|
| "Word2Vec là học sâu." | Mô hình chỉ có một lớp tuyến tính; về bản chất là phân rã ma trận. |
| "Lấy mẫu âm là phép xấp xỉ của softmax." | Không hẳn: đó là một hàm mục tiêu khác, có nghiệm là PMI dịch , không phải nghiệm của softmax đầy đủ. |
| "Embedding hiểu nghĩa của từ." | Embedding chỉ nắm thống kê đồng hiện, nên không phân biệt được các từ trái nghĩa xuất hiện trong ngữ cảnh giống nhau. |
| "Vector cộng trừ được nên mô hình biết suy luận." | Tính cộng được đến từ cấu trúc của ma trận PMI. Trên dữ liệu thật, nó đúng với một số quan hệ và sai với nhiều quan hệ khác. |
| "Số mũ 3/4 trong phân phối lấy mẫu âm có cơ sở lý thuyết." | Bài báo gốc chọn số mũ này bằng thực nghiệm. |
2.8Tóm tắt#
Embedding từ dựa trên giả thuyết phân bố: hai từ xuất hiện trong những ngữ cảnh giống nhau thường gần nghĩa. Đếm số lần đồng hiện, chuyển sang PMI để loại ảnh hưởng của tần suất, rồi nén ma trận PPMI bằng SVD đã cho embedding giải đúng cả 240 phép loại suy trên kho ngữ liệu thí nghiệm. Số chiều tốt nhất không phải số chiều lớn nhất mà do phổ của ma trận quyết định. Word2Vec với lấy mẫu âm làm cùng việc mà không lập ma trận, và chi phí mỗi cặp huấn luyện không phụ thuộc kích thước từ vựng. Ở điểm tối ưu, tích vô hướng của nó bằng PMI dịch đi ; ở hạng đầy đủ, thí nghiệm cho tương quan 0,9995 giữa hai đại lượng.
Có embedding rồi, việc tiếp theo là so sánh chúng, và cách so sánh mặc định là cosine. Chương 3 cho thấy cosine có thể cho con số rất cao giữa hai vector không liên quan gì tới nhau, khi đám mây embedding không nằm quanh gốc toạ độ.
Tự kiểm tra
6 câu. Chọn đáp án để xem ngay lời giải thích.
1Skip-gram với lấy mẫu âm thực chất phân rã ma trận nào?
Vì sao: Kết quả của Levy và Goldberg (2014): cho đạo hàm của hàm mục tiêu kỳ vọng bằng 0 được . Ở Mục 2.6, với hạng đầy đủ, tích vô hướng học được có tương quan 0,9995 với PMI.2Vì sao dùng PMI thay cho số lần đồng hiện thô?
Vì sao: Một từ như "của" đồng hiện với hầu hết các từ vì nó phổ biến, không vì nó liên quan. Mẫu số của PMI là xác suất đồng hiện nếu hai từ độc lập, nên tỉ số đo phần vượt mức ngẫu nhiên.3Lấy mẫu âm giải quyết vấn đề gì?
Vì sao: Với từ vựng 2 triệu từ và vector 300 chiều, softmax đầy đủ tốn khoảng 1,2 tỉ phép tính mỗi cặp, lấy mẫu âm với tốn 3 600. Chi phí của lấy mẫu âm không phụ thuộc kích thước từ vựng.4Trong thí nghiệm ở Mục 2.6, embedding skip-gram hạng 8 giải đúng bao nhiêu phép loại suy, so với SVD trên PPMI cùng số chiều?
Vì sao: Hai phương pháp nhắm tới cùng một ma trận đích nhưng xấp xỉ khác nhau khi bị giới hạn số chiều: SVD cho xấp xỉ tốt nhất với trọng số như nhau cho mọi phần tử, skip-gram cho xấp xỉ có trọng số theo tần suất và dùng hai bộ vector. Trên dữ liệu thật, khác biệt giữa các phương pháp phụ thuộc nhiều vào siêu tham số (Levy, Goldberg và Dagan, 2015).5Vì sao độ chính xác loại suy của SVD giảm khi giữ 12 hoặc 16 chiều, rồi lại đạt 100% ở 20 chiều?
Vì sao: Tám trị riêng dương ứng với cấu trúc hai trục của dữ liệu (); mười hai trị riêng âm sinh ra vì đường chéo của ma trận bằng 0. Giữ đủ 20 chiều thì ma trận được tái tạo chính xác (Mục 2.4).6Số mũ 3/4 trong phân phối lấy mẫu âm có cơ sở gì?
Vì sao: Số mũ 3/4 cho kết quả tốt hơn số mũ 1 (phân phối unigram) và số mũ 0 (phân phối đều) trong thí nghiệm của Mikolov và cộng sự (2013); không có lý thuyết nào dẫn tới con số này.
Đã trả lời 0/6