7LoRA và tinh chỉnh tiết kiệm tham số#
Tinh chỉnh toàn phần cho kết quả tốt nhất khi có đủ dữ liệu (Chương 6), nhưng đòi hỏi bộ nhớ rất lớn và tạo ra một bản sao đầy đủ của mô hình cho mỗi nhiệm vụ. LoRA (Hu và cộng sự, 2022) giải quyết cả hai vấn đề bằng cách giữ nguyên trọng số gốc và chỉ học một phần cộng thêm có hạng thấp. Muốn thấy LoRA tiết kiệm được bao nhiêu, trước hết cần tính tinh chỉnh toàn phần tốn bao nhiêu.
7.1Chi phí bộ nhớ của tinh chỉnh toàn phần#
Xét Llama 2 7B với 6 476 005 376 tham số không tính embedding (Chương 12 của Học sâu). Tinh chỉnh toàn phần bằng Adam với mọi đại lượng lưu ở FP32 cần:
| Thành phần | Dung lượng |
|---|---|
| Trọng số | 24,1 GiB |
| Gradient | 24,1 GiB |
| Trạng thái Adam ( và ) | 48,2 GiB |
| Tổng, chưa tính giá trị kích hoạt | 96,4 GiB |
Một GPU 80 GB không đủ, và đây mới là mô hình nhỏ nhất trong họ Llama 2. Huấn luyện với độ chính xác hỗn hợp cần khoảng 16 byte mỗi tham số (Mục 12.5 của Học sâu), tức khoảng 108 GB cho 6,74 tỉ tham số của cả mô hình, vẫn không vừa.
Vấn đề thứ hai là lưu trữ và phục vụ. Nếu 50 khách hàng, mỗi người cần một phiên bản tinh chỉnh riêng, thì phải lưu 50 bản sao đầy đủ của mô hình 13 GB (ở FP16), tức 650 GB, và mỗi bản sao cần bộ nhớ GPU riêng khi phục vụ.
7.2Ý tưởng và giả định#
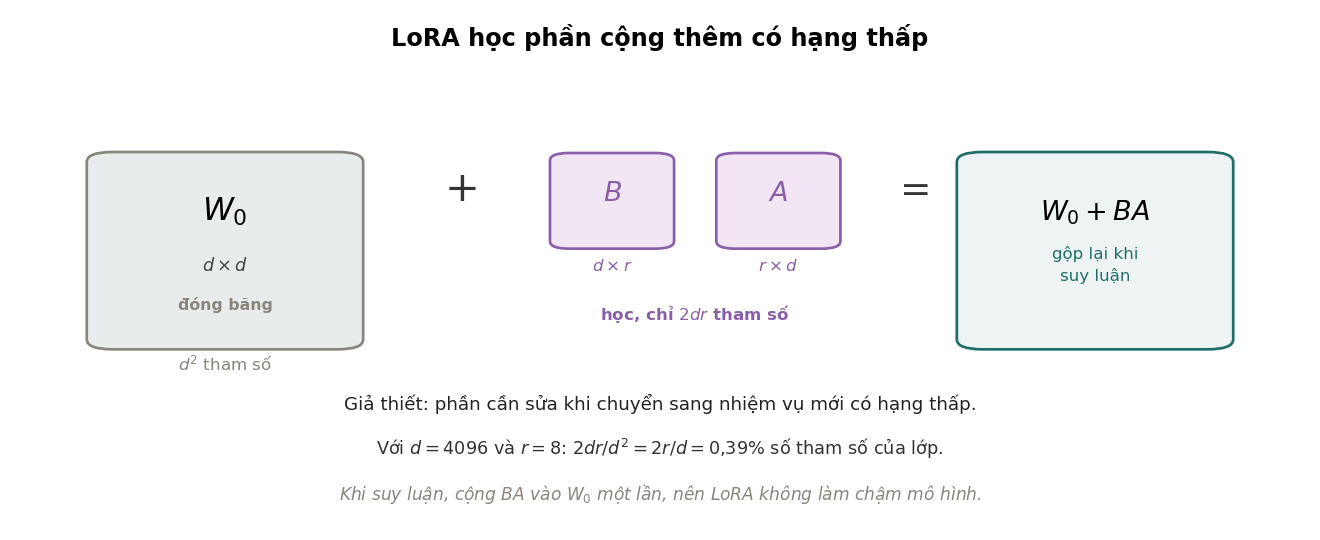
Định nghĩa 7.1 (LoRA)
Với một ma trận trọng số đã tiền huấn luyện, LoRA đóng băng và học
với hạng . Khi huấn luyện, đầu ra của lớp là ; chỉ và được cập nhật.
LoRA dựa trên một giả định, và giả định đó có thể sai: phần cần thay đổi khi chuyển sang nhiệm vụ mới có hạng thấp. Mô hình gốc đã đúng gần hết; phần cần điều chỉnh nằm trong một không gian con ít chiều. Có lý do để tin giả định này: nhiệm vụ đích thường chỉ đòi mô hình nhấn mạnh lại những gì nó đã biết, như một văn phong, một định dạng đầu ra hay một miền kiến thức, chứ không đòi học lại ngôn ngữ. Aghajanyan, Zettlemoyer và Gupta (2021) cũng cho thấy các mô hình tiền huấn luyện có "số chiều nội tại" thấp khi tinh chỉnh: tối ưu trong một không gian con ngẫu nhiên vài trăm chiều đã đạt phần lớn hiệu quả của tinh chỉnh toàn phần.
Có một chi tiết cài đặt cần biết: được khởi tạo ngẫu nhiên còn . Khi đó lúc bắt đầu, và mô hình khởi đầu đúng bằng mô hình gốc rồi thay đổi dần. Nếu khởi tạo cả hai ngẫu nhiên, ngay bước đầu mô hình đã bị cộng một nhiễu ngẫu nhiên. Trong bài báo gốc, còn được nhân với hệ số để có thể đổi mà không phải chỉnh lại tốc độ học.
7.3Số tham số#
Một ma trận có tham số; LoRA hạng có . Tỉ lệ là
giảm khi tăng: mô hình càng lớn, LoRA càng tiết kiệm.
| Mô hình | Ma trận đầy đủ | LoRA | LoRA | Tỉ lệ với | |
|---|---|---|---|---|---|
| GPT-2 small | 768 | 589 824 | 12 288 | 98 304 | 2,083% |
| GPT-2 large | 1 280 | 1 638 400 | 20 480 | 163 840 | 1,250% |
| Llama 2 7B | 4 096 | 16 777 216 | 65 536 | 524 288 | 0,391% |
| Llama 2 70B | 8 192 | 67 108 864 | 131 072 | 1 048 576 | 0,195% |
Bài báo gốc gắn LoRA vào và của mọi lớp attention; lựa chọn này đến từ thử nghiệm nhiều tổ hợp, không từ lý thuyết. Với Llama 2 7B (32 lớp), số tham số huấn luyện là :
| Hạng | Tham số huấn luyện | Tỉ lệ so với mô hình |
|---|---|---|
| 4 | 2 097 152 | 0,0324% |
| 8 | 4 194 304 | 0,0648% |
| 16 | 8 388 608 | 0,1295% |
| 64 | 33 554 432 | 0,5181% |
Với , trạng thái Adam ở FP32 chỉ còn byte, tức 32 MiB, so với 48,2 GiB khi tinh chỉnh toàn phần: nhỏ hơn khoảng 1 540 lần. Trọng số gốc vẫn phải nằm trong bộ nhớ, nhưng chỉ ở dạng đọc (13,5 GB ở FP16), và không cần gradient cho chúng. Đó là khác biệt giữa huấn luyện được trên một GPU và cần một cụm máy.
Thực tế về sau cho thấy gắn LoRA vào mọi ma trận tuyến tính, cả attention lẫn FFN, thường cho chất lượng tốt hơn chỉ gắn vào và với cùng số tham số (Dettmers và cộng sự, 2023), nên nhiều thư viện hiện nay mặc định như vậy.
7.4Các hiểu lầm thường gặp#
Quanh LoRA có ba hiểu lầm hay gặp. Hiểu lầm thứ nhất là LoRA làm mô hình chạy nhanh hơn khi suy luận. Thực tế, khi suy luận có thể cộng vào một lần rồi dùng ma trận đã gộp, nên tốc độ bằng đúng mô hình gốc; nếu không gộp, để đổi adapter nhanh giữa các yêu cầu, thì còn chậm hơn một chút vì có thêm hai phép nhân nhỏ. LoRA tiết kiệm bộ nhớ khi huấn luyện và dung lượng lưu trữ, không tiết kiệm thời gian suy luận.
Hiểu lầm thứ hai là LoRA luôn cho chất lượng bằng tinh chỉnh toàn phần. Bài báo gốc cho kết quả rất gần trên các nhiệm vụ được thử. Nhưng với nhiệm vụ đòi mô hình học kiến thức thật sự mới, chứ không chỉ đổi văn phong hay định dạng, giả định hạng thấp yếu đi và khoảng cách có thể rộng ra (Biderman và cộng sự, 2024).
Hiểu lầm thứ ba là hạng càng cao càng tốt. Hạng cao hơn nghĩa là nhiều tham số hơn, tức phương sai lớn hơn với cùng lượng dữ liệu (Chương 2 của Học sâu). Với ít dữ liệu, hoặc thường đủ, và hạng nên được chọn bằng tập xác thực.
7.5Lợi ích khi phục vụ nhiều mô hình#
Trở lại bài toán 50 khách hàng ở Mục 7.1. Với tinh chỉnh toàn phần, 50 khách hàng cần 50 bản sao 13 GB, tức 650 GB. Với LoRA , cần một bản gốc 13 GB cộng 50 adapter, mỗi adapter khoảng 16 MB ở FP32, tổng cộng khoảng 13,8 GB.
Vì mọi adapter dùng chung trọng số gốc, có thể giữ mô hình gốc trên GPU và chọn adapter theo từng yêu cầu, nên một GPU phục vụ được nhiều khách hàng cùng lúc. Các máy chủ suy luận như vLLM hỗ trợ trực tiếp cách phục vụ này. Lợi ích này độc lập với việc tiết kiệm bộ nhớ khi huấn luyện, và là một lý do chính khiến LoRA được dùng rộng rãi trong sản phẩm.
7.6Các phương pháp liên quan#
LoRA không phải cách duy nhất để tinh chỉnh với ít tham số. Bảng dưới đặt nó cạnh các phương pháp cùng họ.
| Phương pháp | Cách làm | Ghi chú |
|---|---|---|
| Adapter (Houlsby và cộng sự, 2019) | chèn các lớp nhỏ mới vào giữa các lớp của mô hình | có trước LoRA; tăng độ trễ vì không gộp vào trọng số gốc được |
| Prefix tuning, prompt tuning (Li và Liang, 2021; Lester, Al-Rfou và Constant, 2021) | học một số vector "token ảo" đặt trước đầu vào | rất ít tham số; chiếm một phần ngữ cảnh; khó huấn luyện hơn |
| BitFit (Ben Zaken, Ravfogel và Goldberg, 2022) | chỉ tinh chỉnh các hệ số chặn | cực ít tham số; đủ cho nhiệm vụ đơn giản |
| QLoRA (Dettmers và cộng sự, 2023) | LoRA trên mô hình gốc đã lượng tử hoá 4 bit | giảm tiếp bộ nhớ của phần đóng băng; xem Chương 11 của Quantization |
QLoRA hoạt động được vì mô hình gốc chỉ được đọc, không được cập nhật: lượng tử hoá nó làm giảm bộ nhớ của phần đóng băng mà không cản trở việc huấn luyện adapter, vốn vẫn ở độ chính xác cao. Hai kỹ thuật kết hợp được vì chúng tác động lên hai phần khác nhau của bộ nhớ. Với QLoRA, tinh chỉnh một mô hình 65 tỉ tham số vừa một GPU 48 GB.
7.7Tóm tắt#
Tinh chỉnh toàn phần Llama 2 7B bằng Adam ở FP32 cần 96,4 GiB chưa tính giá trị kích hoạt, và mỗi nhiệm vụ cần một bản sao đầy đủ của mô hình. LoRA đóng băng trọng số gốc và chỉ học phần cộng thêm có hạng , dựa trên giả định phần cần thay đổi nằm trong một không gian con ít chiều. Tỉ lệ tham số giảm khi mô hình lớn lên; với Llama 2 7B và trên , , trạng thái Adam chỉ còn 32 MiB. LoRA không làm suy luận nhanh hơn, nhưng cho phép một mô hình gốc phục vụ nhiều adapter, và kết hợp được với lượng tử hoá trong QLoRA.
Đến đây, mô hình mới được dùng để biểu diễn và phân loại. Một mô hình ngôn ngữ còn làm một việc khác hẳn: sinh ra văn bản mới. Chương 8 xét bài toán sinh nói chung và lý do bài toán này khó hơn phân loại nhiều.
Tự kiểm tra
4 câu. Chọn đáp án để xem ngay lời giải thích.
1LoRA tiết kiệm điều gì?
Vì sao: Khi suy luận, được gộp vào nên tốc độ bằng mô hình gốc. Với Llama 2 7B, trạng thái Adam giảm từ 48,2 GiB xuống 32 MiB với .2LoRA dựa trên giả định nào?
Vì sao: Mô hình gốc đã đúng gần hết; phần cần điều chỉnh nằm trong một không gian con ít chiều. Giả định này yếu đi khi nhiệm vụ đòi học kiến thức thật sự mới.3Vì sao LoRA khởi tạo ?
Vì sao: Nếu khởi tạo cả và ngẫu nhiên, ngay từ bước đầu mô hình đã bị cộng một nhiễu ngẫu nhiên vào trọng số.4Với một ma trận , tỉ lệ số tham số của LoRA hạng so với tinh chỉnh toàn phần là bao nhiêu?
Vì sao: LoRA có tham số so với . Tỉ lệ giảm khi tăng: 2,08% với GPT-2 small, 0,39% với một lớp của Llama 2 7B khi .
Đã trả lời 0/4