5Tiền huấn luyện#
Mọi mô hình embedding ở Chương 4 đều bắt đầu từ một mô hình đã tiền huấn luyện, tức một mô hình lớn được huấn luyện trên dữ liệu không nhãn trước khi dùng cho nhiệm vụ cụ thể. Đây cũng là bước đầu tiên của mọi mô hình ngôn ngữ lớn. Cách làm này hiệu quả vì một lý do kinh tế đơn giản, và vì nhiệm vụ huấn luyện trông rất hẹp, đoán token tiếp theo, lại buộc mô hình học được nhiều điều hơn hẳn những gì tên gọi của nó gợi ra.
5.1Dữ liệu có nhãn và dữ liệu không nhãn#
Dữ liệu có nhãn đắt: thuê người đọc và gán nhãn vài chục nghìn câu tốn nhiều tuần và nhiều tiền, và với những nhãn cần chuyên môn như y tế hay pháp lý thì còn đắt hơn. Dữ liệu không nhãn rẻ hơn rất nhiều: văn bản, ảnh, mã nguồn công khai có sẵn với khối lượng lớn hơn hàng triệu lần. Bất kỳ cách nào biến dữ liệu không nhãn thành thứ có ích đều có giá trị lớn.
Tiền huấn luyện làm điều đó bằng một nhiệm vụ mà nhãn tự sinh ra từ dữ liệu, gọi là học tự giám sát (self-supervised learning): che một từ rồi đoán lại nó, hoặc đoán từ tiếp theo từ các từ phía trước. Không ai phải gán nhãn, nhưng mô hình vẫn có tín hiệu để học trên mọi vị trí của mọi văn bản.
5.2Những gì mô hình học được khi dự đoán token tiếp theo#
Để đoán đúng token tiếp theo trong mọi ngữ cảnh, mô hình buộc phải học nhiều thứ khác. Muốn điền đúng "Thủ đô của Pháp là ___", nó phải biết sự kiện về thế giới. Với "Cô ấy mở tủ lạnh và lấy ra một chai ___", nó phải hiểu tình huống thực tế, tức trong tủ lạnh thường có gì. Câu "Mặc dù trời mưa rất to, anh ấy vẫn ___" đòi hỏi nắm quan hệ nhượng bộ trong ngữ pháp, "2 + 3 = ___" đòi hỏi làm được phép tính đơn giản, còn "def fibonacci(n): if n <= 1: return n; return fibonacci(n-1) + ___" đòi hỏi hiểu cấu trúc của mã nguồn.
Không kỹ năng nào trong số đó được dạy riêng. Mô hình học chúng vì không học thì không giảm được mất mát dự đoán token tiếp theo trên một kho văn bản đủ lớn và đủ đa dạng. Vì vậy dự đoán token tiếp theo là một nhiệm vụ đại diện rất rộng: nó không phải mục tiêu cuối cùng mà là cách buộc mô hình xây dựng biểu diễn hữu ích về ngôn ngữ và về thế giới được mô tả trong văn bản.
5.3Các cách tái sử dụng mô hình tiền huấn luyện#
Có một mô hình đã tiền huấn luyện, ta có bốn cách dùng nó cho nhiệm vụ của mình. Các cách này khác nhau ở phần nào của mô hình được cập nhật (Hình 5), và do đó ở số tham số phải học và lượng dữ liệu có nhãn cần có.
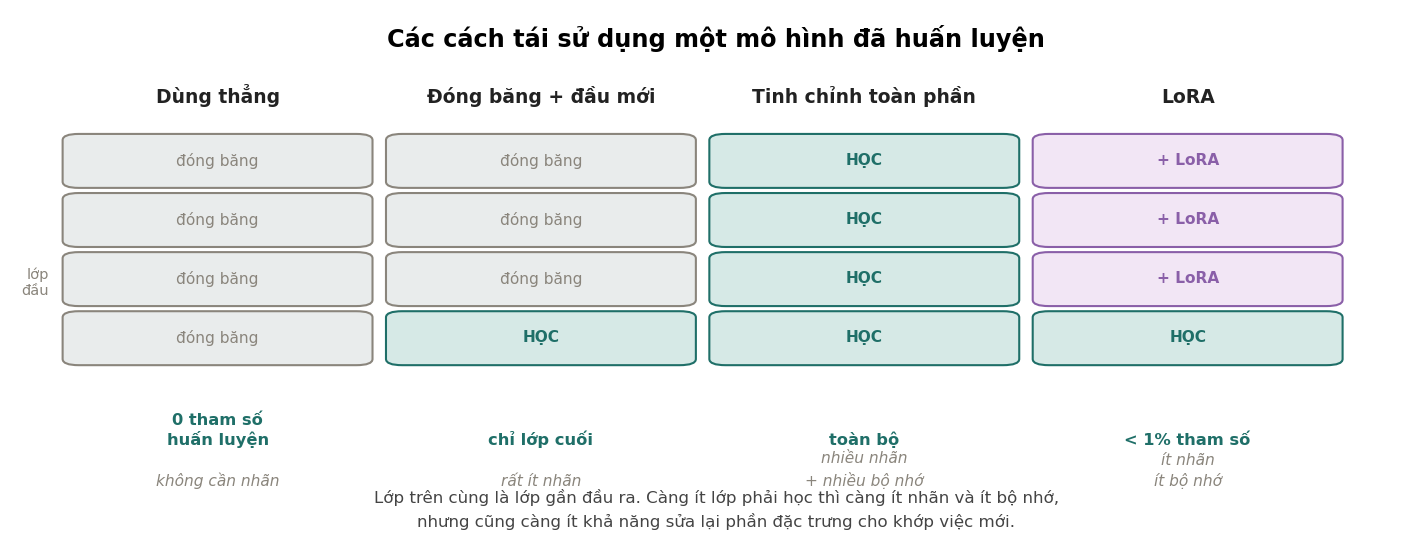
| Cách | Số tham số phải học | Lượng dữ liệu có nhãn cần | Khi nào dùng |
|---|---|---|---|
| Dùng trực tiếp, chỉ viết prompt | 0 | không cần, hoặc vài ví dụ trong prompt | nhiệm vụ nằm trong khả năng sẵn có của mô hình |
| Đóng băng, học thêm một lớp tuyến tính | chỉ lớp cuối | ít | ít nhãn; nhiều nhiệm vụ dùng chung một bộ đặc trưng |
| Tinh chỉnh toàn phần | toàn bộ | nhiều | nhiều nhãn và đủ bộ nhớ |
| LoRA và các phương pháp tương tự | dưới 1% | ít tới vừa phải | cần điều chỉnh sâu hơn một lớp tuyến tính nhưng bộ nhớ hạn chế |
Cách thứ hai còn gọi là linear probing: đặc trưng của mô hình được giữ nguyên và chỉ học một bộ phân loại tuyến tính trên đó. Câu hỏi thực tế là với bao nhiêu nhãn thì nên chuyển từ cách này sang cách khác. Chương 6 trả lời bằng số đo, Chương 7 trình bày LoRA, còn cách dùng mô hình qua prompt nằm ở Chương 3 và 4 của Ứng dụng LLM.
5.4Giới hạn của tiền huấn luyện#
Tiền huấn luyện không giúp được trong mọi trường hợp. Khi miền đích quá xa miền tiền huấn luyện, các đặc trưng học được không dùng lại được: một mô hình học trên văn bản web giúp được rất ít cho tín hiệu cảm biến công nghiệp. Khi nhiệm vụ đích cần kỹ năng mà nhiệm vụ tiền huấn luyện ít đòi hỏi, mô hình cũng yếu ở đó: mô hình ngôn ngữ thường giỏi ngữ pháp hơn số học nhiều chữ số, vì dự đoán token tiếp theo hiếm khi đòi hỏi tính toán chính xác.
Mô hình còn mang theo thiên kiến của dữ liệu. Nó học từ văn bản do người viết, nên học cả những định kiến trong đó, và tinh chỉnh có thể làm giảm nhưng không xoá hết các định kiến này. Công cụ để phát hiện vấn đề là đánh giá theo lát cắt (Mục 6.3 của MLOps) và kiểm thử phản thực tế (Mục 11.4 của Ứng dụng LLM).
5.5Tóm tắt#
Dữ liệu có nhãn đắt, còn dữ liệu không nhãn rẻ và có sẵn với khối lượng lớn hơn hàng triệu lần, nên một nhiệm vụ có nhãn tự sinh ra từ dữ liệu như đoán token tiếp theo có giá trị rất lớn. Nhiệm vụ đó buộc mô hình học sự kiện về thế giới, ngữ pháp, phép tính đơn giản và cấu trúc mã nguồn, vì thiếu chúng thì không đoán đúng được. Một mô hình đã tiền huấn luyện được dùng lại theo bốn cách: chỉ viết prompt, đóng băng và học một lớp tuyến tính, tinh chỉnh toàn phần, hoặc dùng LoRA. Tiền huấn luyện ít giúp ích khi miền đích quá xa hoặc khi nhiệm vụ cần kỹ năng hiếm gặp trong dữ liệu, và mô hình mang theo định kiến của dữ liệu.
Giữa các cách dùng lại, lựa chọn hay gặp nhất là đóng băng hay tinh chỉnh toàn phần. Trực giác nói ít dữ liệu thì đóng băng, nhiều dữ liệu thì tinh chỉnh, nhưng không cho biết ranh giới nằm ở đâu. Chương 6 đo ranh giới đó bằng một thí nghiệm có kiểm soát.
Tự kiểm tra
2 câu. Chọn đáp án để xem ngay lời giải thích.
1Vì sao dự đoán token tiếp theo dạy được nhiều kỹ năng như vậy?
Vì sao: Các kỹ năng là hệ quả của việc giảm mất mát trên một kho văn bản đủ lớn và đa dạng, không được dạy riêng (Mục 5.2).2Trường hợp nào tiền huấn luyện giúp được ít nhất?
Vì sao: Khi miền quá xa, các đặc trưng đã học không dùng lại được. Ngược lại, ít nhãn chính là tình huống tiền huấn luyện có ích nhất (Mục 5.4).
Đã trả lời 0/2